AI画像生成の3年間:
英語の呪文から中国語のひと言へ
最初は自分のパソコンに Stable Diffusion WebUI を構築し、その後、仕上がりの良さと手軽さを求めて Midjourney を契約しました。逢甲大学では AI 画像生成を2回教えたこともあります。当時は1枚の画像を生成するのに、英語のキーワード、ネガティブプロンプト、LoRA を長々と重ねる必要がありましたが、2026 年には平易な中国語のひと言で十分になりました。
最初は自分のパソコンで呪文を唱えていた
Stable Diffusion は 2022 年 8 月にオープンソースで公開され、AUTOMATIC1111 の Stable Diffusion WebUI も同じ月に登場しました。私が自分のパソコンにこの WebUI を構築して遊び始めたのは 2023 年 2 月末から 3 月初めごろです(ハードディスクで確認できる最も古い生成画像は 3 月 24 日のものです)。その後は ComfyUI も使いました。グラフィックカードの性能が足りないときは RunPod でクラウドのグラフィックカードを借り、2023 年 10 月に 25 ドル、2024 年 3 月にさらに 10 ドルをチャージしました。
当時、納得のいく画像を生成するためのプロンプトは、文章というより呪文に近いものでした。モデルが理解できるのは英語だけで、しかも短い語句が適していました。人物、動作、光、画風をキーワードごとにカンマでつなぎ、先頭にはさらに「品質を示す語」を重ねます。別にネガティブプロンプトも書き、余分な指、変形した体、ぼやけ、透かしなど、入れたくないものを一つずつ列挙しました。特定の画風や人物にしたければ、さらに LoRA を適用して重みを調整します。サンプラー、ステップ数、CFG も、それぞれ結果に影響しました。当時よく使われていた書き方は、だいたいこんな感じです(例示):
<code>ポジティブ:masterpiece, best quality, 1girl, sitting by the window, morning light,
      backlighting, soft focus, pajamas, <lora:あるスタイル:0.7>
ネガティブ:worst quality, low quality, lowres, bad anatomy, bad hands,
      extra fingers, deformed, blurry, watermark
Steps: 30, Sampler: DPM++ 2M Karras, CFG scale: 7, Size: 512x512
</code>
画像のサイズも小さかったです。基本は 512×512、せいぜい 768×512。もっと大きな画像が欲しければ、まず小さく生成してから、別のモデルで拡大する必要がありました。それだけ設定をそろえても、同じ設定で何度も生成し直して、ようやく指の本数が合い、顔も崩れていない1枚を選べることがよくありました。ComfyUI はこうした要素をすべてノード図として並べます。制御できることは増えますが、覚えて調整することも増えます。
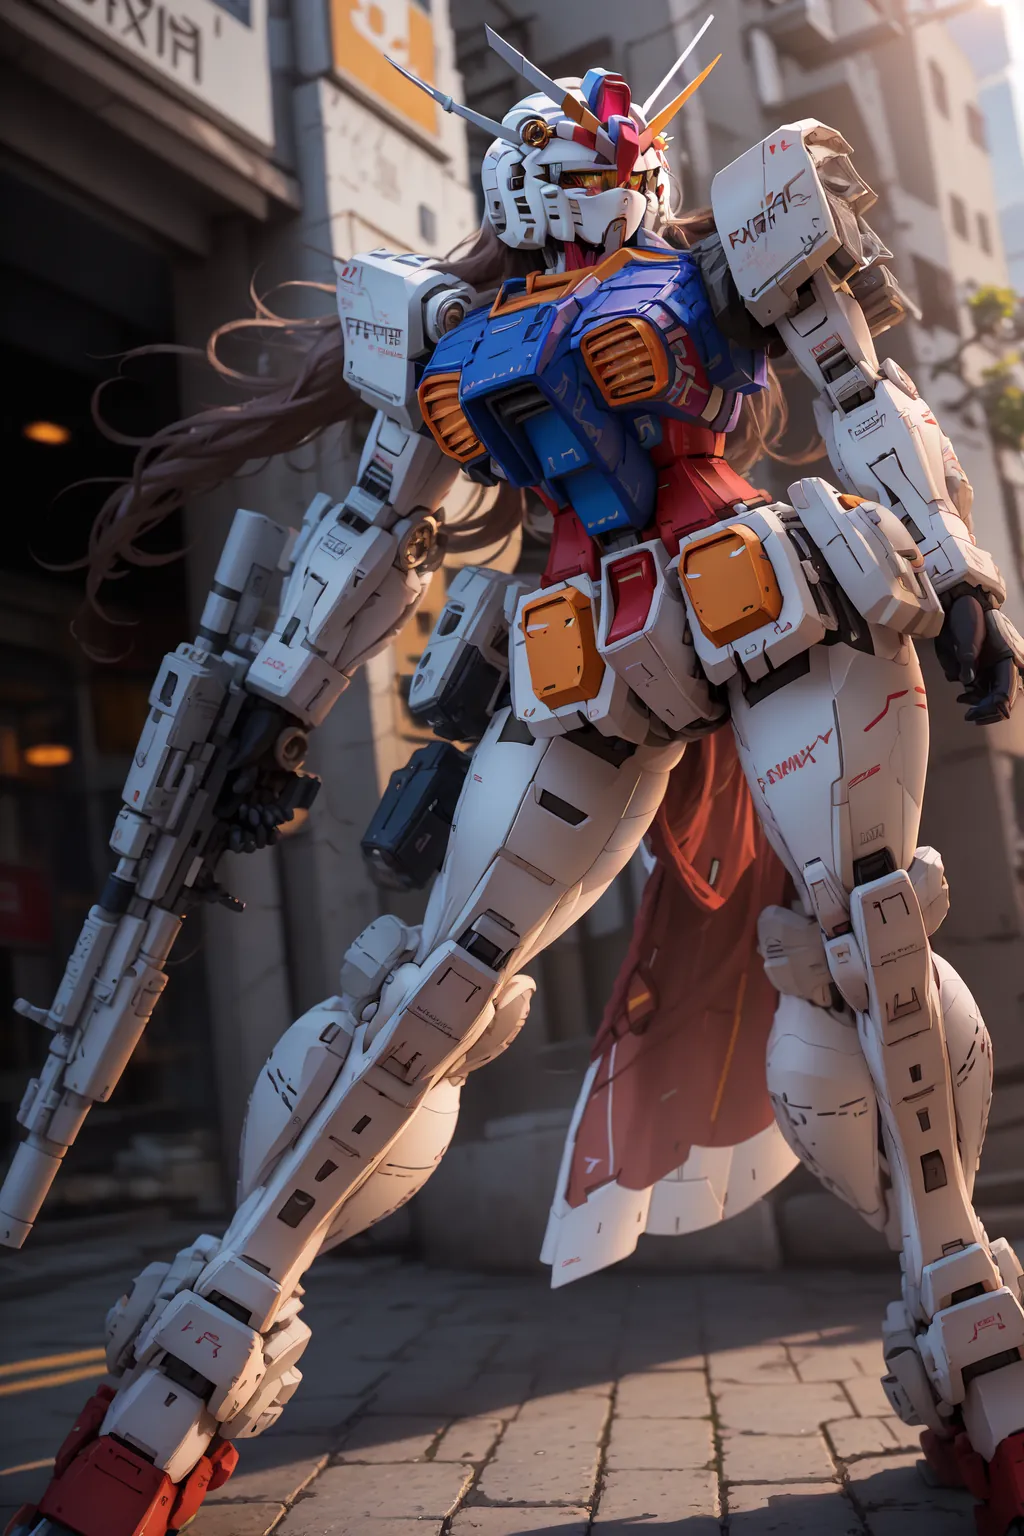
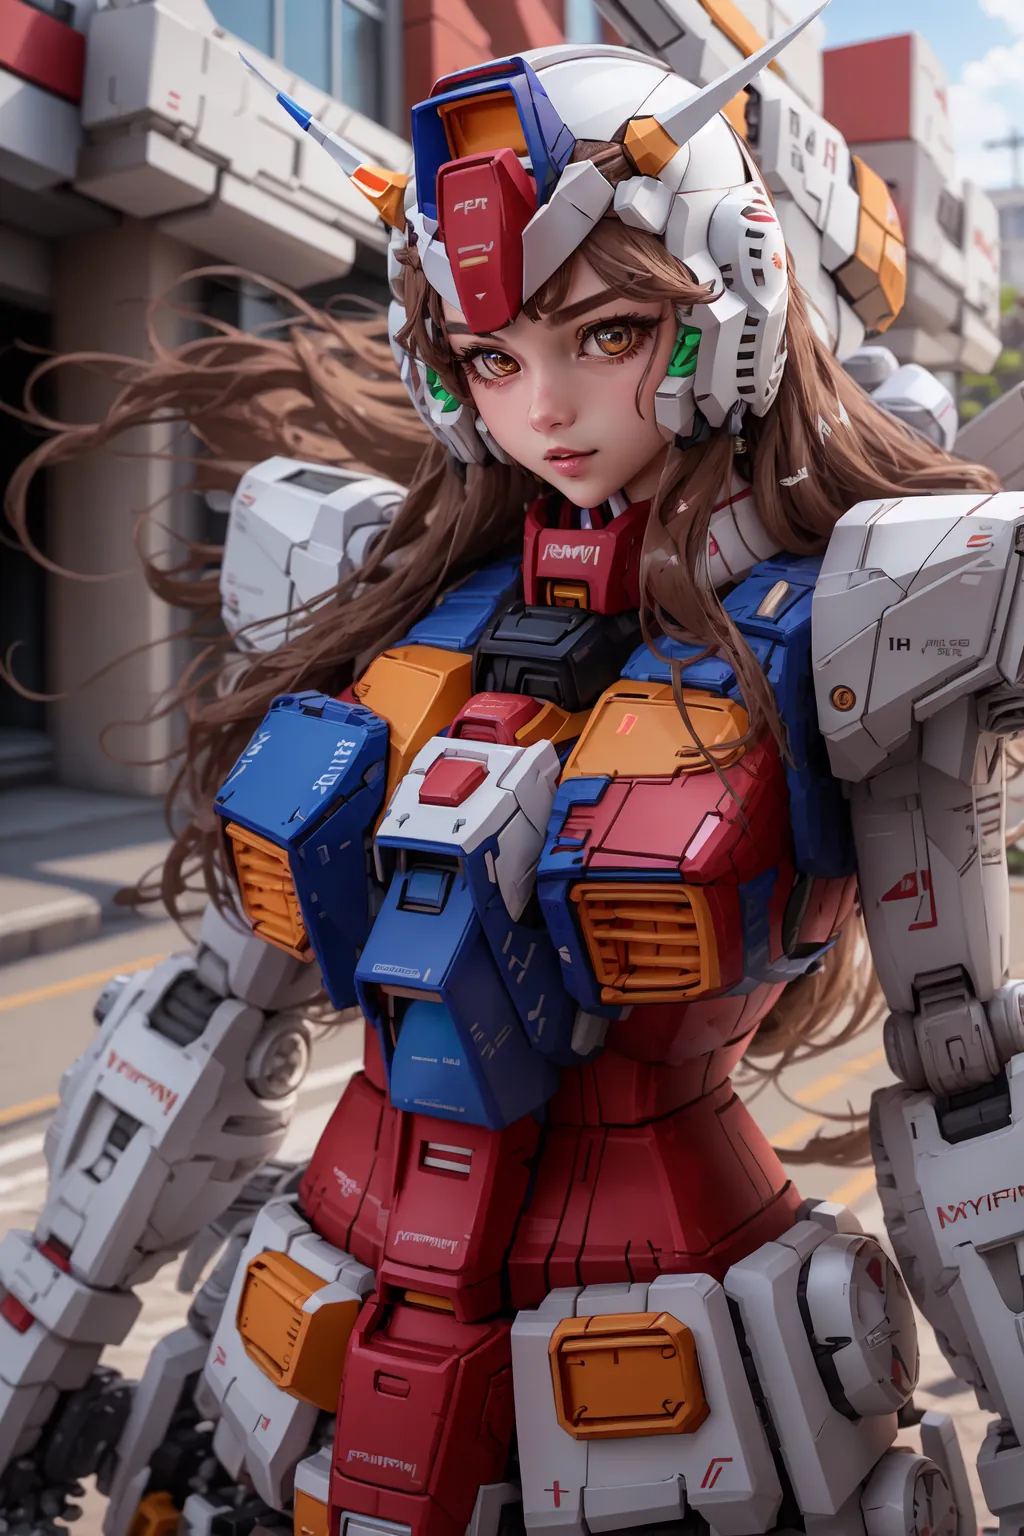
下の2枚は 2023 年 3 月 29 日に自分のパソコンで生成したもので、まさにこうした呪文から生まれました。ポジティブプロンプトには 33 個のキーワード、LoRA は 3 個、ネガティブプロンプトは 64 項目。まず 512×768 で生成し、SwinIR で2倍の 1024×1536 に拡大しました。前後合わせて 50+25 ステップかかりました。
ローカルモデルは、むしろ NSFW 画像のテストによく使っていました。この種の画像はクラウドサービスでは生成できず、自分のマシンで動かすしかありません。
2023:仕上がりの良さと手軽さを求めて Midjourney を契約
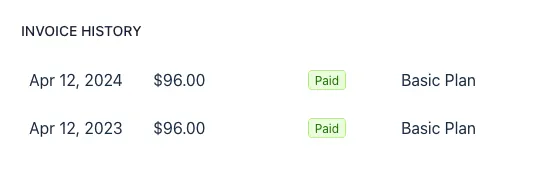
2023 年 2 月に ChatGPT Plus(月額 20 ドル)を契約し、4 月には Midjourney の Basic プランを年払いで契約しました。年間 96 ドルで、2期続けました。契約した理由は単純です。自分のパソコンで呪文を唱えてパラメータを調整するのに比べ、Midjourney の画像は洗練されて美しく、安定して生成でき、使うのも楽だったからです。
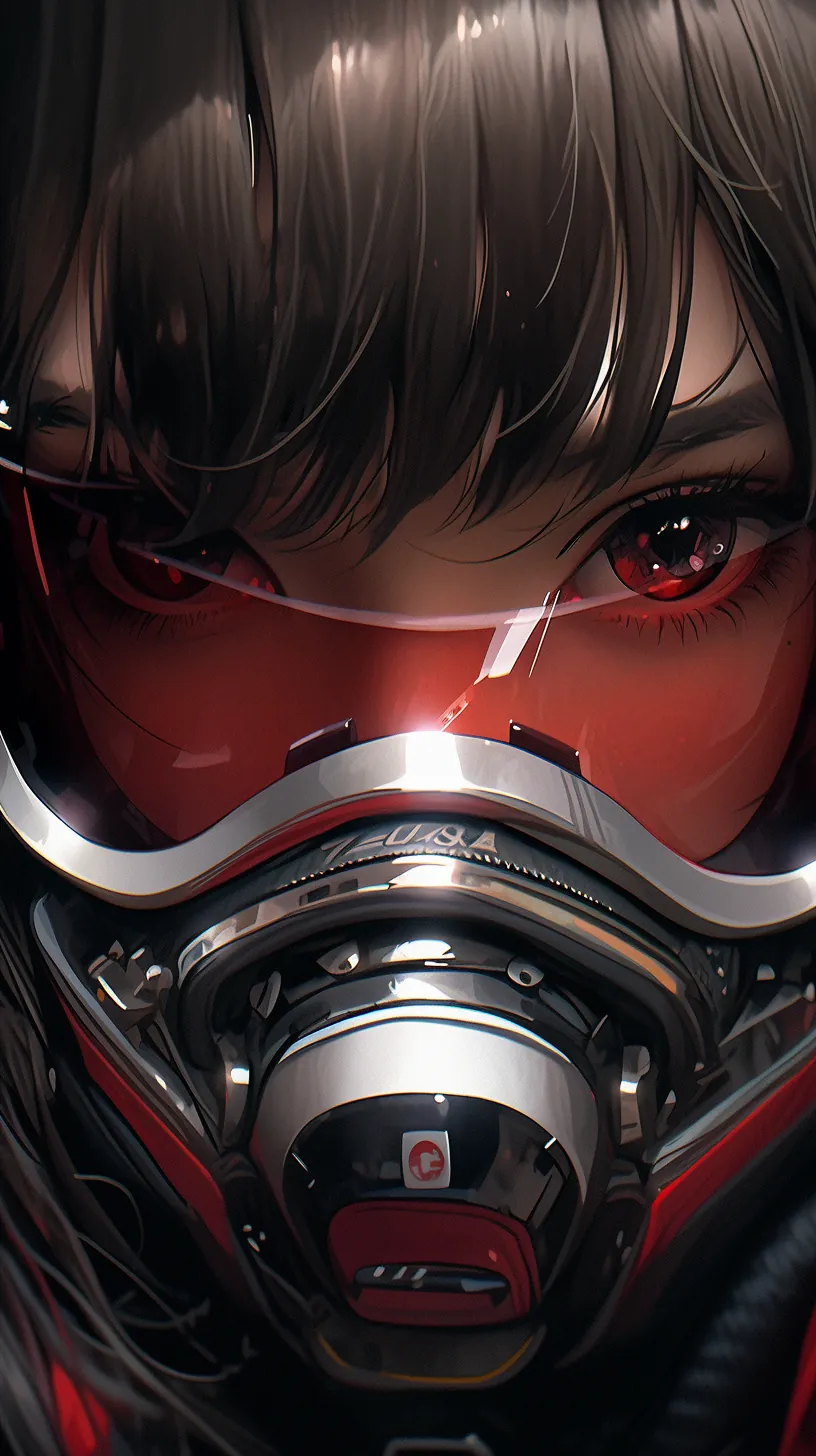
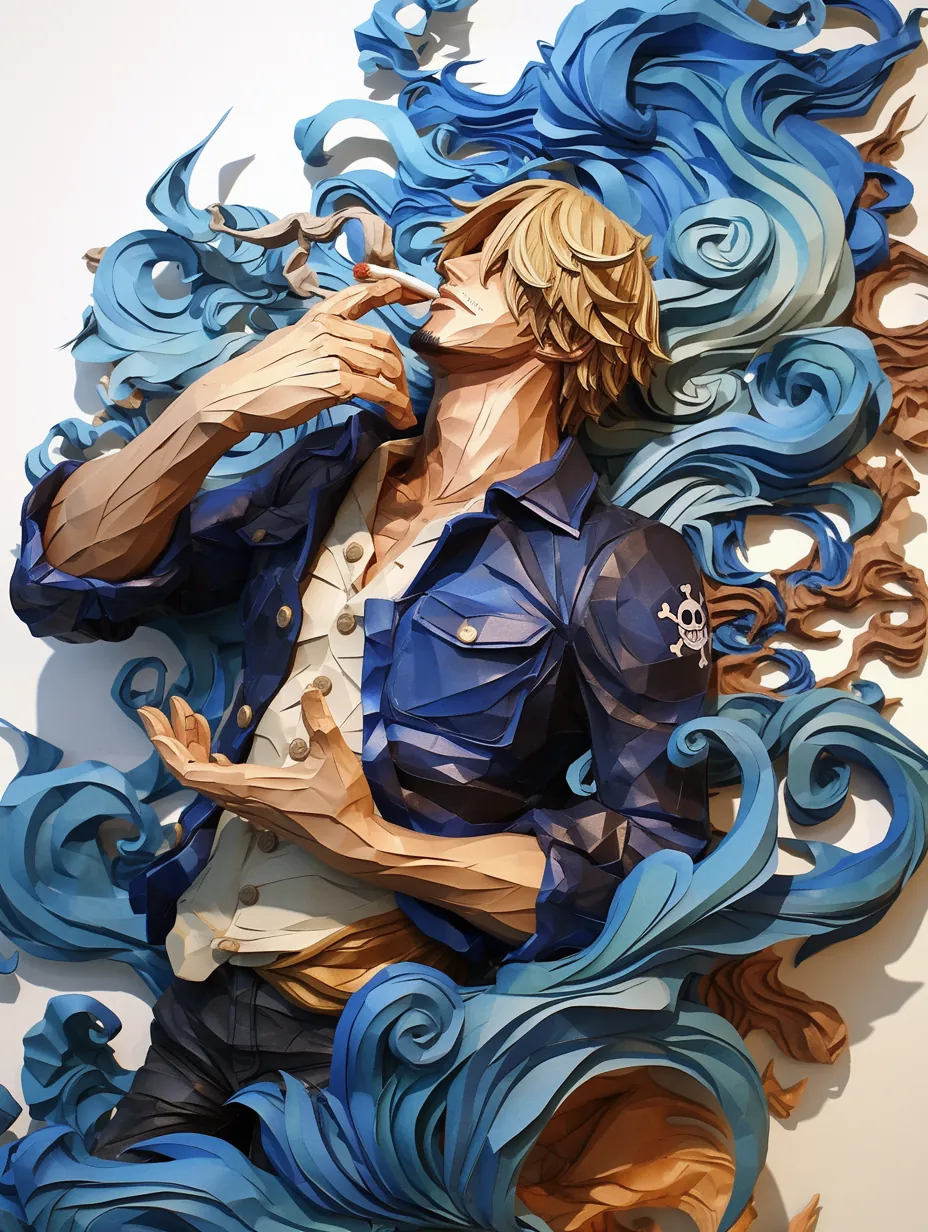
当時の Midjourney では、まだ Discord で /imagine コマンドを入力していました。一度に4枚出てきて、気に入ったものを選んで拡大したり、バリエーションを作ったりします。下の2枚は当時生成したものです:
逢甲大学で AI 画像生成を教える
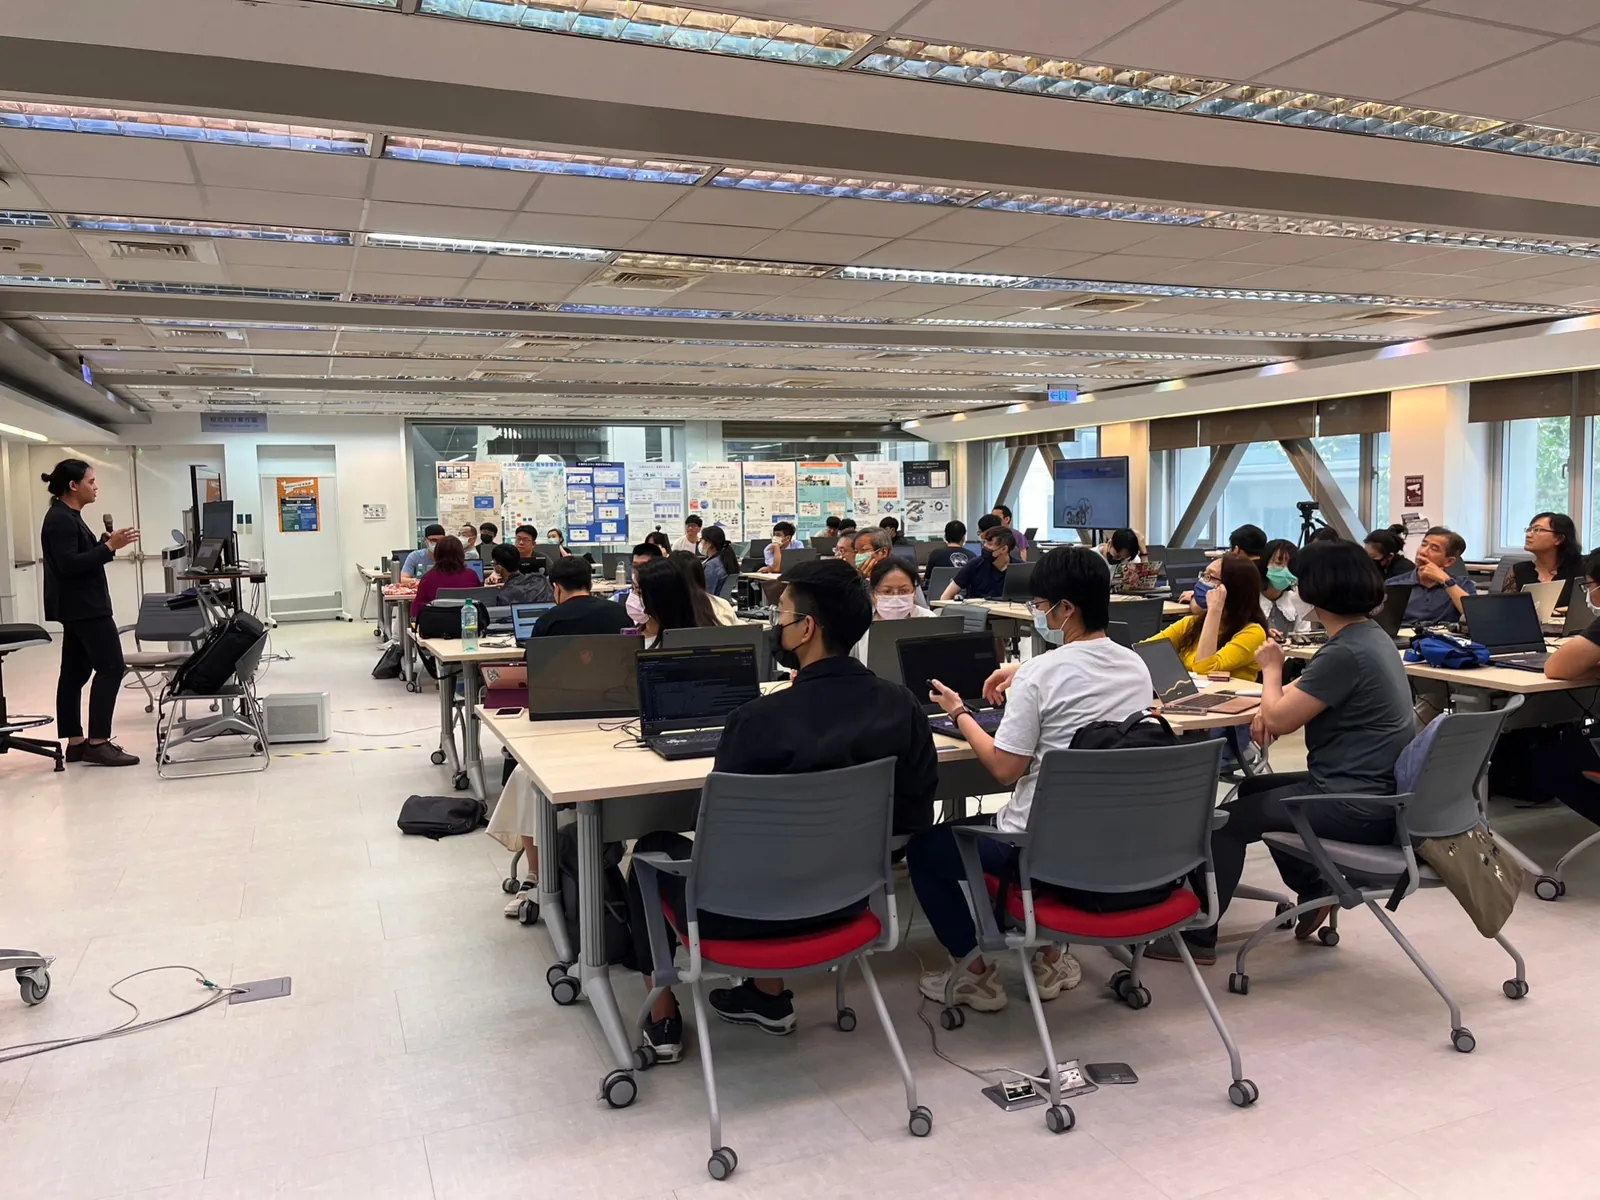
この時期、逢甲大学で AI 画像生成の授業を2回開きました。どちらも Stable Diffusion を教えたものです:
- 2023 年 4 月、創能学院の AI 画像生成ワークショップ。5時間の授業で、参加者は約 80 人。大学全体の 31 学科・研究科と 3 つの事務部門から集まりました(プレスリリース・スライド)
- 2024 年 3 月、中国文学科の「Stable Diffusion 実習」。全3回、計6時間で、プロンプト、テキストからの画像生成、画像からの画像生成から始め、LoRA のトレーニングと ControlNet まで扱いました(教材 I・II・III)
2026:中国語のひと言で十分に
2026 年 9 月、自宅の RTX 3090 に Qwen-Image 2.1 と Z-Image Turbo をインストールし、自分用のウェブ画面も作りました。ひと言入力してモデルを選び、生成ボタンを押すだけで、スマートフォンからも使えます。戻ってきて最も強く感じたのは「画像を生成できる」ことではなく、流れ全体がとてもスムーズになったことです。中国語でひと言入力して押すと、欲しかった画像がそのまま出てきます。
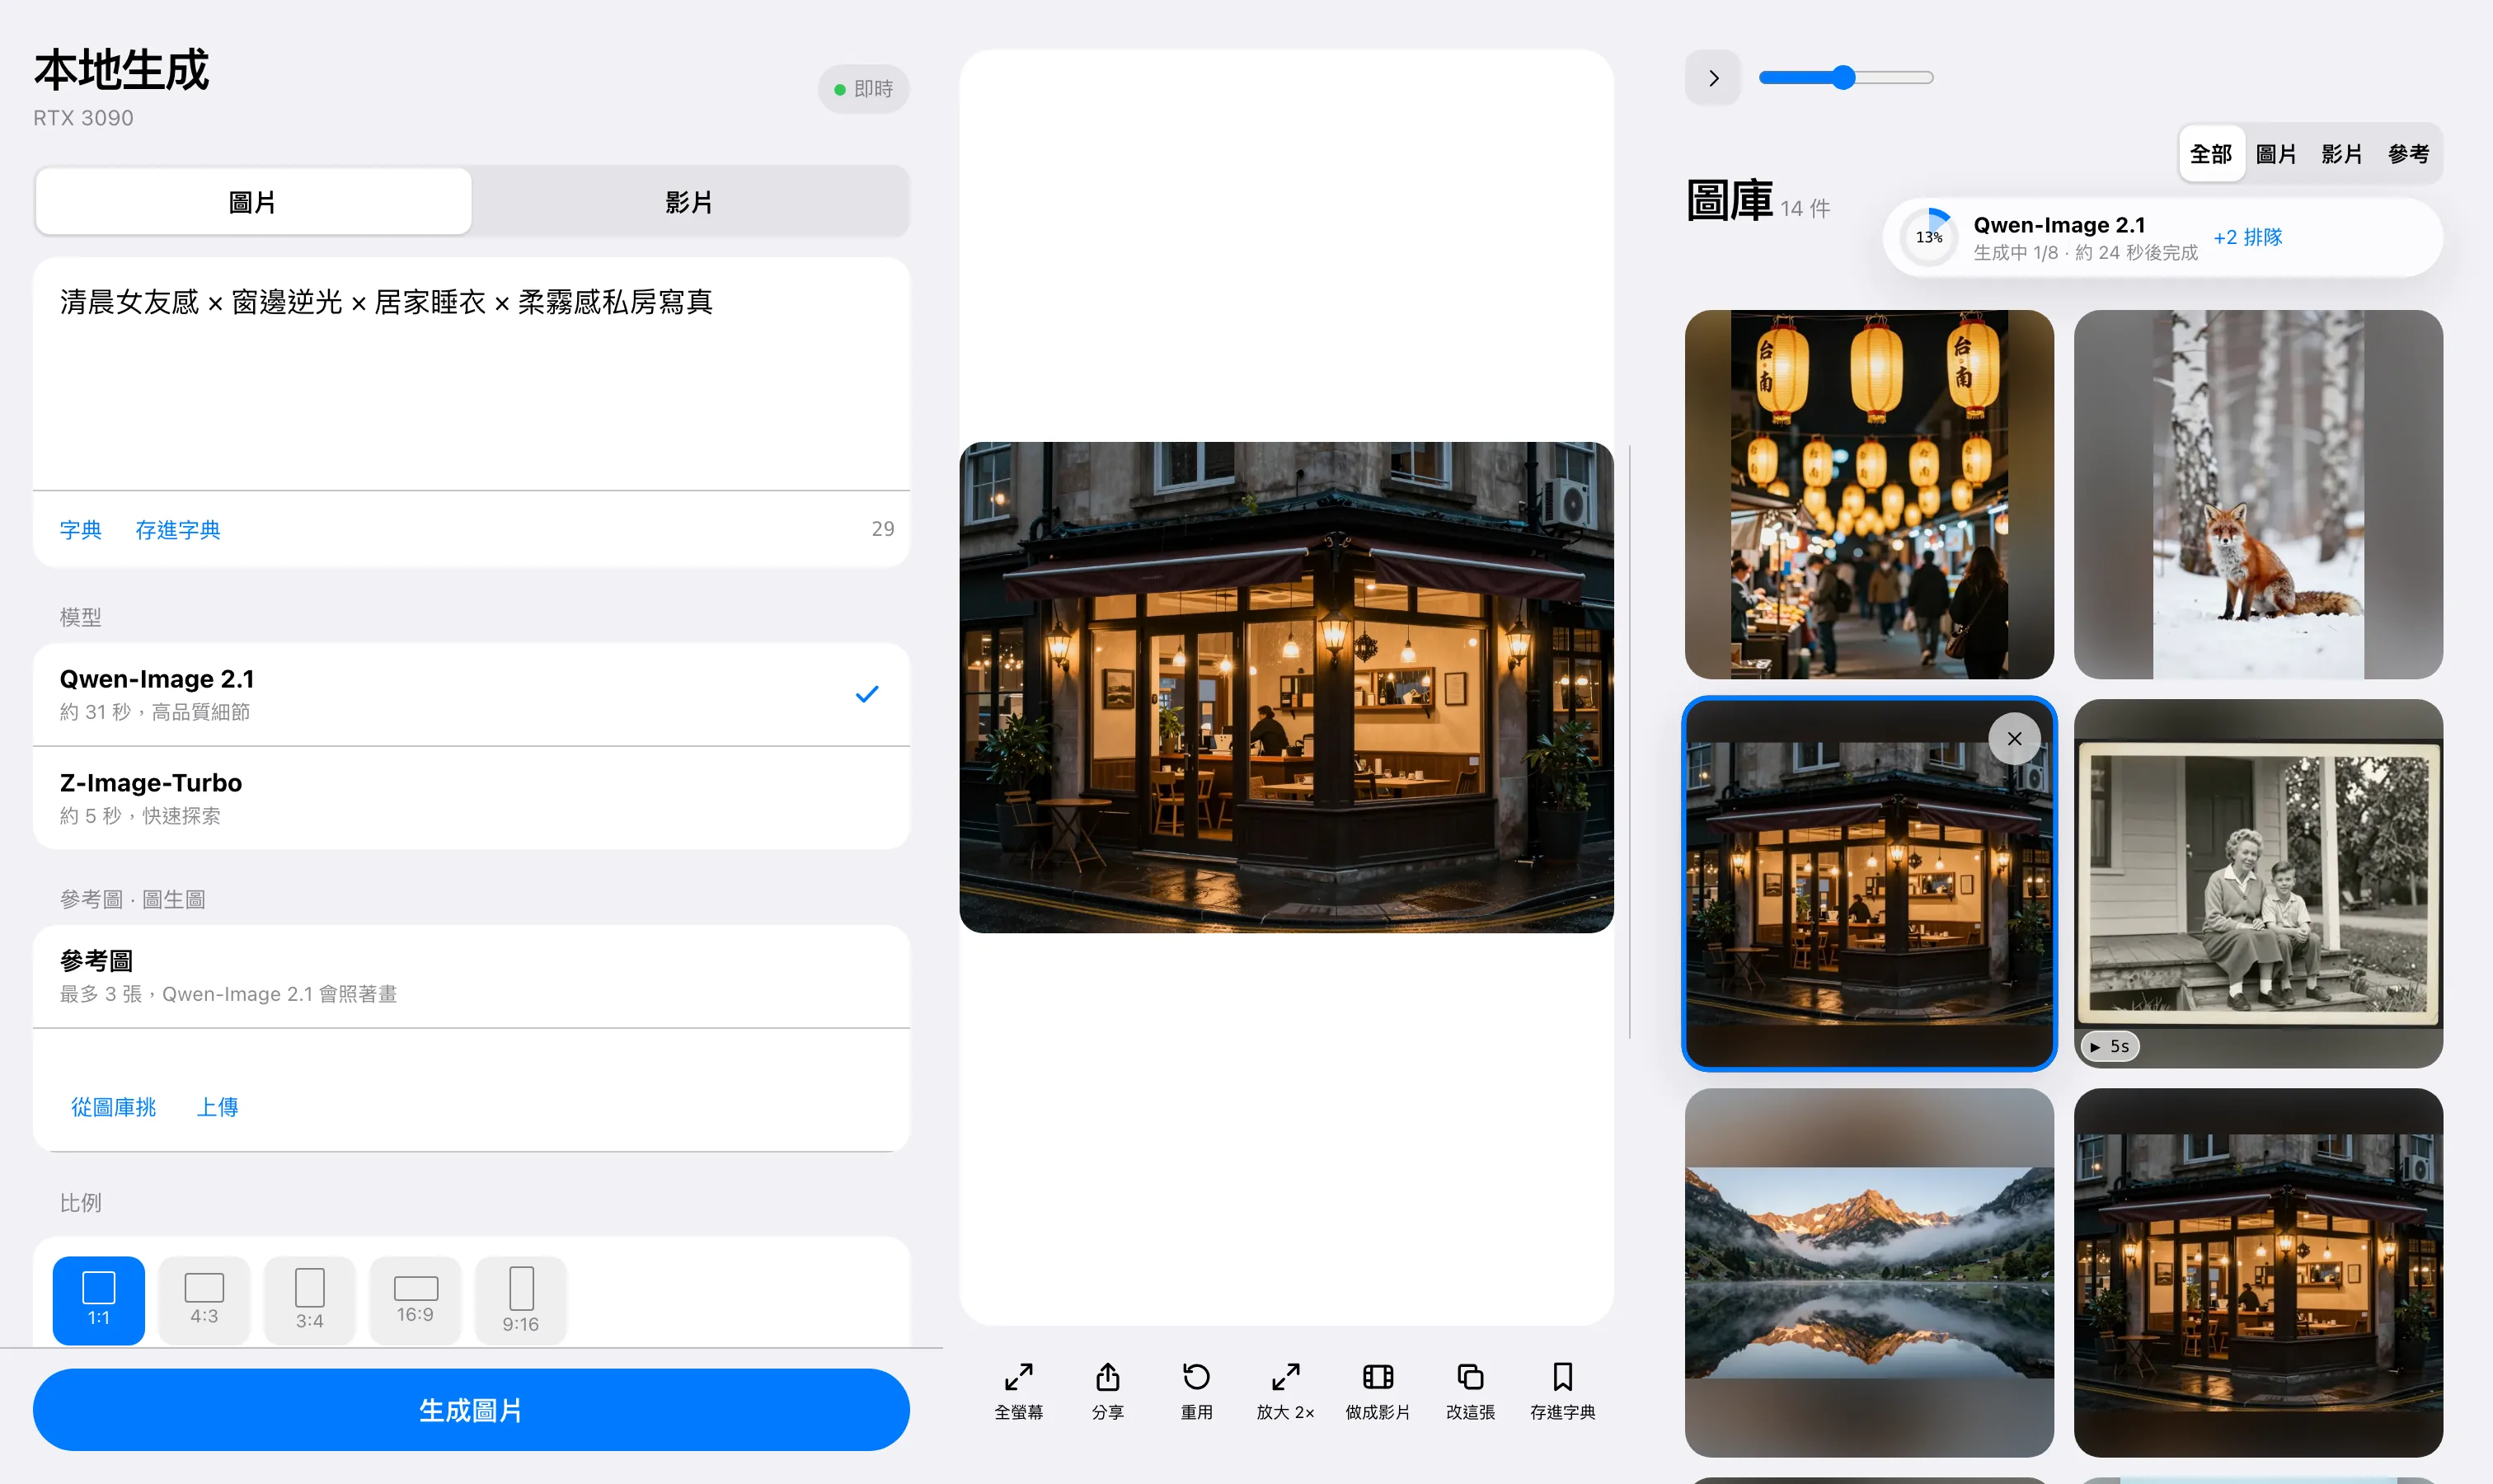
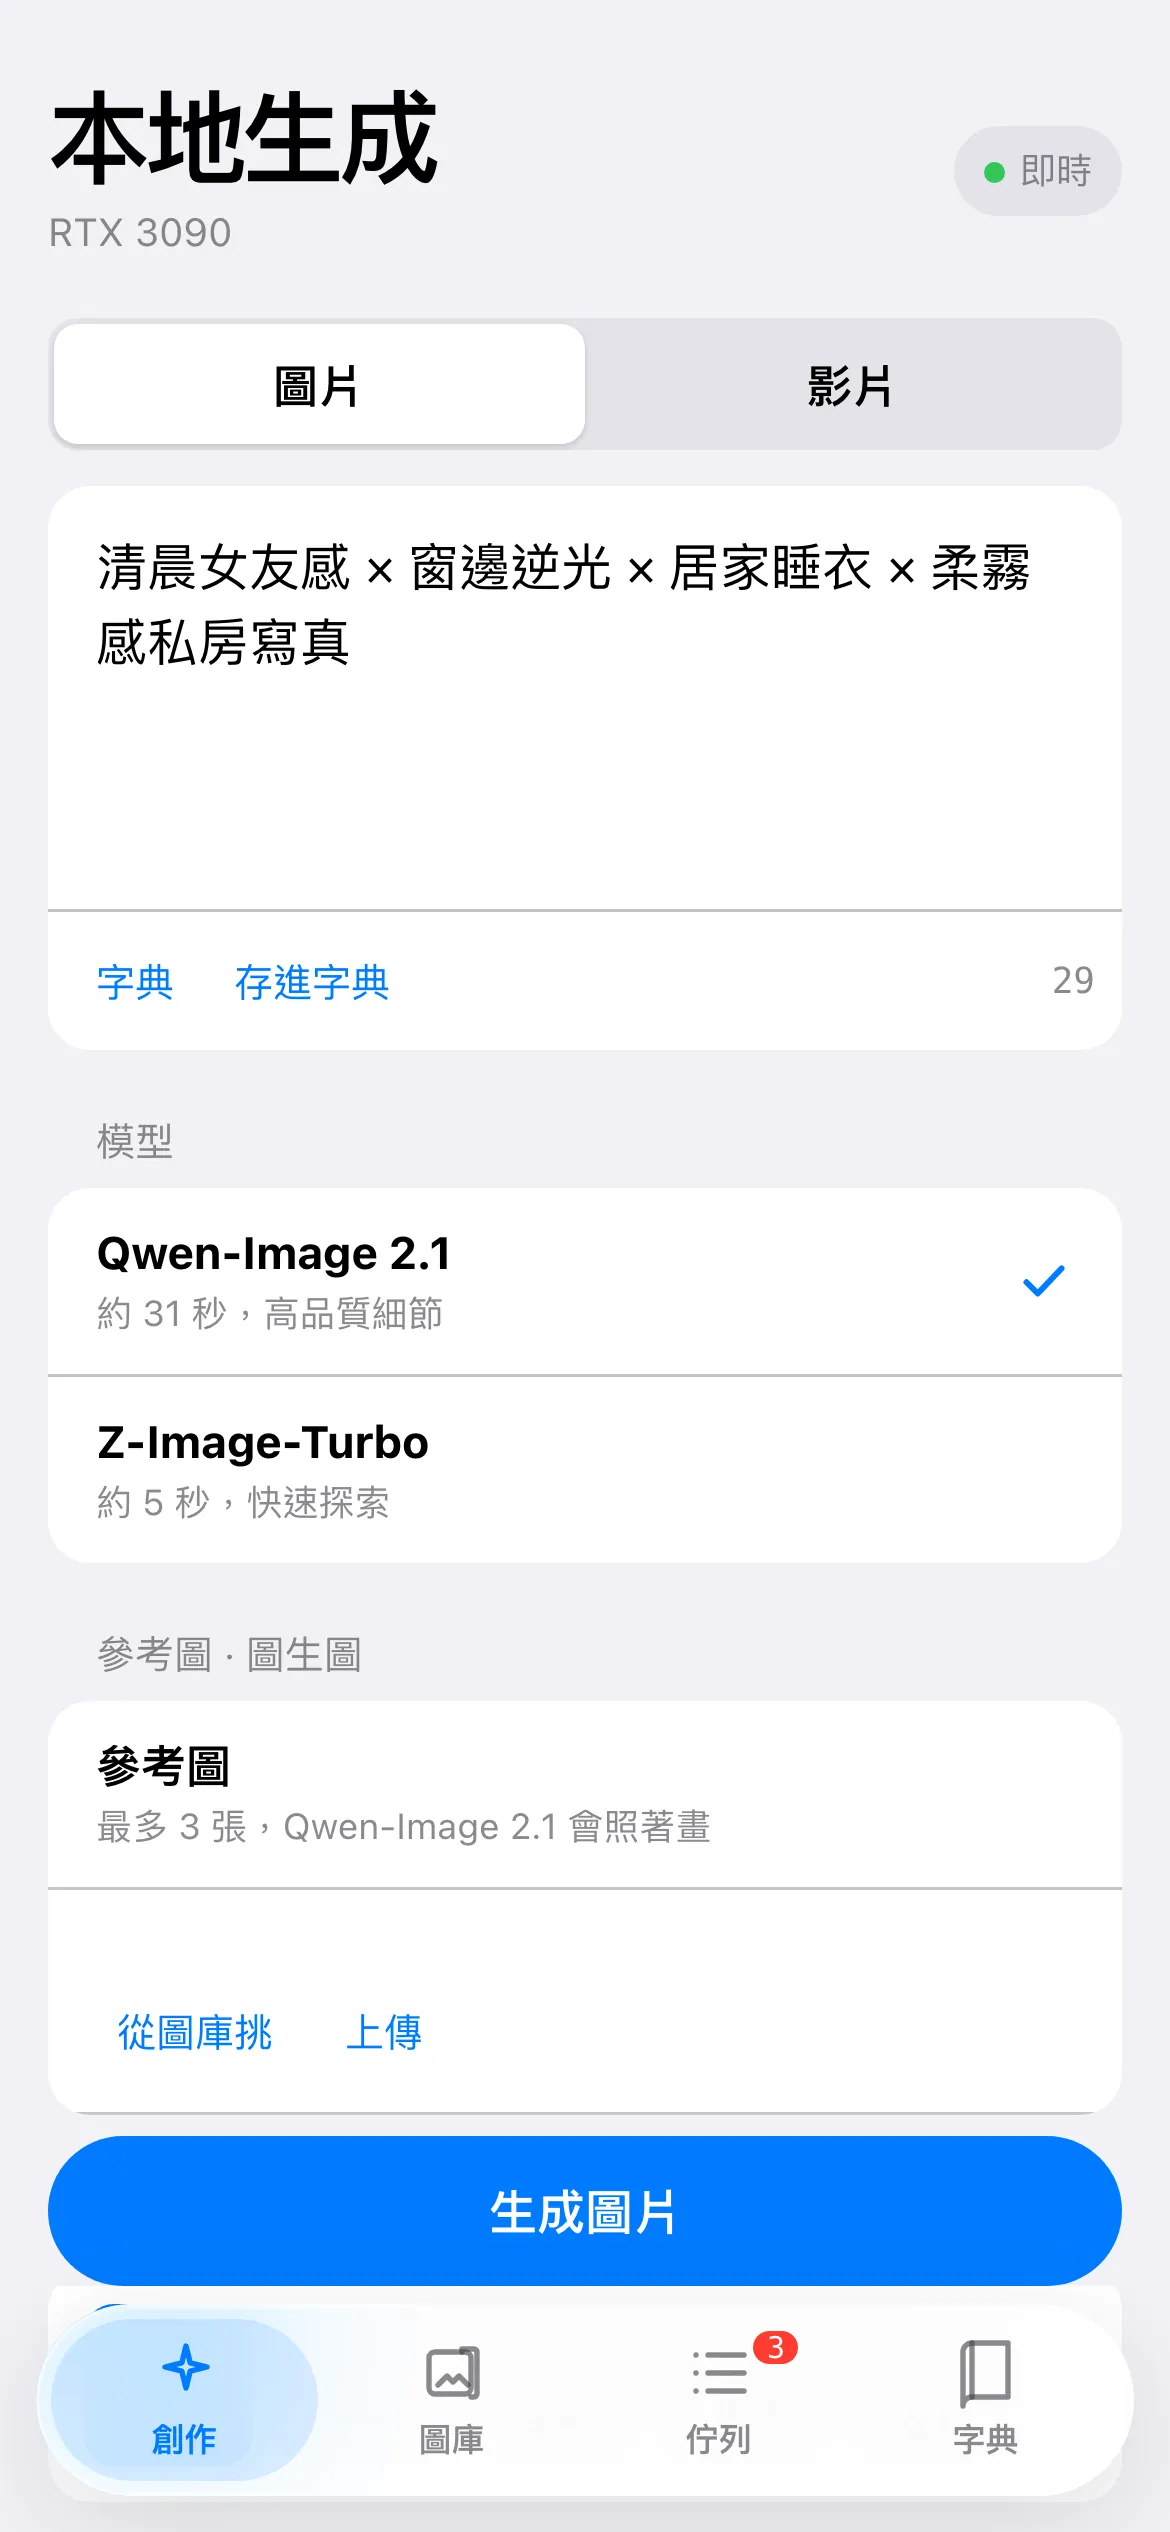
スクリーンショットの入力欄にある1行が、下の画像に実際に使ったプロンプトです。この画像は Qwen-Image 2.1 で生成しました。入力したプロンプトはたった1行です:
早朝の彼女感 × 窓辺の逆光 × 家で着るパジャマ × 柔らかな霧がかったプライベートポートレート
いくつかの中国語のフレーズだけです。品質を示す語も、ネガティブプロンプトも、LoRA も使わず、パラメータはすべてデフォルトのまま。直接 768×1344 で出力でき、別途拡大する必要もありません。40 ステップで、45.7 秒でした。
Z-Image Turbo は別の方向です。同じ書き方でパジャマをレースの下着に変えると、わずか 8 ステップ、1枚 4.2 秒で、Qwen の10倍速く生成できました。左が Qwen、右が Z-Image です:
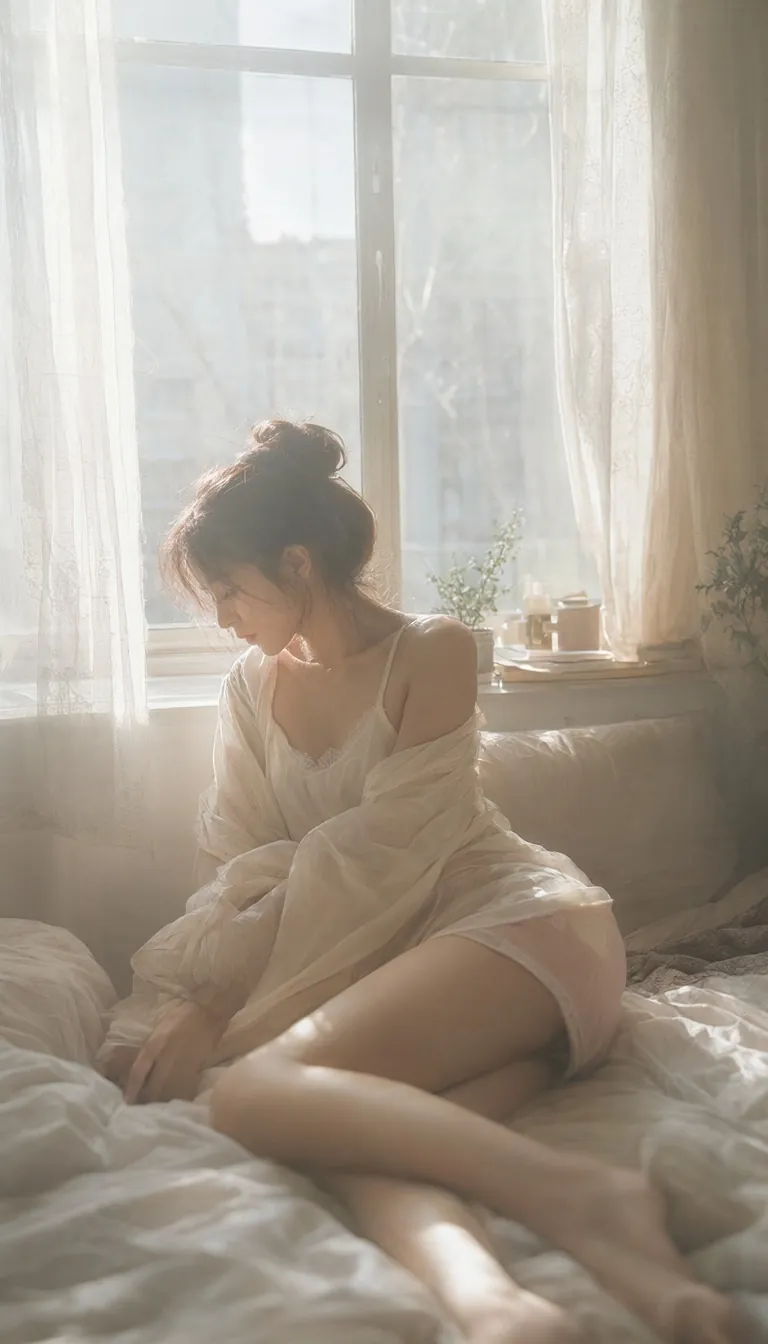
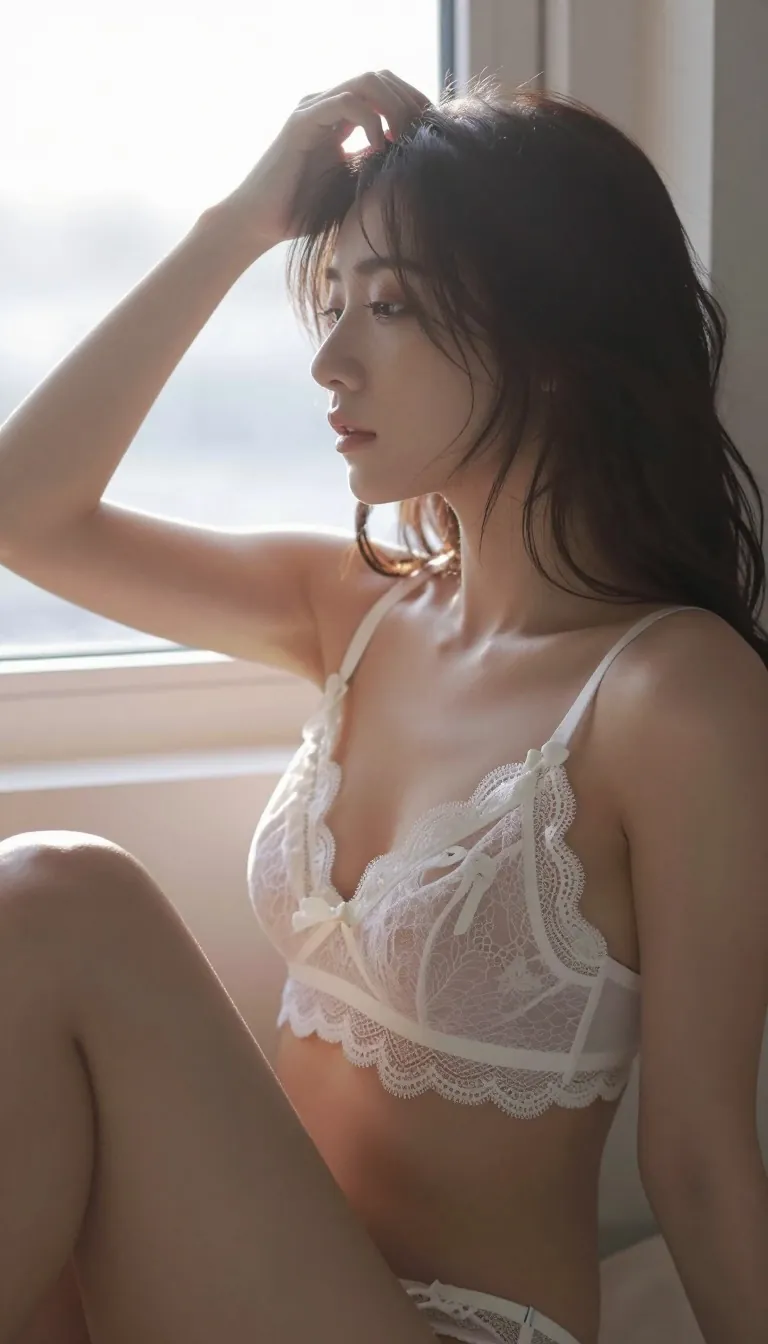
プロンプトに書いたものがすべて画面に現れています。早朝の窓辺、逆光、柔らかな霧がかった質感、家で着るパジャマ。以前いちばん心配だった指や体の比率も、この2枚では問題ありませんでした。
この3年間で変わったのは速度やサイズだけではありません。モデルへの伝え方が、英語のキーワードの羅列から、中国語のひと言になりました。
画像も動くようになりました
同じ書き方は動画にも使えます。生成した画像を最初のフレームにして、中国語のひと言でどう動かすかを伝えれば、同じグラフィックカードで5秒の動画を生成できます。クラウドの Seedance はさらに驚くような仕上がりですが、費用もずっと高くなります。こうした話と、最近また私を驚かせた、AI が最初から最後まで動画を1本作り上げる話は、次の記事〈AI で動画を作る:映像をどう動かし、いくらかかるか〉。
昔の呪文を平易なひと言に直す
この3年間で変わったのは、モデルへの伝え方です。英語のキーワードの羅列から、中国語のひと言になりました。
昔のプロンプトがまだ手元にあるなら、自分の AI に貼り付けて、この記事の比較に沿って書き直してもらえます。
関連記事
| リソース | 重要な理由 |
|---|---|
| AI で動画を作る:映像をどう動かし、いくらかかるか | 次の記事:同じひと言の書き方を動画に使う方法と、AI に動画を丸ごと作らせる方法、そのコストを紹介します。 |
| 逢甲大学 Stable Diffusion 実習教材 I | 2024 年の授業で使った教材です。プロンプト、テキストからの画像生成、画像からの画像生成から始め、当時の呪文の書き方も見られます。 |
| 教材 II | 同じ授業の第2回です。 |
| 教材 III | 第3回では LoRA のトレーニングと ControlNet まで扱います。 |