絶妙なダンスが絶望的なダンスに、
AIで救えるのでしょうか?
4段階で試した結果、AIは音楽に合わせて踊り、重要なポーズをつなぎ、一つのダンスを別のキャラクターに踊らせることはできました。しかし、モーションキャプチャの不自然な動きを直すことは、今回はまだできませんでした。
きっかけ:アニメと手描きを並べて比較したShort
実験期間:2026年10月6日から9日。使用したモデル:Grok Imagine、MiniMax H3、Seedance 2.5、Wan Animate 2、SCAIL-2、SAM 3D Body、SeedVR2。最終ラウンドのキャラクター画像はGPTで生成しました。H3、Wan、SCAIL-2は1枚のRTX 3090で動かし、GrokとSeedanceはクラウドを使いました。これらのモデルは更新が速いため、以下の結論はこの数日間のバージョンについてのものです。各動画には「どのモデルを使い、どう作ったか」を明記しました。
『ワンダンス』(Wandance、台湾での訳題は『絕妙舞步』)は、高校生のストリートダンスを描いた漫画で、2025年秋にアニメ化されました。アニメのダンスシーンは3Dモーションキャプチャ(実際に人が踊り、その動きをコンピューターで記録して3Dキャラクターに適用する方法)で制作されています。
私がこれを知ったのは、YouTube Shortの一本の動画〈『絕妙舞步』が『絕望舞步』に〉(Hinata)でした。動画はアニメのダンスと原作者の珈琲自身が描いた手描きアニメを並べて比較しており、その差は一目で分かります。

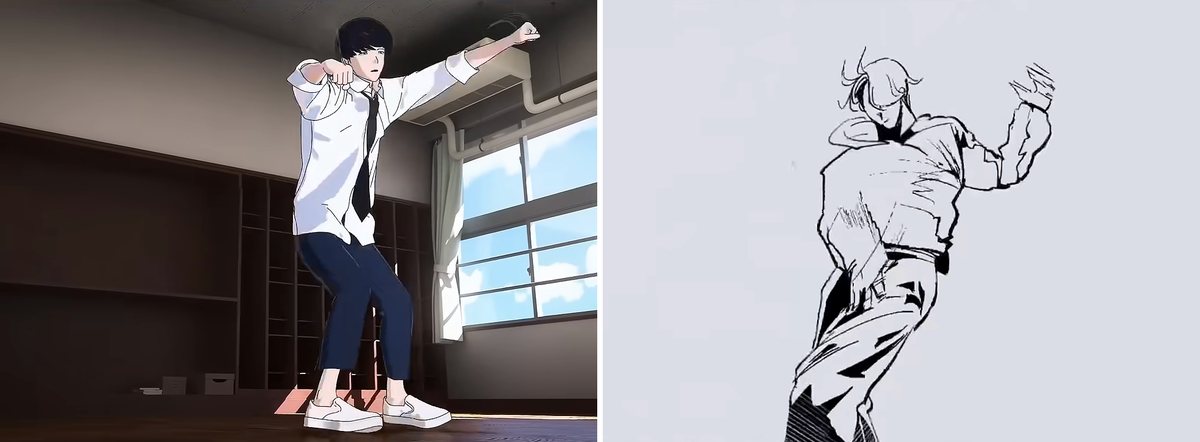
アニメのレビューでも同じ問題が指摘されています。CBRは、同じダンスの中で手描きと3Dが行き来し、映像の滑らかさが途切れると指摘しました(CBR、2025年10月)。AniTrendzはさらに直接的に、キャラクターの顔はほとんど固まり、目に輝きがなく、口は人形に描かれた一本線のようだと書いています(AniTrendz、2026年1月)。
見終えて、今のAIにどこまで手伝えるのか知りたくなりました。問題を4段階に分け、後の段階ほど具体的な情報をAIに渡しました。
- 音楽とダンスのステップ名だけで、AIは自分でダンスを生成できるのでしょうか?
- 漫画のコマをキーフレームとして渡すと、AIは動きをつなげられるのでしょうか?
- 作者の手描きアニメを渡すと、AIはカラー漫画風のキャラクターに同じように踊らせられるのでしょうか?
- アニメそのものを渡すと、AIは不自然なモーションキャプチャを修正できるのでしょうか?
記事中のキャラクター画像は、公式設定と漫画のカラー表紙を参考に私がAIに描かせたもので、ファンアートとしてのデザインです。公式素材ではありません。
始める前に、キャラクターを取り違えるという失敗もしました。Shortに映っていたアニメのシーンは主人公の小谷花木ですが、作者が手描きで踊らせたのは別のキャラクター、厳島伊折です。2本が並んでいたので、作者が描いたのも花木だと思い込んでいました。最初の3段階を一通り試してから服装もフロアでの動きも合わないと気づき、伊折の公式設定に替えてようやく一致しました。そのため後の各段階には花木版と伊折版の両方があり、比較動画の一部では「花木が伊折のダンスを踊って」います。
4段階を通じて十数通りの方法を試しました。結論を先に言うと、どの段階でもAIは何かを作れましたが、私が望んだ形になった段階は一つもありませんでした。
まず結論:4段階を一つの表で
4段階の違いは、AIに渡す情報の量です。表には各段階で最も良かった方法と行き詰まった点をまとめ、続く各節で一段階ずつ説明します。最後の行は追加実験で、原作に従わず自分で振り付けました。
| 段階 | AIに渡すもの | 最も良かった方法 | できたこと | 行き詰まった点 |
|---|---|---|---|---|
| 1 | 音楽+ステップ名 | H3+拍に合わせて書いたステップ表+元動画の音楽を一緒に入力 | 音楽を聴きながら踊り、表にある大きな動きを再現 | 踊ったのは「一つのダンス」であって、原作のあのダンスではない |
| 2 | 漫画のコマ割り | コマのカメラアングルに合わせて7枚のキーフレームを描き直し、H3がワンカットで間を補間 | すべてのポーズを通り、カメラも追って動く | キーフレームが多いほどポーズを取るだけに見える。コマ間の時間配分は自分で決める必要がある |
| 3 | 作者の手描きアニメ | 線画を3D人形に変換 → SCAIL-2 → Wanで描き直す | ポーズが作者の絵と一致 | 作者の2コマ打ちの緩急が失われる |
| 4 | アニメそのもの | アニメを3D人形に変換 → Wan → リズムを修正 | キャラクターを替え、動きの止めが明確に | モーションキャプチャの動きの軌道は直らず、カメラアングルもずれた |
| 追加実験 | 音楽+自作の絵コンテ+冒頭画像 | H3に音楽を聴かせて生成し、2カットでは冒頭画像を最初のフレームに変更 | 絵コンテに沿ってカメラアングルを変え、音楽を聴きながら踊る | 参照画像が映像に描き込まれる。空白部分に余計な物が現れる |
表全体を見ると、渡す情報が具体的なほどAIは正確に模倣できます。ただ、第4段階で必要だったのは「模倣」ではなく「修正」で、今回はリズムの修正までしか試せませんでした。
第1段階:音楽とステップ名だけを渡す
テキストと音楽だけを渡しても、AIは音楽に合わせてそれらしいダンスを踊ります。しかし、それはAIが想像したダンスで、漫画に描かれたあのダンスではありません。
漫画にステップ名は書かれておらず、あるのはダンスのジャンル、曲名、モノローグだけです。花木のシーンには「HIPHOP、2Pac〈Changes〉、モノローグ『音が聴こえる』」を入力に使いました。伊折のシーンにはHOUSE/BREAKとあり、モノローグは「頭をビートに乗せる」「細かな音はすべて足元で拾う」「脱力感と余裕」という内容です。つまり、この段階での「ステップ名」は、私がモノローグをもとに考えたものです。
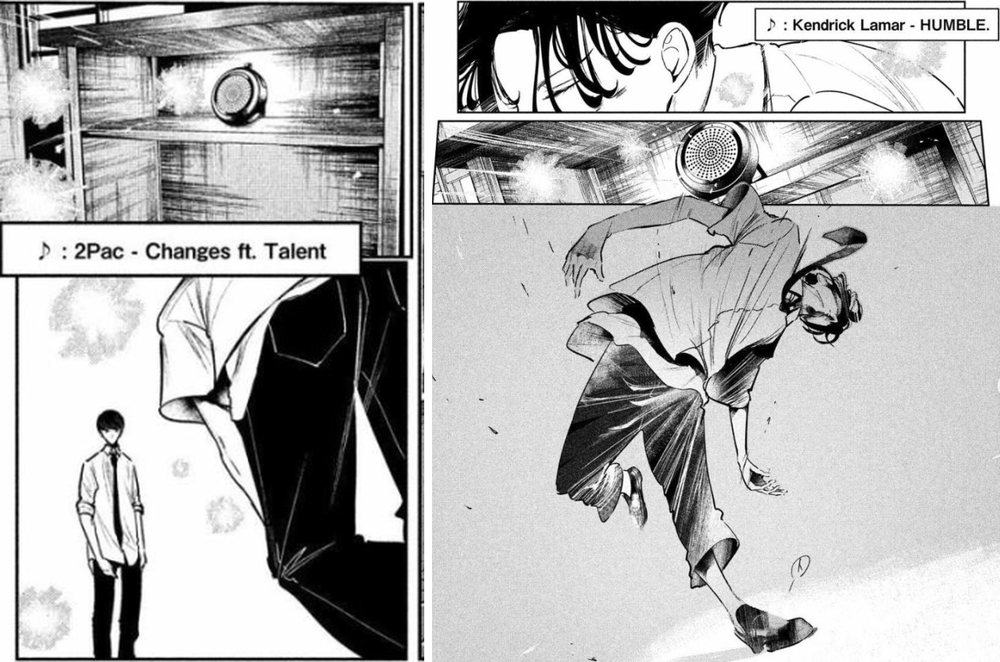
2通りの方法を試しました。
- Grok Imagineにテキストだけを渡す:キャラクターとグリーンバックは安定していましたが、動きは一般的なリズムに合わせたステップで、漫画にあるような低い重心の大きな動きはありませんでした
- MiniMax H3+ステップ表+元動画の音楽:モノローグを秒単位で並べたステップ表に書き換え(名称は私が付けたもので、すべて推測です)、作者の元動画の音楽も入力としてモデルに渡しました
H3の結果は動きがずっと大きくなりました。「最も低い位置の身長÷直立時の身長」でしゃがむ深さを測ると、Grok版は0.83、H3版は0.57まで下がりました。足を広く開いて体重を乗せる動き、膝上げ、横蹴り、最後の深いランジも表どおりです。伊折の3つのseedでは、いずれも倒立freezeができました。
元動画の音楽もH3に渡したことが、この段階で最も手応えのあった点です。H3の生成動画には音声トラックが付いてきます。測定するとテンポは129.2 BPMで元の曲と同じで、2つの音声トラックの音量変化も一致し、時間のずれもありませんでした。これはモデルが確かにこの音楽を読み込んだことを示しています。ただ、ステップが拍に合っていたかは別途測定していません。
名前と音楽だけでも、AIは音楽を聴き、指定した大きな動きを再現できます。しかし原作のダンスがどんなものかを知る手段はありません。
第2段階:漫画のコマを渡し、AIに動きをつなげさせる
漫画のコマをキーフレームに描き起こし、動画モデルに間を補間させると、AIは動きをつなげられます。ただしキーフレームを増やすほどポーズを取るだけに見え、コマ間の時間配分も自分で決めなければなりません。
まずGrokで各コマをカラー漫画風のキャラクター画像に描き直し、H3にこれらのポーズを順に通らせました。この段階でも失敗がありました。漫画のコマをそのまま参照画像にすると、Grokは手に隠れた頭を2つ目の頭として描き、9枚中3枚が失敗しました。ポーズをテキストだけで説明するよう変えると、その後の数十枚では2つ目の頭は現れませんでした。
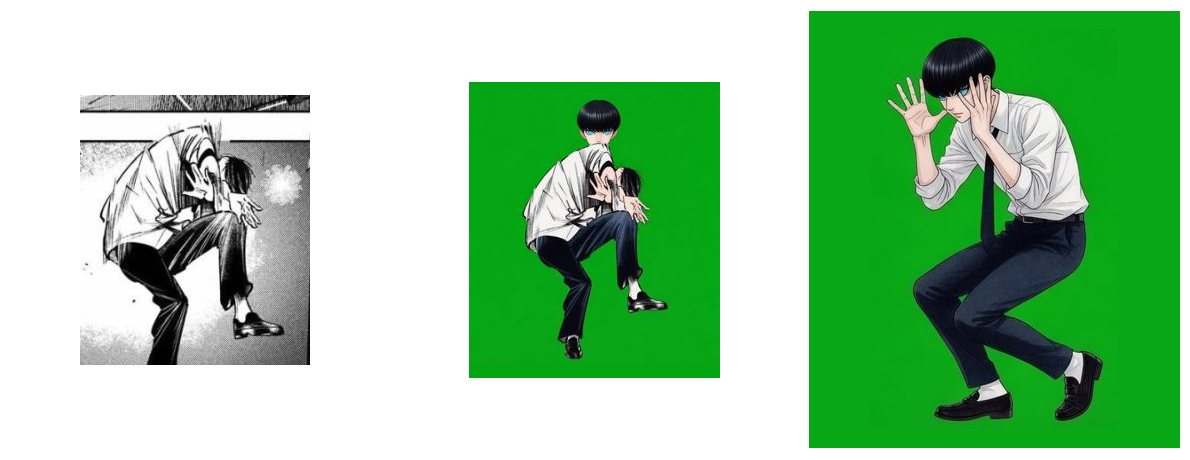
最初の版ではキーフレームを密に配置しました。9コマの間にそれぞれ1枚ずつつなぎのポーズを入れ、キーフレームでは拍に合わせて3フレーム止めました。そのおかげで背景は安定しましたが、一枚ずつポーズを切り替えているように見え、動きが途切れ途切れでした。
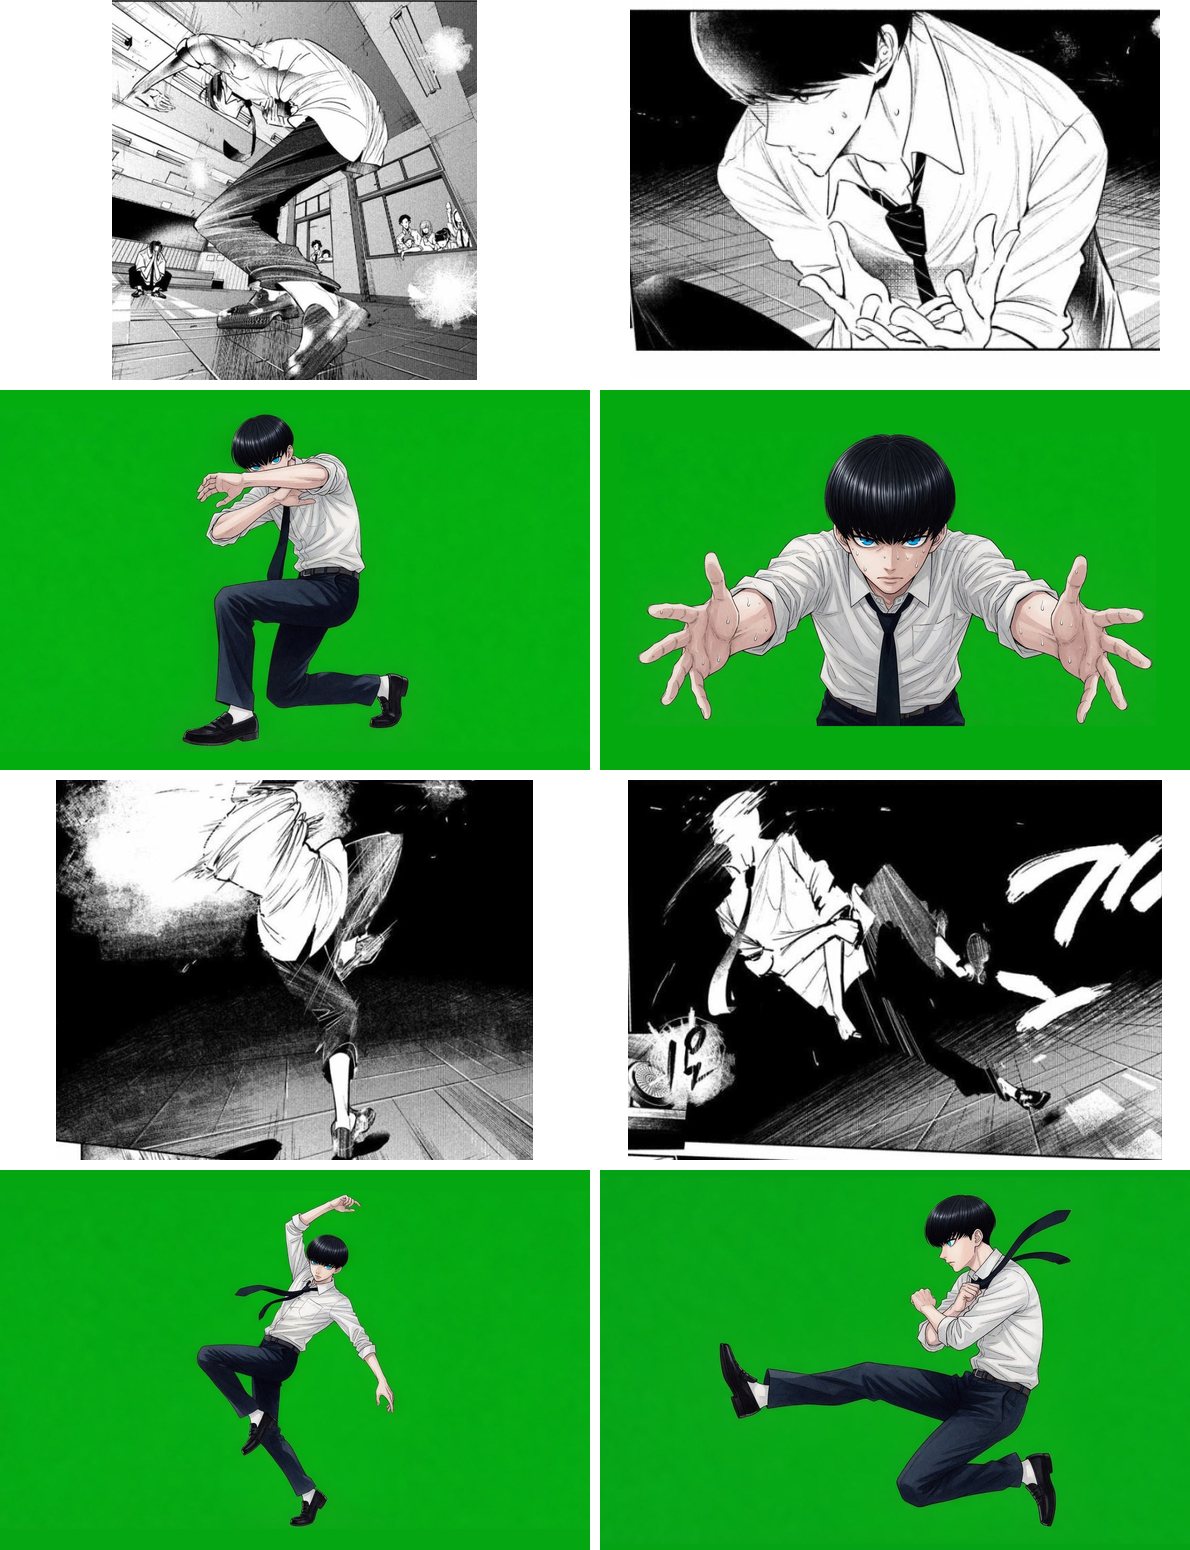
2つ目の版では逆に7コマだけを残し、それぞれのカメラアングルに合わせて描き直しました。ローアングルのロングショット、膝から上のミディアムショット、伸ばした手のクローズアップ、横からの全身像です。間につなぎのポーズを挟まず、静止も強制しませんでした。H3は自分でカメラを動かして寄ったり引いたりし、手のクローズアップから全身に戻るまで約16フレームかかり、急なカットはありませんでした。その代わり、約3分の1のフレームが直前のフレームとほぼ同じでした。動画は毎秒24フレームですが、重複する画面を除くと異なる画面は実質毎秒約12枚です。最後のランジも3秒止まり、少し長すぎます。
コマから分かるのはポーズとカメラアングルで、ポーズの間をどう動き、どれだけ時間をかけるかは分かりません。その部分はAIが自分で補いますが、滑らかにつながるかどうかはキーフレームの密度に直接関係します。
第3段階:作者の手描きを渡すと、残像のコマが余分な手足になる
作者の手描きは2コマ打ちで、速い動きにはスミアフレーム(一枚の絵に複数の位置を同時に描いて速度を表すもの)やスピード線も挟まれます。動作転写モデルはそれらもそのまま受け取るため、残像や余分な手足が生まれました。
動作転写(motion transfer)モデルは、キャラクター画像とダンス動画を渡すと、そのキャラクターに動画と同じダンスを踊らせます。最初の版ではWan Animate 2に作者の線画を直接読み込ませました。ポーズはおおむね合いましたが、顔が時々不自然になり、一部の動きも間違っていました。
作者の26.5秒の手描き動画を測定すると、異なる絵は全部で325枚あり、ほとんどは一枚を2フレーム表示する「2コマ打ち」でした。速い動きには、一枚の絵に手を複数の位置で描いたスミアフレームもあります。人には速度の表現ですが、Wan Animateには画面に本当に手が何本もあるように見えます。
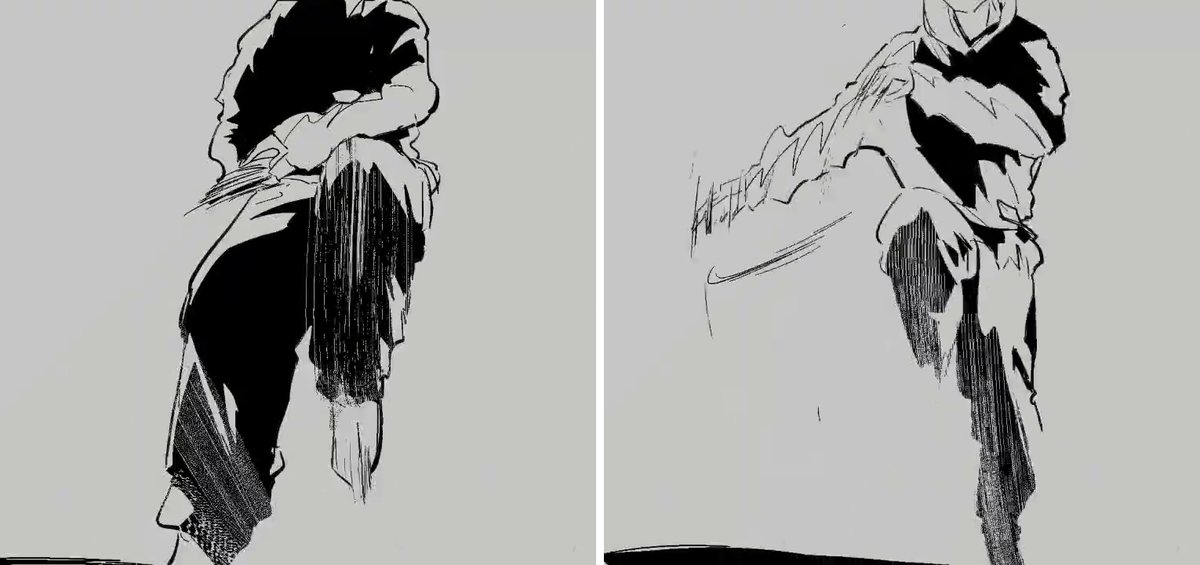
対策を3つ試しましたが、それぞれ別のところで行き詰まりました。
- 先に骨格を抽出し、骨格だけをモデルに渡す:Wan Animate 2は骨格画像をうまく扱えません。元の線画が最も良く、次が線画に骨格を重ねたもの、骨格だけが最も悪い結果でした。脚を上げる動きは直立に、フロアでの動きは寝たまま浮く動きになりました
- H3に替えて骨格で制御する:動きはおおむね追えますが、映像の粒状感が強くなりました
- 各カットをキャラクター画像から始め直す:モデルは各カットの冒頭でまずキャラクター画像の姿勢で立つため、短いカットは立ち姿だけで終わってしまいます。前に1秒の準備時間を足しても改善しませんでした
次に第2段階のキーフレーム方式も試しました。作者の重要なポーズを49枚選び、Grokにカラー漫画風のコマとして描かせ、作者の墨線の位置と大きさに合わせてH3に間を補間させます。一枚一枚はきれいですが、コマの間で形が崩れ、7.5秒付近では伊折が2人重なりました。作者が寄って足だけを映した数コマも、Grokは2回とも全身像にしました。同じ12秒間では、SCAIL-2に線画を直接読み込ませた動きが最も作者に近かったものの、映像はぼやけていました。
スミアフレームに描かれた手の複数の位置を、モデルは余分な手として描きました。手描きを直接読み込ませる方法は、ここで行き詰まりました。
転機:動きを3D人形に変換する
映像から直接動きを学ばせる方法がうまくいかなかったので、中間に一工程を入れました。まず映像の人物を3D人形に変換し、それからモデルに渡します。
SAM 3D Bodyは映像の人物を灰色の3Dの体に変換し、各フレームで全身の関節角度を推定します。画面外や隠れた部分も推定で補います。実写の人物写真しか認識できないのではと心配しましたが、実際にはアニメ映像も手描きの線画も予想以上に良好でした。アニメのジャンプ、フロアでの動き、倒立も捉えられました。作者が寄って足だけを映したフレームでは、抽出された人形も脚だけでした。
失敗したのは人物検出の工程です。最初はフレームごとに人物を検出していたため、伊折が倒立すると、検出対象が窓の外で見ている同級生に飛んでしまいました。動画全体で同じ人物を追跡するよう変えて、ようやく安定しました。
3D人形には2つの役割があります。きれいな体だけで、スミア表現も背景もないため、動作転写モデルが最も読み取りやすい入力です。また、工程全体で実際に動きを編集できる唯一の場所でもあります。
同じ人形を2つのモデルに渡すと、それぞれ長所と短所がありました。Wan Animateは映像が見やすく、漫画のインク線の感じがありますが、時々脚が半透明になります。SCAIL-2は動きがより正確な一方、画風は写実寄りの塗りつぶしたような感じで、顔がぼやけます。最終的にはリレー方式にしました。SCAIL-2が人形に沿って描き、その完成映像をWanがもう一度描き直します。ポーズはSCAIL、筆致はWanのものになりました。
完全版のポーズは作者の絵と合っています。14フレームを抽出し、同じ時点の作者の原画と並べて目視で比べると、どのポーズも一致し、倒立も最後に倒れる動きもありました。これは目視であり、プログラムによる測定ではありません。作者と違う点は2つあります。作者がカットを切り替える箇所もこの版では連続して動き、作者の2コマ打ちの緩急も滑らかになりました。どの工程で緩急が消えたかは一つずつ調べていませんが、人形の動き自体が滑らかなので、そこが最もありそうな原因です。
第4段階:アニメそのものを渡し、モーションキャプチャを修正する
動作転写モデルは模倣するだけです。アニメのシーンを直接読み込ませると、不自然さもそのまま残ります。修正するには3D人形の動きを変えるしかありません。
最初の2つの試みは映像側で行いました。Wan Animate 2にアニメのシーンを忠実に読み込ませる方法と、先にアニメのリズムを変えてから読み込ませる方法です。忠実版では不自然さも動きと一緒に引き継がれました。時間を変えた版では、花木の動画に4回の静止を挿入しましたが、生成後に確認できたのは1回だけで、残りはモデルに滑らかにされました。SCAIL-2にアニメを直接読み込ませると、さらに教室や窓の外で見ている同級生まで背景に描き込まれました。
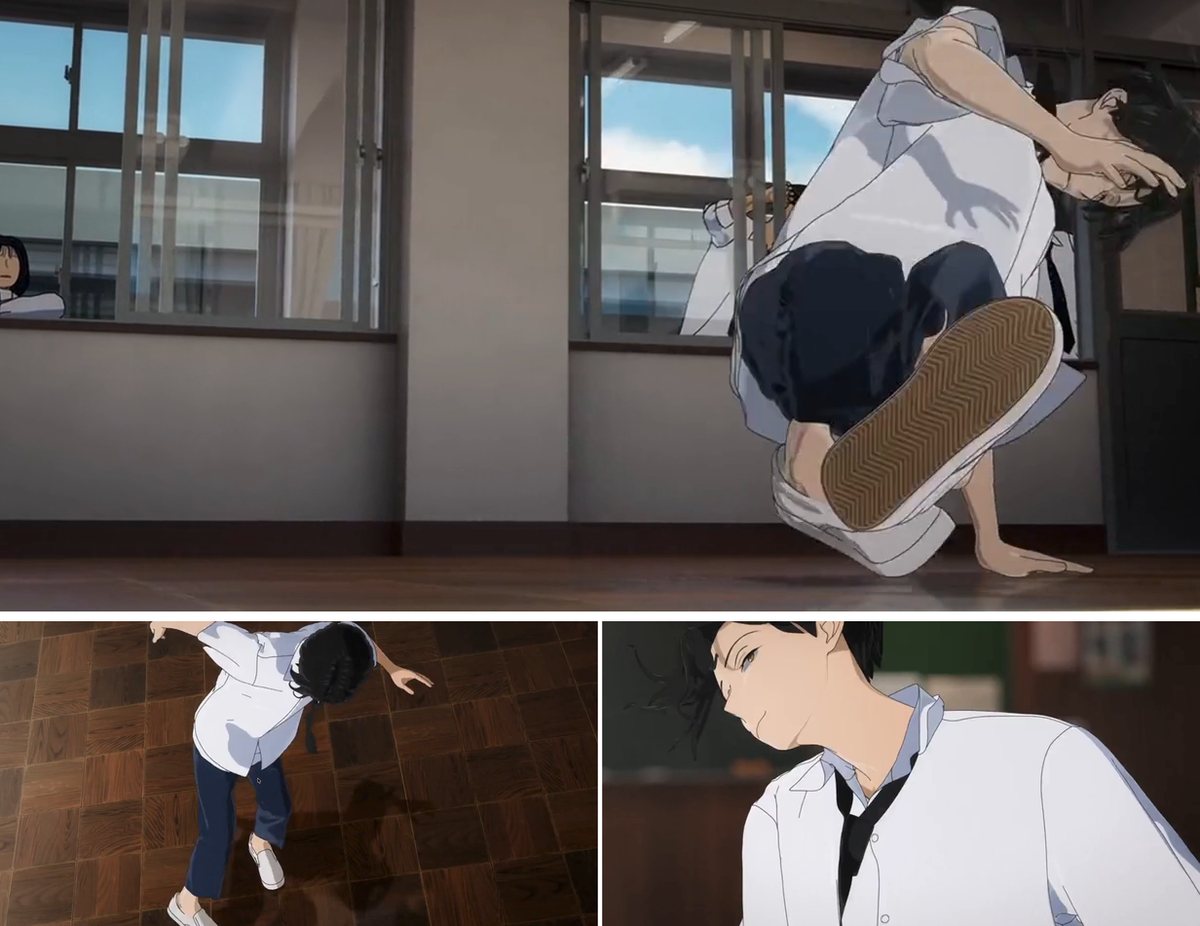
3D人形を使う方法に変えてからは、人形の時間配分だけを編集しました。絵を2フレームごとに切り替え、毎秒約12枚にします。動きが頂点に達したポーズは2フレーム長く止め、14.8秒のテスト部分では28か所に適用しました。増えた分のフレームは動きが最も速い瞬間から削り、全体の長さを変えず、ステップが元の音楽に合うようにしました。
修正後は動きの止めが明確になりましたが、脚を上げたり体を回したりする軌道は依然としてモーションキャプチャのままです。脚を上げて蹴る動きを例にすると、リズム修正後は脚が最も高い位置で2フレーム長く止まりますが、そこまで脚を上げる経路はモーションキャプチャの演者のものです。手描きアニメでは、大きな動きの前にいったん逆方向に引き、頂点のポーズも実際の人間より誇張して描きます。この2点には人形の関節データを直接編集する必要があり、今回は手を付けていません。
完全版にはもう一つ問題がありました。Wanに最初から最後まで続けて描かせると、前のカットのカメラアングルが次のカットにも引き継がれます。もともと上から撮ったカットは寄ったショットになり、頭部だけのクローズアップは全身が映るまで引かれました。動き自体は合っていますが、カメラアングルがずれました。
リズムは人形で修正できます。ただ、モーションキャプチャらしさをなくすために必要な残りの部分、動きの軌道とポーズには、今回はまだ手を付けていません。
追加実験:自分でダンスを振り付け、同じ絵コンテを3つのモデルに渡す
第1段階ではAIに音楽を聴かせて自由に踊らせ、第2〜4段階では漫画、手描き、アニメを模倣させました。最後は別の試し方です。原作には従わず、26.5秒のストリートダンスを自分で振り付け、カメラアングル、技、カットの切り替え位置をあらかじめ絵コンテで指定しました。同じ絵コンテをGrok Imagine、MiniMax H3、Seedance 2.5に渡し、どの程度守れるかを見ました。
音楽は作者の手描き動画で使われた元の曲を使い、テンポは129.2 BPMでした。2.32秒でドラムが入り、9.78秒でシンバルが鳴り、24.6秒で勢いが落ちます。5カットに分け、1カット平均5.3秒とし、切り替えはすべて小節の1拍目に置きました。技はストリートダンスでよく見るものを選び、名称もダンサーの一般的な呼び方です。chest popは胸を前に弾き、toprockは立って踏むステップ、six-stepは両手を床について脚を体の周りで一周させる動きです。カットごとにカメラアングルを変えました。
| カット | 時間(秒) | カメラアングル | 技 |
|---|---|---|---|
| 1 | 0–4.2 | 全身、正面、固定 | 拍を聴きながらうなずき、ドラムが入ったらchest pop、続いてtwo-step |
| 2 | 4.2–9.8 | 腰から上、斜め前、ゆっくり寄る | 連続したchest pop、arm wave、body rollの後、カメラを指さす |
| 3 | 9.8–15.3 | 全身、ローアングル、回り込む | シンバルに合わせて跳んで着地し、Running Man、Roger Rabbit、一回転 |
| 4 | 15.3–20.9 | 全身、俯瞰 | toprock、床に降りる、six-step |
| 5 | 20.9–26.5 | 膝から上、ローアングル、寄る | 床から回転しながら立ち、arm hitを2回、24.6秒で腕を組んで最後まで静止 |
キャラクターは伊折に替えました。GPTにカラー漫画の表紙2枚を参考に、キャラクター画像、四面図、細部の画像を描かせました。背景は何もない真っ白な空間に変え、さらに5枚の冒頭画像を作って3つのモデルで共有しました。絵コンテ、音楽、冒頭画像はすべて同じですが、3つのモデルへの渡し方は異なります。以下で順に説明します。比較しているのは3つの方法でもあり、単に3つのモデルではありません。
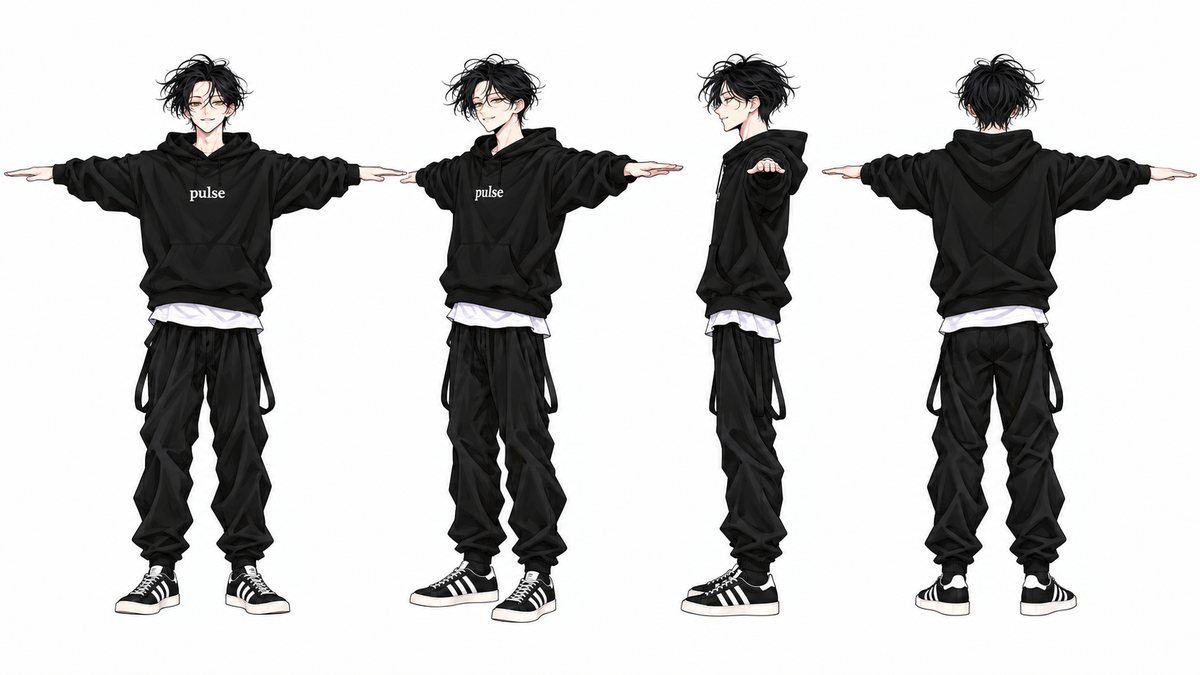
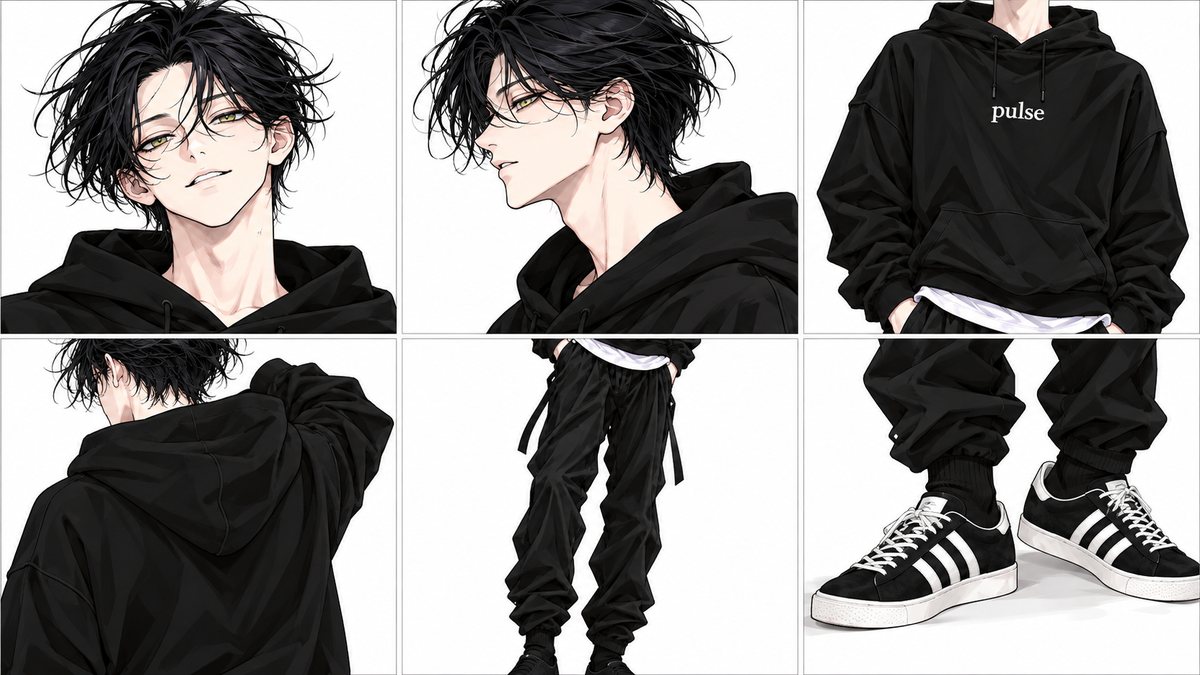
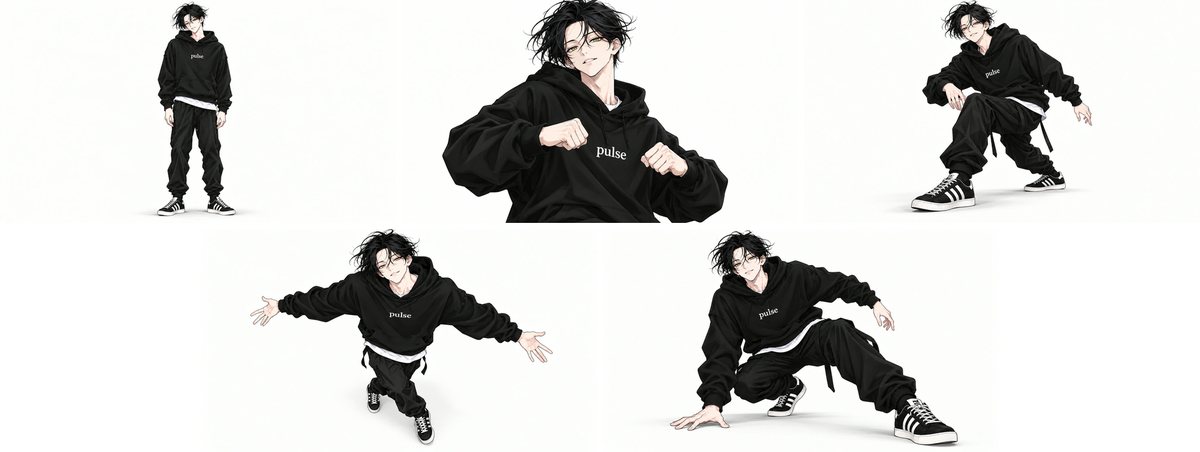
3つのモデルには、それぞれ明確な長所と問題がありました。
- Grok Imagine 冒頭画像をそのまま最初のフレームに使うため、構図は冒頭画像に最も近くなりました。生成中は音楽を聴けず、音楽は編集後に重ねています。腰から上のカットは踊りの途中でカメラが勝手に引いて全身像になりました。Running Manとsix-stepのカットは動きが弱く、リハビリをしているように見えます
- MiniMax H3 キャラクター画像、顔のクローズアップ、冒頭画像、そのカットの音楽を同時に受け取り、音楽を聴きながら踊ります。カメラアングルも最も安定していました。問題は参照画像を映像に描き込んでしまうことです。四面図はキャラクターの両脇に半透明の分身となって現れ、冒頭画像は残像になりました。四面図を外し、2カットでは冒頭画像を直接最初のフレームにして、ようやくきれいになりました
- Seedance 2.5 こちらも音楽を聴き、動きの大きさは3モデル中最大でした。ただし「冒頭画像を最初のフレームに固定する」と「参照音楽を使う」を同時には指定できません。私は音楽を選び、冒頭画像は参照としてだけ渡しました。その結果、真っ白な背景を維持できず、あるカットは壁の隅に影のある薄灰色の部屋になりました。最初の試行ではarm waveを、腕から光る軌跡が伸びる動きとして描いてしまいました
できたこと、まだ足りないこと
2026年10月時点での実測結果をまとめます。
- できたこと:音楽を聴きながら踊る。重要なポーズを一続きの動きにし、カメラも追って動かす。一つのダンスを別のキャラクターに踊らせる。アニメ映像と手描きの線画から3D人形を抽出する。2つのモデルをリレーさせ、それぞれの長所を取り入れる。一つの絵コンテに沿って異なるカメラアングルに切り替える
- できなかったこと:名前と音楽だけから原作のダンスを再現する。手描きの緩急をそのまま再現する。続けて描きながら各カットのカメラアングルを維持する。すべてのカットで絵コンテ指定のアングルを守る。参照画像を参照としてだけ使い、映像には描き込まない
- まだ試していないこと:人形の関節データを直接編集し、モーションキャプチャの動きの軌道を手描きに近づける
- かかったコスト:第3・4段階の完全版は合わせて71.5秒で、1枚のRTX 3090を約8時間、ほぼ一日分の勤務時間に相当する時間動かしました
今回最も確信を持てた収穫は工程の順序です。まず動きを3D人形に変換し、それからモデルにキャラクターを替えさせる。動きを直したければ、人形を編集します。
あなたのAI Agentにコピーする
以下をあなたのAIに貼り付け、手元にあるダンス動画とキャラクター画像を見比べてもらってください。
さらに読む
| 資料 | 重要な理由 |
|---|---|
| Hinata〈『絕妙舞步』が『絕望舞步』に〉(YouTube Short) | この記事の出発点。アニメのモーションキャプチャによるダンスと作者の手描きが並び、その差が一目で分かります |
| 珈琲による手描きアニメの原投稿(X) | 第3段階で比較に使った原作。2コマ打ちとスミアフレームの両方が見られます |
| CBR、2025年10月 | 同じダンスの中で手描きと3Dが行き来し、滑らかさが途切れると指摘しています |
| AniTrendz、2026年1月 | 3Dキャラクターの顔がほとんど固まり、目に輝きがないと指摘しています |
音楽と映像の著作権
記事中のスクリーンショット、動画、音楽の権利はそれぞれの権利者に帰属します。ここでは実験結果を説明するために引用しています。権利者の方で削除を希望される場合は、コメントでお知らせください。
| 種類 | 作品と権利者 | 使用箇所 |
|---|---|---|
| 音楽 | Jazztronik〈Samurai〉 | 作者の珈琲による手描きアニメ2本目の使用楽曲です。第3段階の4本、第2段階のカメラアングル版、追加実験の3モデル比較ではこの曲を音声トラックに使用しました。第1段階のH3の2本と第2段階のキーフレームを密に配置した2本では生成時の入力に使い、音声トラックはH3がこれをもとに生成したものです |
| 手描きアニメ | 珈琲(X:@ccffeee) | 第3段階の動きの出典です。原作はXの公式埋め込みでのみ再生し、変換や別途保存はしていません |
| TVアニメ | 『ワンダンス』第5話 ©珈琲・講談社/ワンダンス製作委員会 | 第4段階のスクリーンショット、動きの出典、並べて表示した元動画のシーンです。第4段階の完全版の音声トラックもこの元音声から取りました |
| 漫画 | 珈琲『ワンダンス』第7話(講談社) | 第1・2段階のコマのスクリーンショット |
| YouTube Short | Hinata〈『絕妙舞步』が『絕望舞步』に〉 | きっかけを説明した節のスクリーンショット |