절묘한 춤이 절망적인 춤으로,
AI가 살려낼 수 있을까요?
네 단계를 시험해 보니 AI는 음악에 맞춰 춤추고, 핵심 자세를 이어 붙이고, 한 춤을 다른 캐릭터에게 옮길 수 있었습니다. 하지만 모션 캡처의 어색한 동작은 이번에 고치지 못했습니다.
계기: 애니메이션과 손그림을 나란히 비교한 Short
실험 기간: 2026년 10월 6일부터 9일까지. 사용한 모델: Grok Imagine, MiniMax H3, Seedance 2.5, Wan Animate 2, SCAIL-2, SAM 3D Body, SeedVR2. 마지막 실험의 캐릭터 이미지는 GPT로 생성했습니다. H3, Wan, SCAIL-2는 RTX 3090 한 장에서 돌렸고, Grok과 Seedance는 클라우드에서 사용했습니다. 이 모델들은 업데이트가 빠르므로 아래 결론은 이 기간에 사용한 버전에 한정됩니다. 모든 영상에는 ‘어떤 모델로 어떻게 만들었는지’를 표시했습니다.
《원댄스》(Wandance, 대만 번역명 《絕妙舞步》, ‘절묘한 춤’)는 고등학생들의 스트리트 댄스를 다룬 만화로, 2025년 가을에 애니메이션으로 제작됐습니다. 애니메이션의 춤 장면은 3D 모션 캡처(사람이 한 번 춤추고 컴퓨터가 그 동작을 기록한 뒤 3D 캐릭터에 적용하는 방식)로 만들었습니다.
저는 YouTube Short 하나를 보고 이 사실을 알았습니다. 〈《絕妙舞步》가 《絕望舞步》로〉(Hinata). 이 영상은 애니메이션 속 춤과 원작자 코히가 직접 그린 애니메이션을 나란히 비교하는데, 차이가 한눈에 보입니다.

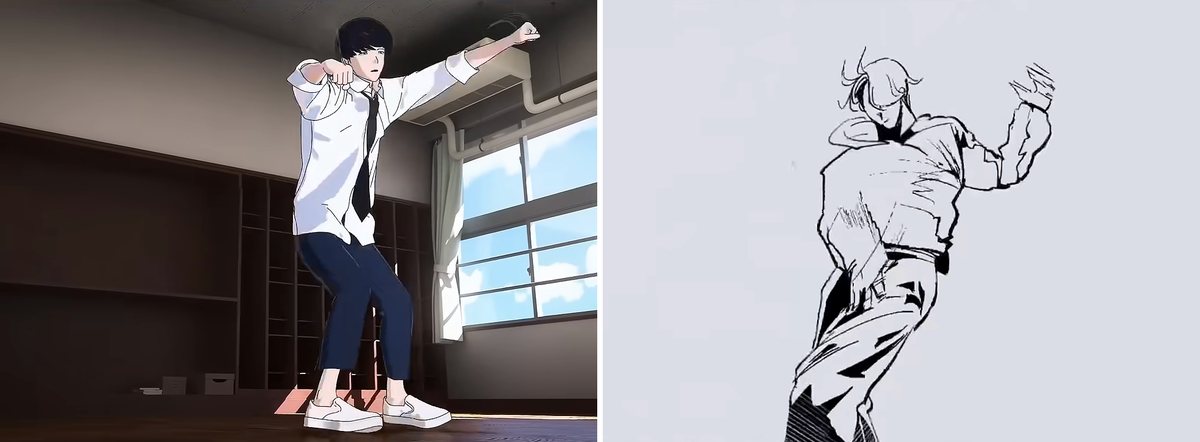
애니메이션 리뷰도 같은 문제를 짚었습니다. CBR은 같은 춤 장면이 손그림과 3D 사이를 오가면서 화면의 흐름이 끊긴다고 지적했습니다(CBR, 2025년 10월). AniTrendz는 더 직접적으로 썼습니다. 캐릭터의 얼굴은 거의 굳어 있고 눈에는 생기가 없으며, 입은 인형에 그은 선처럼 보인다고 했습니다(AniTrendz, 2026년 1월)。
보고 나니 지금 AI가 얼마나 도울 수 있을지 궁금해졌습니다. 저는 문제를 네 단계로 나눴습니다. 뒤로 갈수록 AI에 더 구체적인 정보를 줍니다.
- 음악과 춤 동작 이름만 주면 AI가 스스로 춤을 만들 수 있을까요?
- 만화 콘티를 키프레임으로 주면 AI가 동작 사이를 이어 줄 수 있을까요?
- 작가의 손그림 애니메이션을 주면 AI가 컬러 만화풍 캐릭터를 똑같이 춤추게 할 수 있을까요?
- 애니메이션 자체를 주면 AI가 어색한 모션 캡처를 고칠 수 있을까요?
글에 나온 캐릭터 이미지는 제가 공식 설정과 만화의 컬러 표지를 참고해 AI로 그린 팬아트 성격의 디자인이며, 공식 자료가 아닙니다.
시작하기 전에 캐릭터를 잘못 알아본 실수도 했습니다. Short의 애니메이션 장면은 주인공 고타니 카보쿠인데, 작가가 손으로 그린 춤은 다른 캐릭터인 이쓰쿠시마 이오리의 것이었습니다. 두 장면이 나란히 있어서 저는 작가가 그린 캐릭터도 카보쿠라고 생각했습니다. 앞의 세 단계를 한 차례 마친 뒤에야 옷과 바닥 동작이 맞지 않는다는 걸 발견했고, 이오리의 공식 설정으로 바꾸니 일치했습니다. 그래서 뒤의 각 단계에는 카보쿠와 이오리 두 버전이 있고, 몇몇 비교 영상은 ‘카보쿠가 이오리의 춤을 추는’ 경우입니다.
네 단계에 걸쳐 십여 가지 방법을 시도했습니다. 결론부터 말하면 각 단계에서 AI가 무언가를 만들어 내긴 했지만, 어느 단계도 제가 원하는 모습에 이르지는 못했습니다.
먼저 결론: 네 단계를 한눈에 보기
네 단계는 AI에 주는 정보의 양이 다릅니다. 표에는 각 단계에서 가장 나았던 방법과 막힌 지점을 정리했고, 뒤에서 한 단계씩 풀어 설명합니다. 마지막 행은 원작을 따르지 않고 직접 안무를 짜 본 추가 실험입니다.
| 단계 | AI에 주는 것 | 가장 나았던 방법 | 얻은 결과 | 막힌 지점 |
|---|---|---|---|---|
| 1 | 음악+춤 동작 이름 | H3+박자에 맞춰 쓴 동작표+원본 영상의 음악을 함께 입력 | 음악을 들으며 춤추고, 동작표의 큰 동작을 수행함 | ‘하나의 춤’을 췄을 뿐 원작의 그 춤은 아님 |
| 2 | 만화 콘티 | 콘티의 카메라 구도에 맞춰 키프레임 7장을 다시 그리고, H3가 한 번의 연속 촬영처럼 중간을 채움 | 모든 자세를 거치고 카메라도 따라 움직임 | 키프레임이 많을수록 포즈만 바꾸는 듯함. 콘티 사이의 시간은 직접 짜야 함 |
| 3 | 작가의 손그림 애니메이션 | 선화를 3D 인형으로 변환 → SCAIL-2 → Wan으로 다시 그림 | 자세가 작가의 원본과 맞음 | 작가의 2프레임 촬영 특유의 끊어지는 리듬이 사라짐 |
| 4 | 애니메이션 자체 | 애니메이션을 3D 인형으로 변환 → Wan → 리듬 수정 | 캐릭터를 바꾸고 멈추는 지점이 더 선명해짐 | 모션 캡처의 움직임 궤적은 고치지 못함. 카메라 구도가 어긋남 |
| 추가 실험 | 음악+직접 짠 콘티+시작 이미지 | H3가 음악을 들으며 생성, 두 장면은 시작 이미지를 첫 프레임으로 사용 | 콘티대로 구도를 바꾸고 음악에 맞춰 춤춤 | 참고 이미지가 화면에 그려지고 빈 공간에는 잡동사니가 생김 |
표 전체를 보면 자료가 구체적일수록 AI는 더 정확하게 따라 합니다. 하지만 4단계에서 필요한 것은 ‘따라 하기’가 아니라 ‘고치기’였고, 이번에 제가 시도한 수정은 리듬까지였습니다.
1단계: 음악과 춤 동작 이름만 주기
글과 음악만 주면 AI가 음악에 맞춰 그럴듯한 춤을 추지만, 그것은 AI가 상상한 춤이지 만화 속 춤은 아닙니다.
만화에는 춤 동작 이름이 없고 춤 스타일, 곡명, 내레이션만 있습니다. 카보쿠 장면에는 ‘HIPHOP, 2Pac 〈Changes〉, 내레이션 “소리를 듣는다”’를 입력했습니다. 이오리 장면의 만화에는 HOUSE/BREAK라고 쓰여 있고, 내레이션은 ‘머리가 비트에 맞는다’, ‘작은 소리는 모두 발걸음에 담긴다’, ‘힘을 뺀 느낌과 여유’입니다. 그래서 이 단계의 ‘춤 동작 이름’은 사실 제가 내레이션을 바탕으로 지은 것입니다.
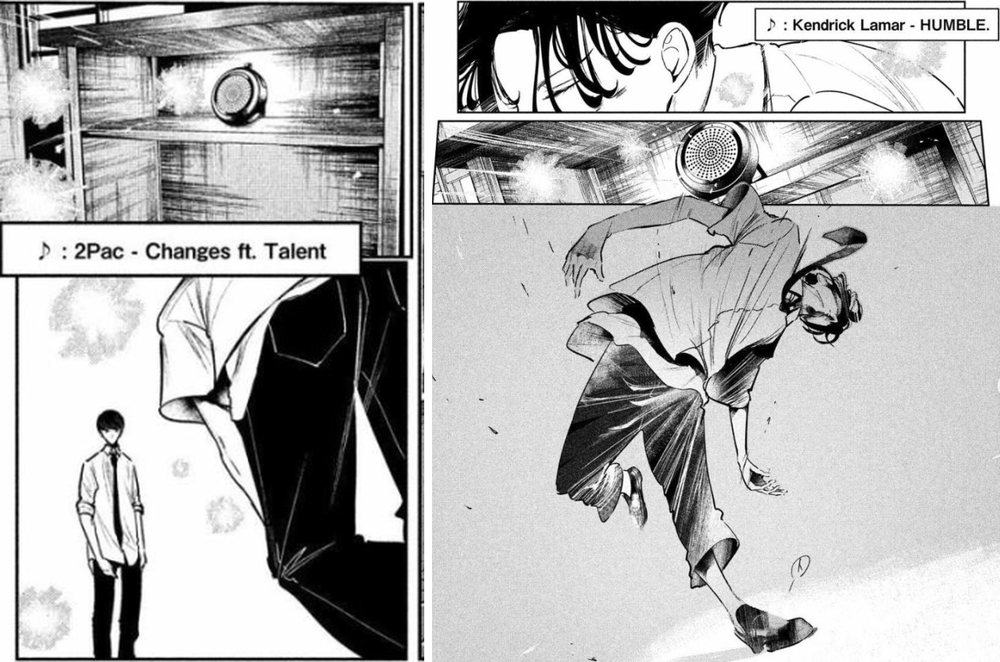
두 가지 방법을 시험했습니다.
- Grok Imagine에 글만 입력: 캐릭터와 그린스크린은 안정적이지만 동작은 평범한 리듬 스텝이며, 만화처럼 무게중심을 낮춘 큰 동작은 없습니다.
- MiniMax H3+동작표+원본 영상의 음악: 내레이션을 초 단위로 배열한 동작표로 만들고(이름은 제가 지었으며 모두 추측입니다), 작가 원본 영상의 음악도 모델에 함께 입력했습니다.
H3로 만든 쪽은 동작이 훨씬 큽니다. 저는 ‘가장 낮을 때의 키÷똑바로 섰을 때의 키’로 웅크린 깊이를 측정했습니다. Grok 버전은 0.83, H3 버전은 0.57까지 내려갔고, 발을 넓게 벌리고 무게를 싣기, 무릎 들기, 옆차기, 마지막 깊은 런지까지 동작표대로 했습니다. 이오리 버전은 seed 세 개 모두에서 물구나무 freeze가 나왔습니다.
원본 영상의 음악을 H3에 함께 준 것이 이 단계에서 가장 체감되는 차이였습니다. H3가 생성한 영상에는 오디오 트랙이 붙어 있었는데, 측정해 보니 속도가 원곡과 같은 129.2 BPM이었고 두 트랙의 음량 변화도 맞았으며 시간차도 없었습니다. 모델이 이 음악을 실제로 받아들였다는 증거입니다. 춤 동작이 박자에 정확히 맞는지는 따로 측정하지 않았습니다.
이름과 음악만 주면 AI는 음악을 들으며 나열한 큰 동작을 해낼 수 있습니다. 하지만 원작의 춤이 어떤 모습인지는 알 길이 없습니다.
2단계: 만화 콘티를 주고 AI가 동작을 잇게 하기
만화 콘티를 키프레임으로 그려 영상 모델에 중간을 채우게 하면 AI가 연결해 줍니다. 하지만 키프레임이 많을수록 포즈를 취하는 것처럼 보이고, 콘티 사이의 시간도 직접 정해야 합니다.
먼저 Grok으로 각 콘티를 컬러 만화풍 캐릭터로 그리고, H3가 차례로 그 자세를 거치게 했습니다. 여기서 한 가지 문제가 생겼습니다. 만화 칸을 그대로 참고 이미지로 주면 Grok이 손에 가려진 머리를 두 번째 머리로 잘못 그려 9장 중 3장이 망가졌습니다. 자세를 글로만 설명하자 이후 수십 장에서는 두 번째 머리가 다시 나타나지 않았습니다.
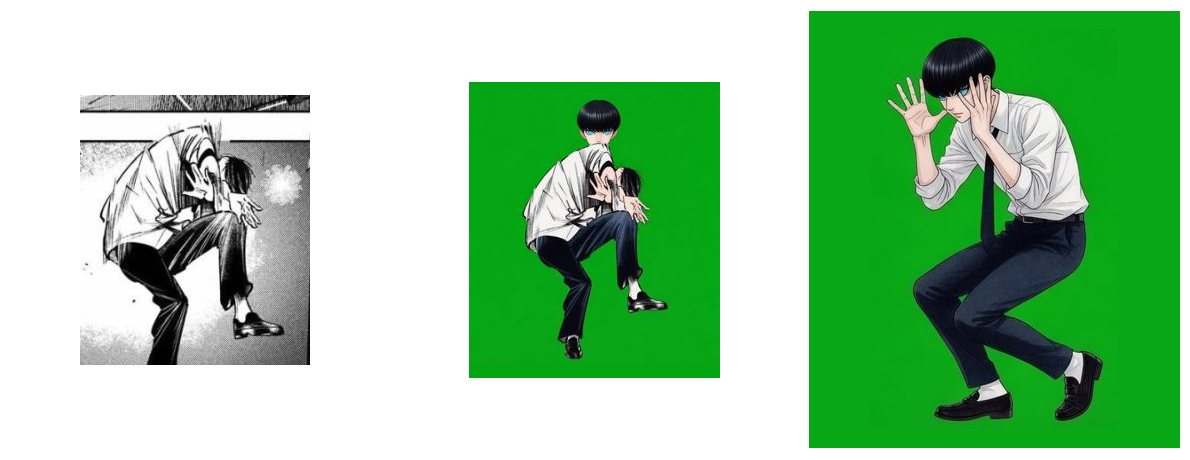
첫 버전에서는 키프레임을 촘촘히 배치했습니다. 콘티 9장 사이마다 전환 자세를 한 장씩 넣고, 키프레임이 박자에 닿으면 3프레임 동안 멈추게 했습니다. 덕분에 배경은 안정됐습니다. 하지만 한 장씩 포즈만 바꾸는 듯 동작이 끊겨 보였습니다.
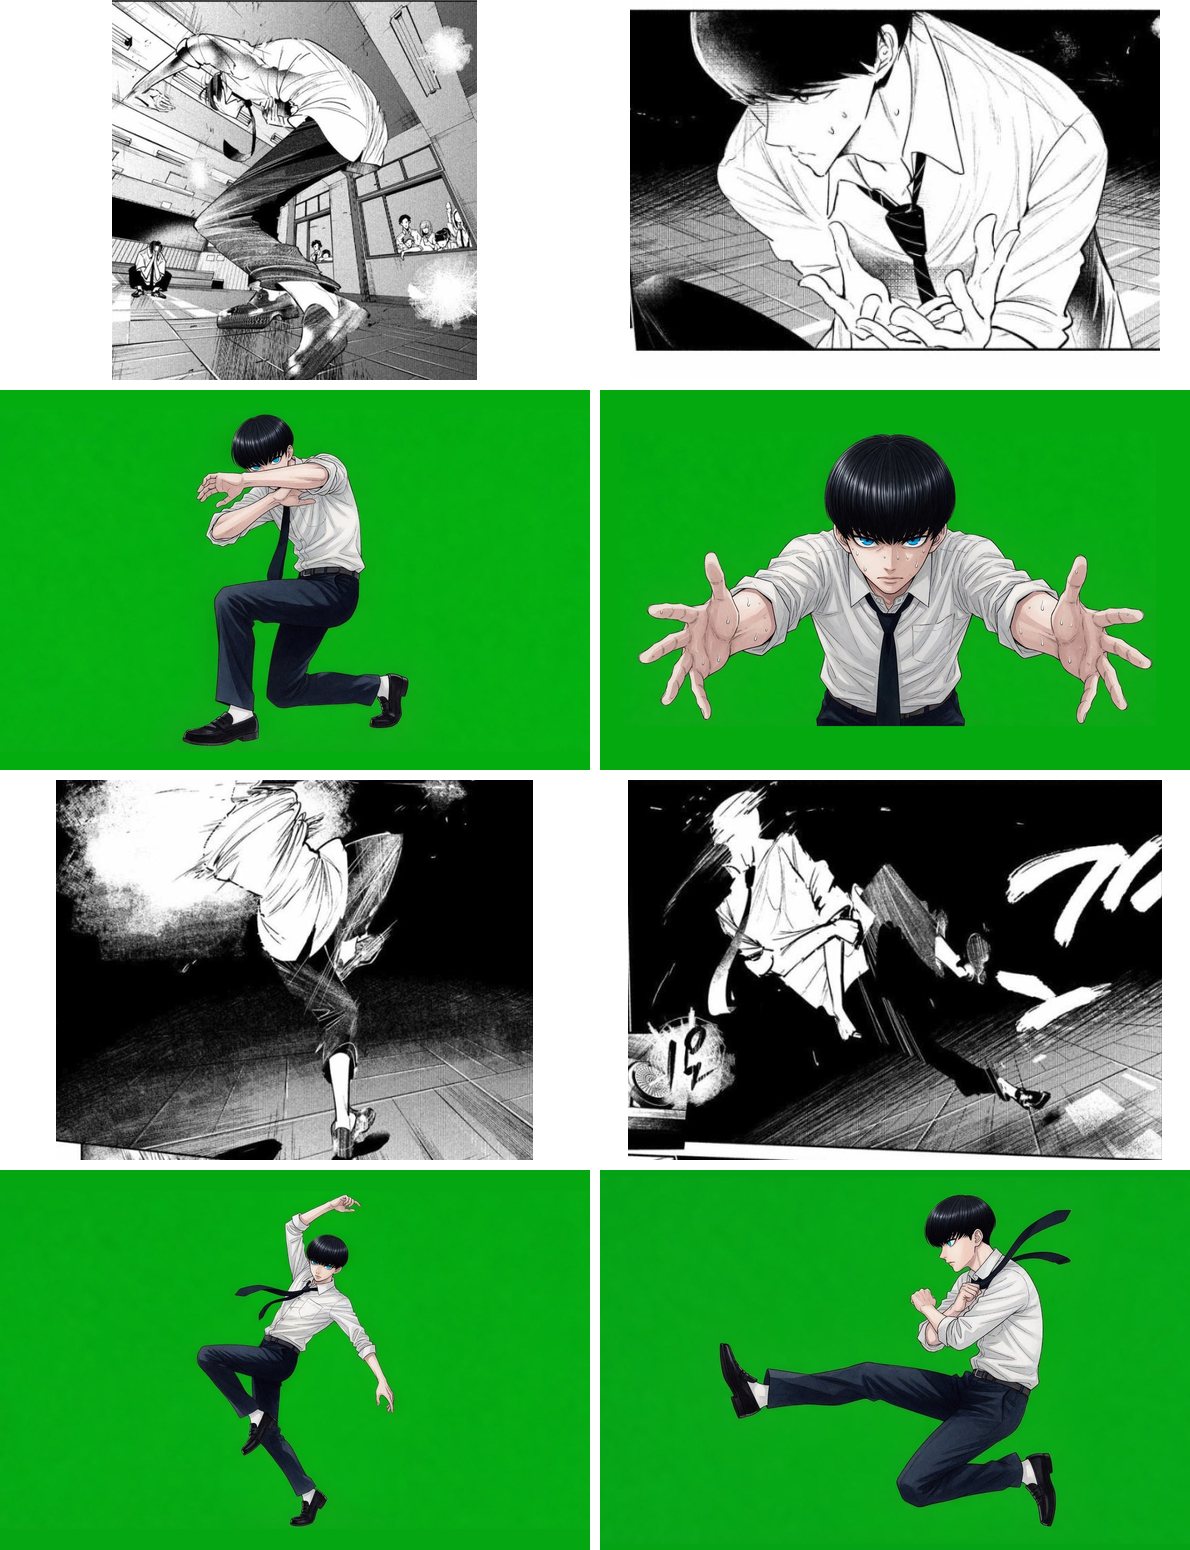
두 번째 버전은 반대로 콘티 7장만 남기고 각 칸의 구도에 맞춰 다시 그렸습니다. 로우 앵글 롱숏, 무릎 위 미디엄숏, 뻗은 손의 클로즈업, 측면 전신숏을 사용하고 중간에 전환 자세를 넣거나 정지 화면을 강제하지 않았습니다. H3가 스스로 카메라를 움직여 줌인과 줌아웃을 했고, 손 클로즈업에서 전신으로 돌아오는 데 약 16프레임이 걸렸으며 갑작스러운 컷 전환은 없었습니다. 대신 약 3분의 1의 프레임이 앞 프레임과 거의 같았습니다. 영상은 초당 24프레임이지만 중복을 빼면 실제로 다른 화면은 초당 약 12장이고, 끝의 런지 자세도 3초 동안 유지돼 조금 길었습니다.
콘티에는 자세와 카메라 구도만 있고, 자세 사이에 어떻게 움직일지와 얼마나 걸릴지는 없습니다. 그 부분은 AI가 스스로 채우며, 얼마나 자연스러운지는 키프레임 간격과 직접 관련됩니다.
3단계: 작가의 손그림을 주면 스미어 프레임이 여분의 팔다리로 바뀝니다
작가의 손그림은 2프레임 촬영이고, 빠른 동작에는 스미어 프레임(한 그림에 여러 위치를 함께 그려 속도를 표현하는 기법)과 속도선도 끼어 있습니다. 동작 전이 모델이 이를 그대로 받아들여 잔상과 여분의 팔다리를 만들어 냅니다.
동작 전이(motion transfer) 모델은 캐릭터 이미지 한 장과 춤 영상 하나를 받으면 그 캐릭터가 영상대로 춤추게 합니다. 첫 버전에서는 Wan Animate 2에 작가의 선화를 직접 읽혔습니다. 자세는 대체로 맞았지만 얼굴이 가끔 이상하고 일부 동작은 틀렸습니다.
작가가 그린 26.5초짜리 영상을 측정해 보니 서로 다른 그림은 모두 325장이었고, 대부분 한 장을 2프레임씩 보여 줍니다(애니메이션에서는 ‘2프레임 촬영’이라고 합니다). 빠른 동작에는 한 그림에 손의 위치를 여러 개 그린 스미어 프레임도 있습니다. 사람에게는 속도감으로 보이지만 Wan Animate는 화면에 실제로 손이 여러 개 있다고 읽습니다.
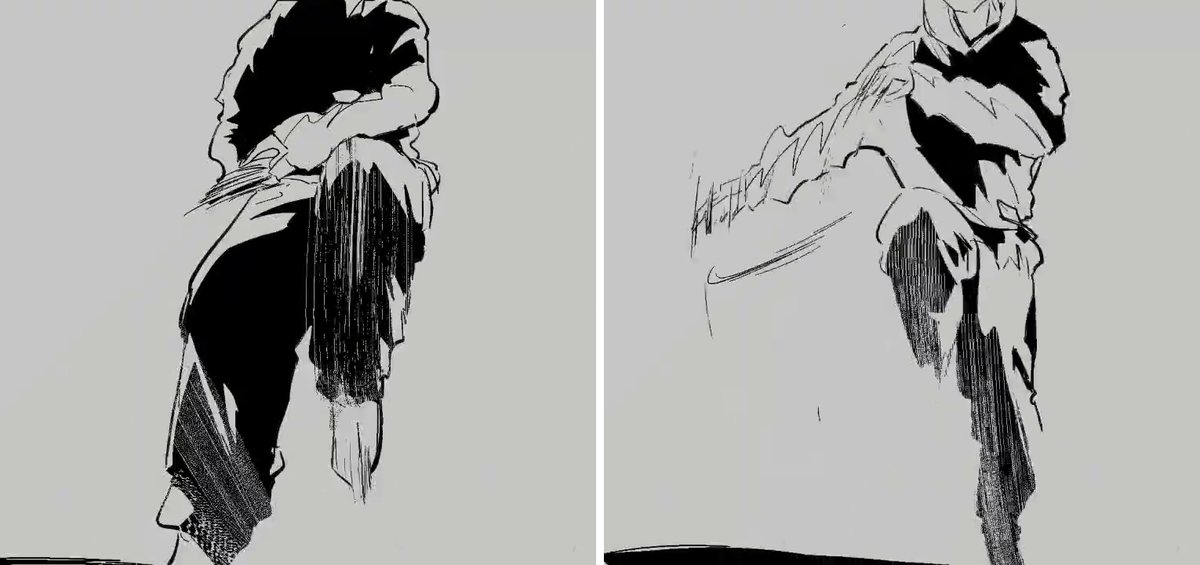
세 가지 해결책을 시도했지만 각기 다른 곳에서 막혔습니다.
- 먼저 뼈대를 추출해 모델에 뼈대만 주기: Wan Animate 2는 뼈대 이미지를 잘 처리하지 못했습니다. 원래 선화가 가장 좋았고, 선화 위에 뼈대를 겹친 것이 그다음, 뼈대만 준 결과가 가장 나빴습니다. 다리를 드는 동작은 똑바로 서는 모습으로, 바닥 동작은 누워서 떠다니는 모습으로 바뀌었습니다.
- H3에 뼈대 제어 사용하기: 동작은 대략 따라가지만 화면에 입자가 매우 심했습니다.
- 각 장면을 캐릭터 이미지에서 다시 시작하기: 모델이 매 장면 시작 시 캐릭터 이미지의 자세로 먼저 서 있었습니다. 짧은 장면은 거의 전부 서 있는 자세로 채워졌고, 앞에 준비 시간 1초를 더 넣어도 해결되지 않았습니다.
다음에는 2단계의 키프레임 방식도 시도했습니다. 작가의 핵심 자세 49장을 골라 Grok으로 컬러 만화풍 프레임을 그리되 작가의 먹선과 위치·크기를 맞춘 뒤, H3에 사이를 채우게 했습니다. 키프레임 하나하나는 아름다웠지만 그 사이가 무너졌고, 7.5초 부근에서는 이오리가 두 명 겹쳐 나타났습니다. 작가가 카메라를 당겨 발만 찍은 프레임도 Grok은 두 번 모두 전신으로 그렸습니다. 같은 12초 구간에서는 SCAIL-2가 선화를 직접 읽은 동작이 작가의 원본과 가장 가까웠지만 화면은 흐릿했습니다.
스미어 프레임에 손의 위치가 여러 개 그려져 있으니 모델도 여분의 손을 그렸습니다. 손그림을 직접 읽히는 방식은 여기서 막혔습니다.
전환점: 동작을 3D 인형으로 바꾸기
화면에서 직접 동작을 학습시키는 방법이 막히자 중간 단계를 하나 넣었습니다. 화면 속 사람을 먼저 3D 인형으로 바꾼 뒤 모델에 주는 것입니다.
SAM 3D Body는 화면 속 사람을 회색 3D 신체로 바꾸고, 프레임마다 전신의 관절 각도를 추정합니다. 화면 밖에 있거나 가려진 부위는 모델이 추정한 것입니다. 처음에는 실제 사람 사진만 인식할까 걱정했는데, 애니메이션 화면과 손그림 선화 모두 예상보다 잘 처리했습니다. 애니메이션 장면에서는 점프, 바닥 동작, 물구나무까지 잡아냈습니다. 작가가 카메라를 당겨 발만 찍은 프레임에서 추출한 인형도 다리만 있었습니다.
문제는 사람을 감지하는 단계에서 생겼습니다. 처음에는 프레임마다 따로 사람을 찾았더니 이오리가 물구나무를 서는 순간 창밖에서 구경하는 학생을 잡았습니다. 한 사람을 영상 전체에 걸쳐 추적하도록 바꾸고 나서야 안정됐습니다.
3D 인형에는 두 가지 용도가 있습니다. 깨끗한 신체에 스미어 효과나 배경이 없어 동작 전이 모델이 읽기 가장 좋은 입력이고, 전체 과정에서 동작 자체를 손댈 수 있는 유일한 지점이기도 합니다.
같은 인형을 두 모델에 주자 각기 장단점이 드러났습니다. Wan Animate는 화면이 더 보기 편하고 만화의 먹선 느낌도 있지만 다리가 가끔 반투명해집니다. SCAIL-2는 동작이 더 정확하지만 그림체가 사실적인 덧칠에 가깝고 얼굴도 흐립니다. 마지막에는 두 모델을 이어 썼습니다. SCAIL-2가 인형을 보고 먼저 그린 뒤 Wan이 SCAIL 결과물을 다시 그려, 자세는 SCAIL을 따르고 필치는 Wan의 것을 얻었습니다.
전체 버전의 자세는 작가의 원본과 맞았습니다. 14프레임을 뽑아 같은 시점의 원본 그림과 나란히 놓고 눈으로 비교했더니 매 프레임의 자세가 맞았고, 물구나무와 마지막에 쓰러지는 동작도 있었습니다. 이는 눈으로 확인한 것이지 프로그램으로 측정한 결과는 아닙니다. 작가와 다른 점은 두 가지입니다. 작가가 장면을 전환한 곳에서 이 버전은 연속 동작으로 넘어갔고, 작가의 2프레임 촬영 특유의 끊어지는 느낌도 매끄러워졌습니다. 어느 단계에서 그 느낌이 사라졌는지 하나씩 확인하지는 않았습니다. 인형의 동작 자체가 매끄러워 가장 가능성 높은 원인입니다.
4단계: 애니메이션 자체를 주고 모션 캡처 고치기
동작 전이 모델은 그대로 따라 하기만 합니다. 따라서 애니메이션 장면을 직접 읽히면 어색한 느낌도 그대로 남습니다. 고치려면 3D 인형에서 손봐야 합니다.
첫 두 시도는 모두 화면을 직접 다뤘습니다. Wan Animate 2가 애니메이션 장면을 충실하게 읽게 하거나, 먼저 애니메이션의 리듬을 바꾼 뒤 읽게 했습니다. 충실한 버전은 동작과 어색함을 함께 가져왔습니다. 시간을 바꾼 버전은 카보쿠 영상에 정지 화면을 4번 넣었지만 생성 후 측정된 것은 1번뿐이고 나머지는 모델이 매끄럽게 만들어 버렸습니다. SCAIL-2가 애니메이션을 직접 읽었을 때는 교실과 창밖에서 구경하는 학생들까지 배경에 그리는 문제가 추가됐습니다.
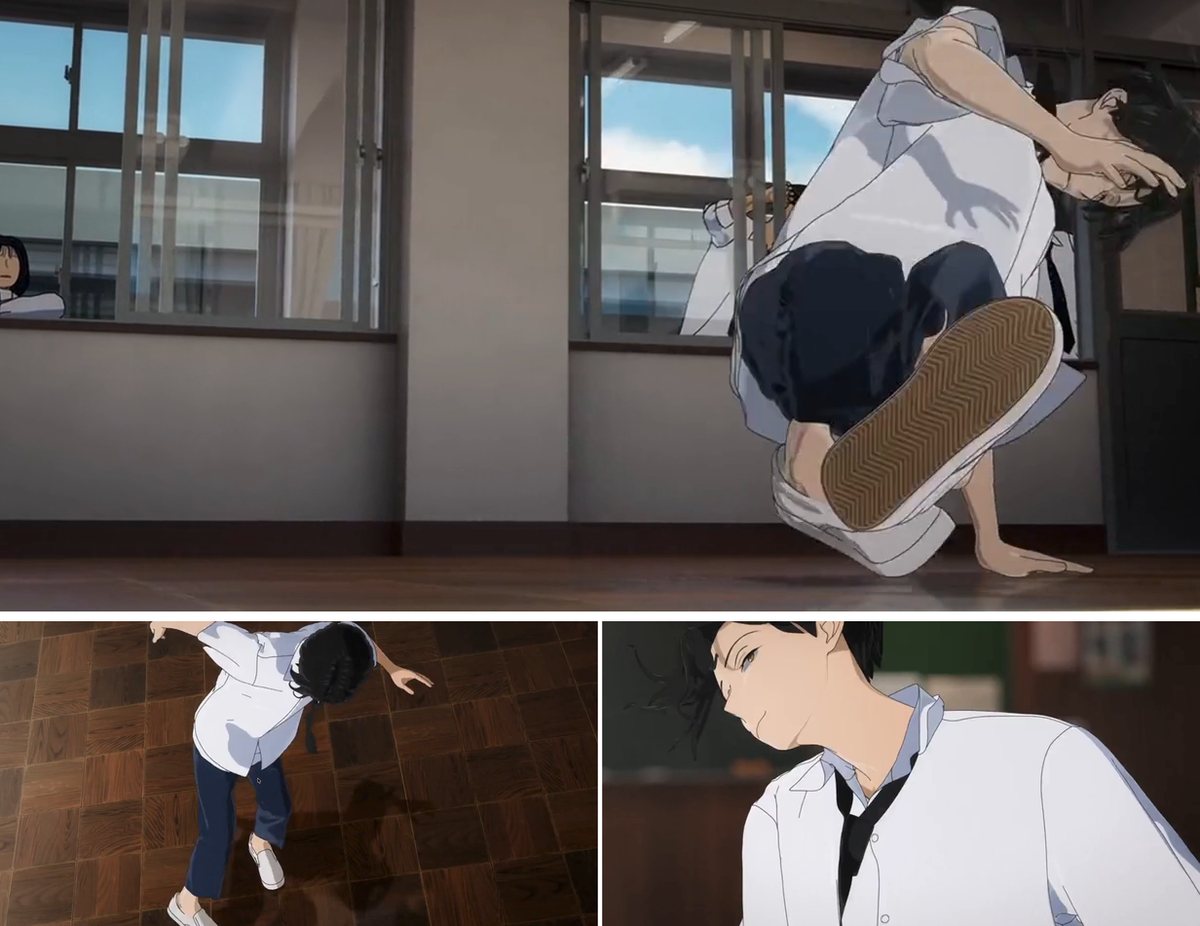
3D 인형 방식으로 바꾼 뒤에는 인형의 시간만 손봤습니다. 그림을 2프레임마다 바꿔 초당 약 12장이 되게 하고, 동작이 정점에 이른 자세에서는 2프레임 더 멈췄습니다. 14.8초짜리 테스트 구간에 그런 지점이 28곳 있었습니다. 늘어난 프레임 수만큼 가장 빠르게 움직이는 순간에서 덜어내 전체 길이는 유지했고, 춤 동작도 여전히 원래 음악의 박자에 맞췄습니다.
수정 후 멈추는 지점은 선명해졌지만 다리를 들고 몸을 돌릴 때의 궤적은 여전히 모션 캡처의 궤적이었습니다. 다리를 들어 차는 동작을 예로 들면, 리듬을 고친 뒤 다리가 최고점에서 2프레임 더 머무르지만 다리가 올라가는 경로는 여전히 모션 캡처 배우의 경로입니다. 손그림 애니메이션은 큰 동작 전에 반대 방향으로 살짝 움츠리고, 정점의 자세도 실제 사람보다 과장해서 그립니다. 이 두 가지를 구현하려면 인형의 관절 데이터를 직접 수정해야 하는데, 이번에는 건드리지 않았습니다.
전체 버전에는 문제가 하나 더 있었습니다. Wan이 처음부터 끝까지 이어 그리게 했더니 앞 숏의 카메라 구도가 다음 숏으로 넘어갔습니다. 원래 위에서 아래로 찍은 숏은 화면이 가까워져 근경이 됐고, 머리만 찍은 클로즈업은 멀어져 전신숏이 됐습니다. 동작은 맞았지만 카메라 구도가 어긋났습니다.
인형에서 리듬은 고칠 수 있습니다. 모션 캡처 같지 않게 만들기 위해 필요한 나머지 절반은 움직임 궤적과 자세에 있는데, 이번에는 아직 손대지 않았습니다.
추가 실험: 직접 짠 춤을 같은 콘티로 세 모델에 주기
1단계에서는 AI가 음악을 들으며 자유롭게 춤췄고, 2~4단계에서는 만화, 손그림, 애니메이션을 따라 했습니다. 마지막에는 다른 방식으로 시험했습니다. 어떤 원작도 따르지 않고 26.5초짜리 스트리트 댄스를 직접 짰습니다. 카메라 구도, 동작, 컷 지점을 콘티에 미리 정해 두고 같은 콘티를 Grok Imagine, MiniMax H3, Seedance 2.5에 줘 얼마나 지키는지 봤습니다.
음악은 작가의 손그림 영상에 쓰인 원곡을 그대로 사용했고 측정한 속도는 129.2 BPM이었습니다. 2.32초에 드럼이 들어오고, 9.78초에 심벌즈가 한 번 울리며, 24.6초에 에너지가 가라앉습니다. 5개 숏으로 나눠 숏당 평균 5.3초로 잡았고, 컷 지점은 모두 마디의 첫 박자에 맞췄습니다. 동작은 스트리트 댄스에서 흔한 것들로 골랐고 이름도 댄서들이 쓰는 표현입니다. chest pop은 가슴을 앞으로 튕기는 동작, toprock은 선 채로 밟는 스텝, six-step은 두 손으로 바닥을 짚고 다리를 몸 주위로 한 바퀴 돌리는 동작입니다. 숏마다 카메라 구도를 바꿨습니다.
| 숏 | 시간(초) | 카메라 구도 | 동작 |
|---|---|---|---|
| 1 | 0–4.2 | 전신, 정면, 고정 | 박자를 들으며 고개를 끄덕이고 드럼이 들어올 때 chest pop, 이어서 two-step |
| 2 | 4.2–9.8 | 허리 위, 사선 앞쪽, 천천히 줌인 | 연속 chest pop, arm wave, body roll 뒤 카메라를 가리킴 |
| 3 | 9.8–15.3 | 전신, 로우 앵글, 회전 | 심벌즈가 울릴 때 뛰어올랐다 착지하고 Running Man, Roger Rabbit, 한 바퀴 돌기 |
| 4 | 15.3–20.9 | 전신, 위에서 내려다봄 | toprock, 바닥으로 내려가기, six-step |
| 5 | 20.9–26.5 | 무릎 위, 로우 앵글, 줌인 | 바닥에서 돌며 일어나 arm hit 두 번, 24.6초에 팔짱 낀 채 마지막까지 정지 |
캐릭터는 이오리로 바꿨습니다. GPT에 컬러 만화 표지 두 장을 참고해 캐릭터 이미지, 네 방향 시트, 세부 이미지 등을 그리게 했습니다. 배경은 아무것도 없는 순백색 공간으로 바꾸고 세 모델이 공통으로 쓸 시작 이미지 5장도 만들었습니다. 콘티, 음악, 시작 이미지는 같았지만 모델마다 그것을 받는 방식이 달랐습니다. 아래에서 하나씩 설명하겠습니다. 실제 비교 대상은 모델 세 개만이 아니라 방법 세 가지입니다.
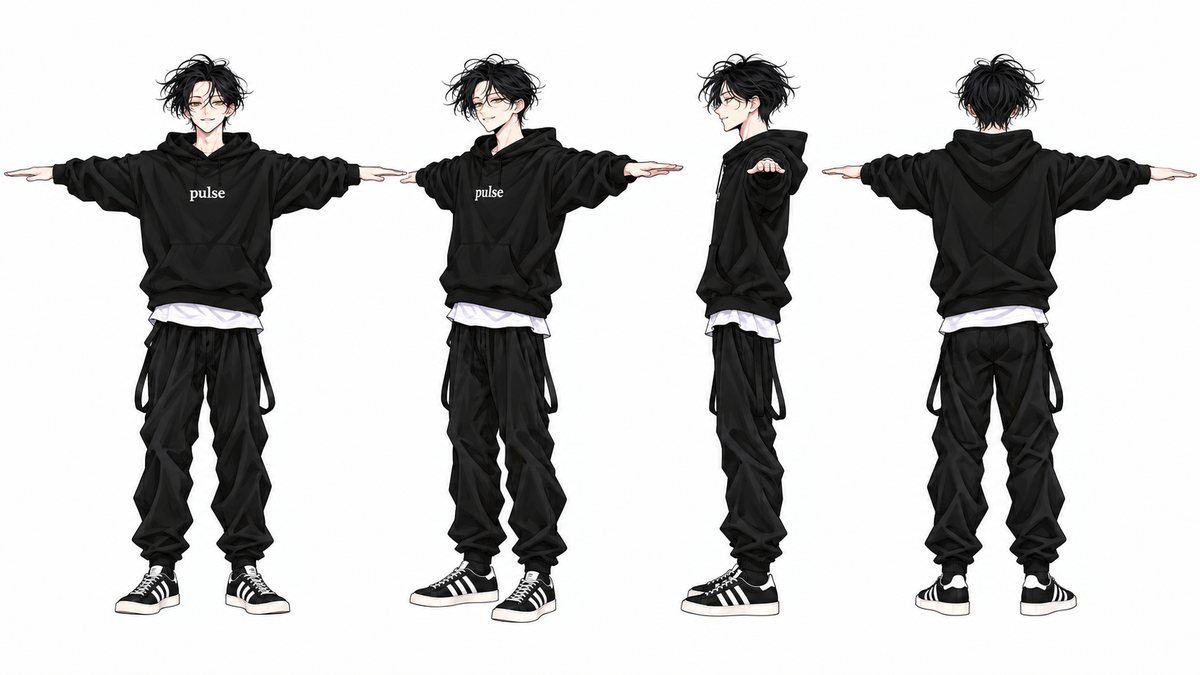
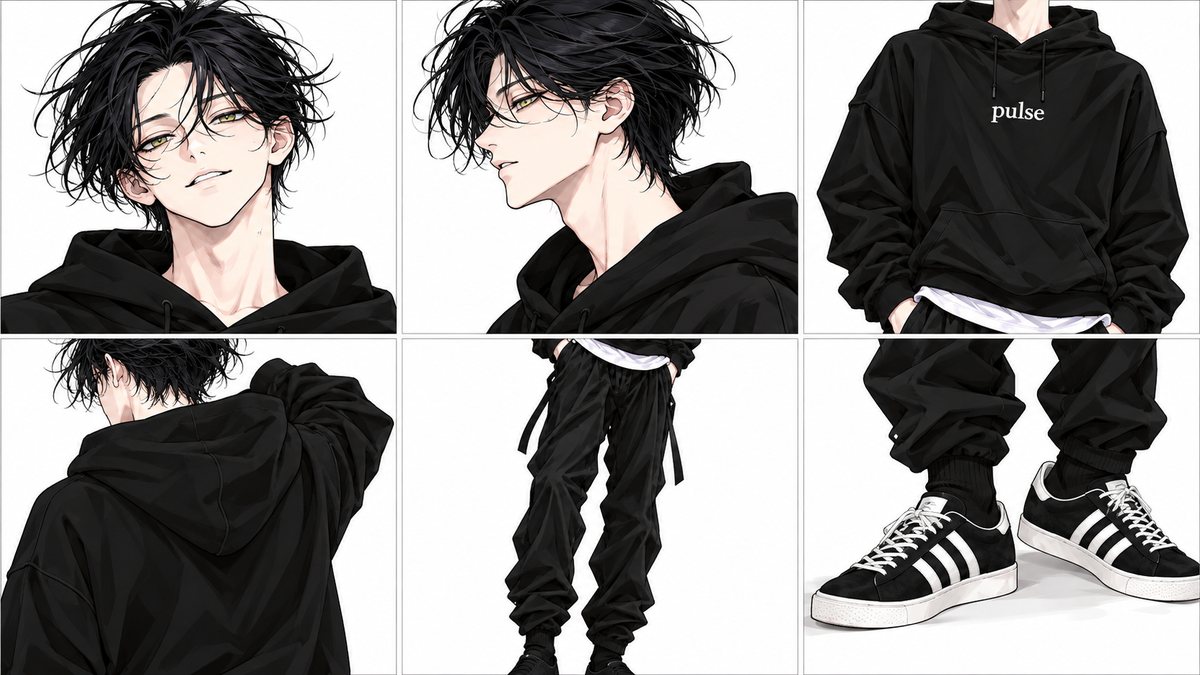
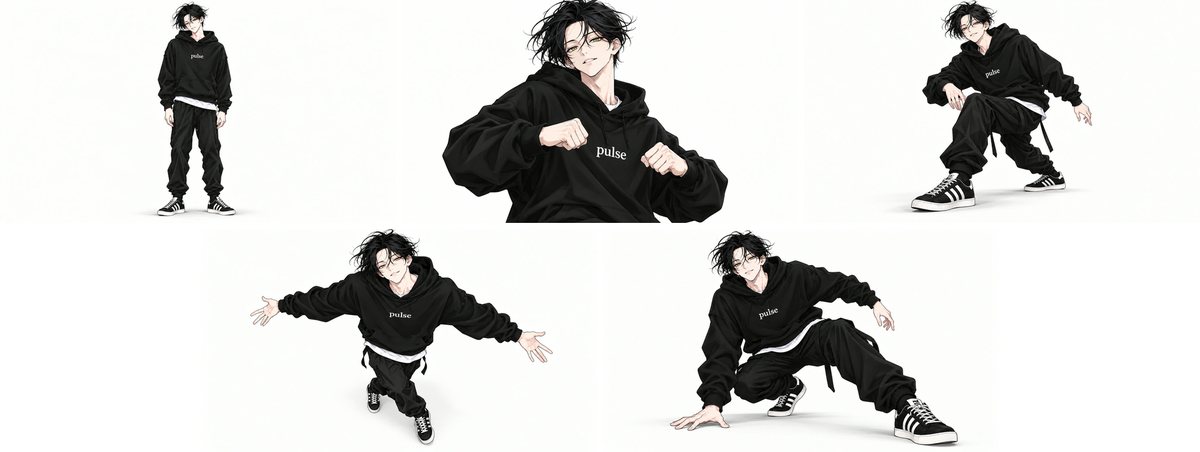
세 모델은 각각 뚜렷한 강점과 문제점이 하나씩 있었습니다.
- Grok Imagine 시작 이미지를 첫 프레임으로 바로 사용해 구도가 시작 이미지와 가장 비슷했습니다. 생성할 때는 음악을 듣지 못했고, 음악은 편집을 마친 뒤 입혔습니다. 허리 위로 잡은 숏에서는 춤추는 도중 카메라가 멋대로 멀어져 전신숏이 됐습니다. Running Man과 six-step을 추는 두 숏에서는 동작에 힘이 없어 재활 운동처럼 보였습니다.
- MiniMax H3 캐릭터 이미지, 얼굴 클로즈업, 시작 이미지, 해당 숏의 음악을 동시에 받아 음악을 들으며 춤췄고, 카메라 구도도 가장 안정적으로 지켰습니다. 문제는 참고 이미지를 영상에 그려 넣는다는 점입니다. 네 방향 시트가 캐릭터 양옆의 반투명한 분신이 됐고 시작 이미지는 잔상으로 남았습니다. 네 방향 시트를 빼고 두 숏에서는 시작 이미지를 첫 프레임으로 바로 사용한 뒤에야 화면이 깨끗해졌습니다.
- Seedance 2.5 이 모델도 음악을 듣고 춤췄으며 세 모델 중 동작 폭이 가장 컸습니다. 다만 ‘시작 이미지를 첫 프레임으로 고정’하는 기능과 ‘참고 음악’ 기능을 동시에 쓸 수 없었습니다. 저는 음악을 택해 시작 이미지는 참고용으로만 줬습니다. 그 결과 순백색 배경을 유지하지 못해 한 숏은 벽 모서리에 그림자가 있는 연회색 방으로 그렸습니다. 첫 시도에서는 arm wave도 팔 뒤에 빛나는 궤적을 남기는 모습으로 그렸습니다.
어디까지 됐고 무엇이 남았나
2026년 10월까지 직접 시험한 결과를 정리하면 다음과 같습니다.
- 가능한 것: 음악을 들으며 춤추기, 핵심 자세를 연결하고 카메라를 함께 움직이기, 춤은 그대로 두고 캐릭터 바꾸기, 애니메이션 화면과 손그림 선화에서 3D 인형 추출하기, 두 모델의 장점을 절반씩 얻도록 이어 쓰기, 콘티에 따라 카메라 구도 바꾸기
- 안 되는 것: 이름과 음악만으로 원작의 그 춤 재현하기, 손그림의 끊어지는 리듬 그대로 옮기기, 계속 이어 그리면서 각 숏의 카메라 구도 유지하기, 모든 숏에서 콘티에 적은 구도 지키기, 참고 이미지를 화면에 그리지 않고 참고용으로만 사용하기
- 아직 시험하지 않은 것: 인형의 관절 데이터를 직접 수정해 모션 캡처의 움직임 궤적을 손그림처럼 고치기
- 비용: 3, 4단계의 전체 버전은 합쳐서 71.5초였고, RTX 3090 한 장으로 약 8시간이 걸렸습니다. 대략 하루 근무 시간입니다.
이번에 가장 확실히 얻은 것은 작업 순서입니다. 먼저 동작을 3D 인형으로 바꿔 모델에 넘겨 캐릭터를 바꾸고, 동작을 고치고 싶다면 인형에서 고칩니다.
복사해서 AI Agent에 주세요
아래 내용을 AI에 붙여 넣고 가지고 있는 춤 영상과 캐릭터 이미지를 대조하게 하세요.
더 읽어 보기
| 자료 | 중요한 이유 |
|---|---|
| Hinata 〈《絕妙舞步》가 《絕望舞步》로〉(YouTube Short) | 이 글의 출발점. 애니메이션의 모션 캡처 춤과 작가의 손그림을 나란히 놓아 차이가 한눈에 보입니다. |
| 코히의 손그림 애니메이션 원본 게시물(X) | 3단계에서 비교한 원작. 2프레임 촬영과 스미어 프레임이 모두 이 영상에 있습니다. |
| CBR, 2025년 10월 | 같은 춤 장면이 손그림과 3D 사이를 오가며 흐름이 끊긴다고 지적합니다. |
| AniTrendz, 2026년 1월 | 3D 캐릭터의 얼굴이 거의 굳어 있고 눈에 생기가 없다고 지적합니다. |
음악과 영상 저작권
이 글의 스크린샷, 영상 장면, 음악은 모두 원 권리자에게 귀속됩니다. 여기서는 실험 결과를 설명하기 위해서만 인용했습니다. 권리자가 삭제를 원하시면 댓글로 알려 주세요.
| 종류 | 작품과 권리자 | 사용한 곳 |
|---|---|---|
| 음악 | Jazztronik 〈Samurai〉 | 작가 코히의 두 번째 손그림 애니메이션에 사용된 음악. 3단계 영상 4개, 2단계의 카메라 구도 버전과 추가 실험의 세 모델 비교 영상에는 이 곡을 오디오 트랙으로 사용했습니다. 1단계의 H3 영상 2개와 2단계의 촘촘한 키프레임 영상 2개에는 생성 입력으로 사용했고, 오디오 트랙은 H3가 이를 바탕으로 생성한 것입니다. |
| 손그림 애니메이션 | 코히(X: @ccffeee) | 3단계의 동작 원본. 원작은 X 공식 임베드로만 재생했고 변환하거나 따로 저장하지 않았습니다. |
| TV 애니메이션 | 《원댄스》 제5화 ©珈琲・講談社/ワンダンス製作委員会 | 4단계의 스크린샷, 동작 원본, 나란히 놓은 원본 영상 장면. 4단계 전체 버전의 오디오 트랙도 이 원음에서 가져왔습니다. |
| 만화 | 코히 《원댄스》 제7화(고단샤) | 1, 2단계의 콘티 스크린샷 |
| YouTube Short | Hinata 〈《絕妙舞步》가 《絕望舞步》로〉 | 계기 부분의 스크린샷 |