絕妙舞步變絕望舞步,
AI 救得回來嗎?
四層測下來,AI 能照音樂跳、能把關鍵姿勢連起來、能把一段舞換到另一個角色身上;把動捕的怪動作修好,這次還沒做到。
起因:一支把動畫和手繪放在一起比的 Short
實驗日期:2026 年 10 月 6 日到 9 日。用到的模型:Grok Imagine、MiniMax H3、Seedance 2.5、Wan Animate 2、SCAIL-2、SAM 3D Body、SeedVR2,最後一輪的角色圖用 GPT 生圖。H3、Wan、SCAIL-2 跑在一張 RTX 3090 上,Grok 和 Seedance 走雲端。這些模型改版很快,下面的結論以這幾天的版本為準。每支影片都標了「用哪個模型、怎麼做的」。
《ワンダンス》(Wandance,台灣譯名《絕妙舞步》)是一部講高中生跳街舞的漫畫,2025 年秋天改編成動畫。動畫的舞蹈段落用 3D 動作捕捉(真人跳一次、電腦記錄動作,再套到 3D 角色上)製作。
我是從一支 YouTube Short 知道這件事的:〈《絕妙舞步》變《絕望舞步》〉(Hinata)。影片把動畫的舞蹈和原作者珈琲自己畫的手繪動畫放在一起比,兩邊的差距一眼就看得出來。

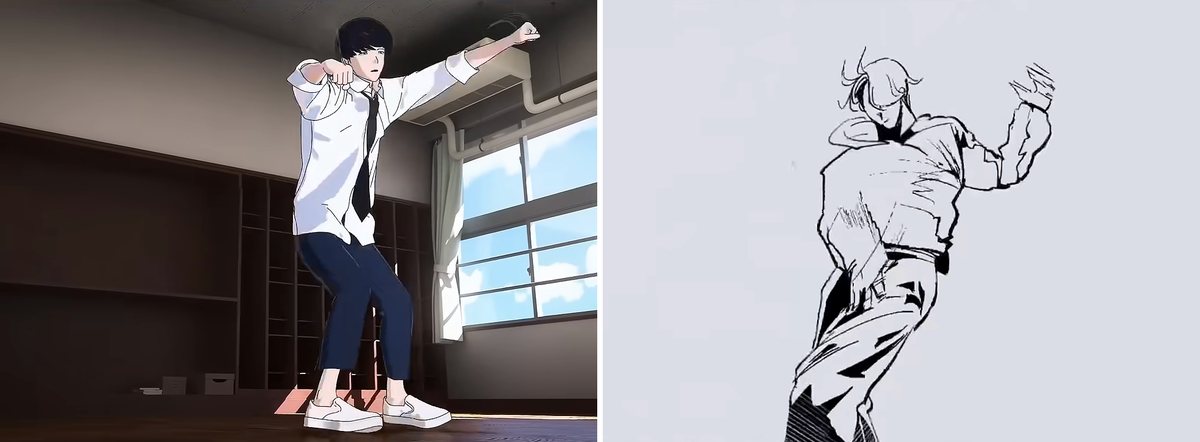
動畫的評論也點出同樣的問題。CBR 指出,同一段舞會在手繪和 3D 之間來回切換,畫面的流暢感被切斷(CBR,2025 年 10 月)。AniTrendz 寫得更直接:角色的臉幾乎是凍住的,眼睛沒有光,嘴巴像畫在娃娃上的一條線(AniTrendz,2026 年 1 月)。
看完我想知道,AI 現在能幫上多少。我把問題拆成四層,越往後給 AI 的資訊越具體:
- 只給音樂和舞步名稱,AI 能不能自己生成一段舞?
- 給漫畫分鏡當關鍵格,AI 能不能自己把動作連起來?
- 給作者的手繪動畫,AI 能不能讓彩色漫畫風格的角色照著跳?
- 給動畫本身,AI 能不能把詭異的動捕修好?
文中的角色圖是我照官方設定和漫畫彩色封面請 AI 畫的,屬於同人性質的設計,不是官方素材。
開工前還踩了一個坑:認錯角色。Short 裡放的動畫片段是主角小谷花木,作者手繪跳舞的卻是另一個角色厳島伊折,兩段並排放,我就以為作者畫的也是花木。前三層做了一輪才發現服裝和地板動作都對不上,換成伊折的官方設定才吻合。所以後面每一層都有花木和伊折兩套,有幾支對照是「花木跳伊折的舞」。
四層前後試了十幾種做法,結論先講:每一層 AI 都做得出東西,卻沒有一層做到我想要的樣子。
先看結論:四層一張表
四層的差別在給 AI 多少資訊,表格列出每一層最好的做法和卡住的地方,後面每一節展開一層;最後一列是加碼的一輪,不照原作、自己編舞。
| 層 | 給 AI 什麼 | 最好的做法 | 做到什麼 | 卡在哪 |
|---|---|---|---|---|
| 1 | 音樂+舞步名稱 | H3+照拍子寫的舞步表+原片音樂一起輸入 | 聽著音樂跳、照表做出大動作 | 跳的是「一段舞」,不是原作那段 |
| 2 | 漫畫分鏡 | 照分鏡鏡位重畫 7 張關鍵格,H3 一鏡到底補中間 | 姿勢都經過、鏡頭會跟著移動 | 關鍵格越多越像擺 pose;分鏡之間的時間要自己編 |
| 3 | 作者手繪動畫 | 線稿轉 3D 人偶 → SCAIL-2 → Wan 重畫 | 姿勢對得上作者 | 作者一拍二的頓挫感沒了 |
| 4 | 動畫本身 | 動畫轉 3D 人偶 → Wan → 修節奏 | 換了人、頓點變清楚 | 動捕的弧線沒修到;鏡位跑掉 |
| 加碼 | 音樂+自編分鏡+開場圖 | H3 聽著音樂生成,兩鏡改用開場圖當第一格 | 照分鏡換鏡位、聽著音樂跳 | 參考圖會被畫進畫面;空白處冒雜物 |
整張表看下來,給得越具體,AI 照抄得越準;可是第 4 層要的是「改」,不是「抄」,那一步我這次只試到改節奏。
第 1 層:只給音樂和舞步名稱
只給文字和音樂,AI 會跟著音樂跳出一段像樣的舞,但跳的是它自己想像的舞,不是漫畫裡那一段。
漫畫裡沒有寫舞步名稱,只有舞風、曲名和旁白。花木那段我拿「HIPHOP、2Pac〈Changes〉、旁白『聽到音』」當輸入;伊折那段漫畫寫的是 HOUSE/BREAK,旁白是「頭打在節拍上」「細小的音全在腳步上」「脫力感和餘裕」。所以這一層的「舞步名稱」其實是我照旁白擬的。
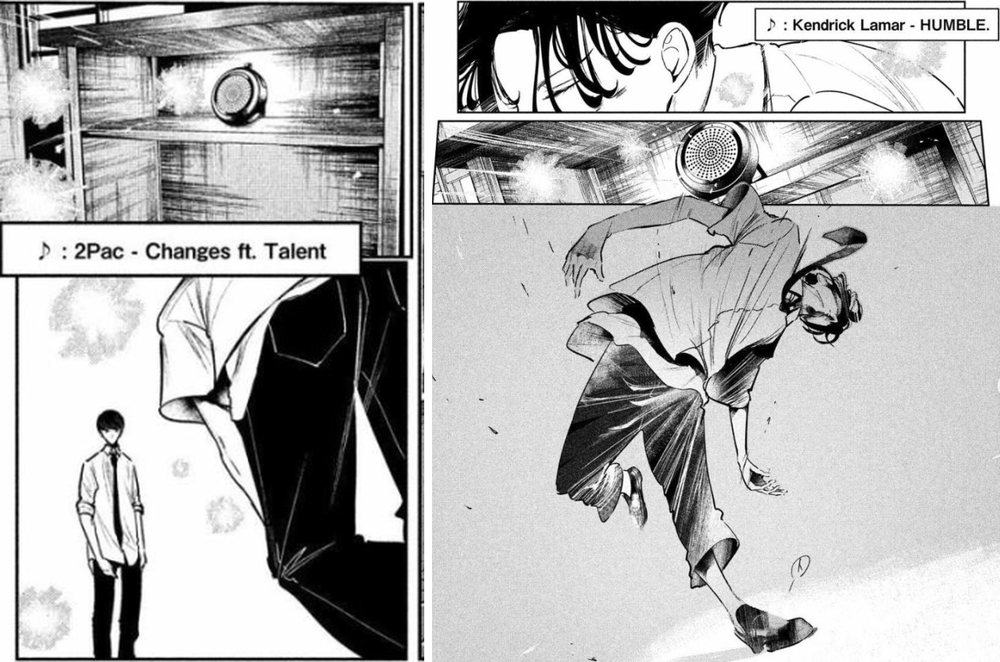
我試了兩種做法:
- Grok Imagine 只靠文字:角色和綠幕都穩,動作是一般的律動踏步,沒有漫畫裡那種低重心的大動作
- MiniMax H3+舞步表+原片音樂:我把旁白寫成按秒排的舞步表(名稱是我擬的,全是推測),再把作者原片的音樂當成輸入一起給模型
H3 這組的動作大很多。我用「最低點的身高÷站姿身高」量下蹲深度,Grok 版是 0.83,H3 版降到 0.57,寬站距重壓、抬膝、側踢、最後的深弓步都照表做了。伊折那組三個 seed 都做出了倒立 freeze。
把原片音樂一起給 H3,是這一層最有感的地方。H3 生成的影片會自帶一條音軌,我量了這條音軌:速度 129.2 BPM,跟原曲一樣,兩條音軌的起伏也對得上、沒有時間差。這證明模型確實讀進了這段音樂;舞步有沒有踩在拍點上,我沒有另外量。
只給名稱和音樂,AI 能聽著音樂、做出你列的大動作,原作那段舞是什麼樣子,它無從得知。
第 2 層:給漫畫分鏡,讓 AI 把動作連起來
把漫畫分鏡畫成關鍵格、交給影片模型補中間,AI 連得起來,但關鍵格越多越像在擺 pose,分鏡之間的時間也得自己編。
做法是先用 Grok 把每一格分鏡畫成彩漫風的角色,再讓 H3 依序經過這些姿勢。這一層踩了一個坑:直接把漫畫格當參考圖,Grok 會把格子裡被手遮住的頭照抄成第二顆頭,9 張壞了 3 張;改成只用文字描述姿勢,之後幾十張都沒有再出現第二顆頭。
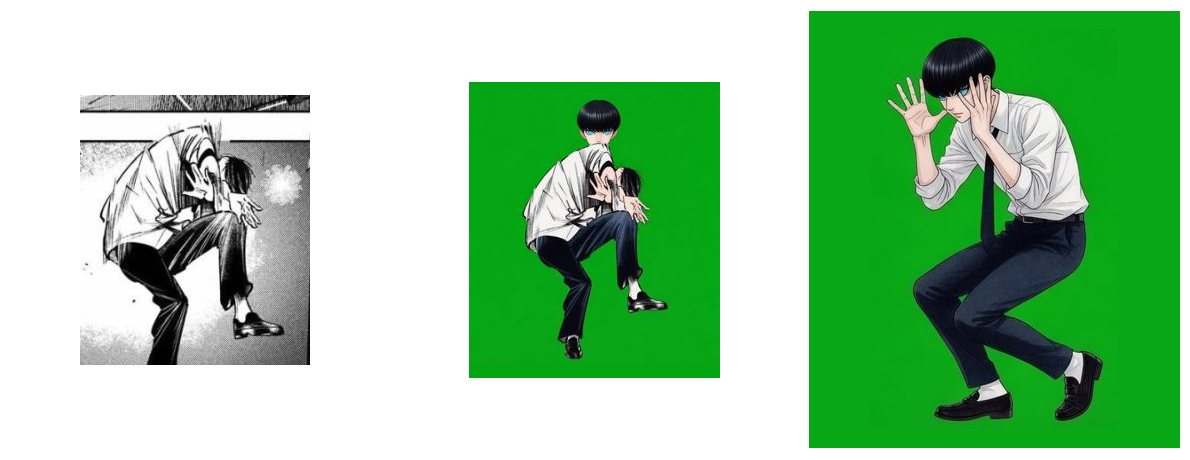
第一版我把關鍵格排得很密:9 格分鏡之間各補一張過渡姿勢,關鍵格落在拍點上停 3 格。背景因此穩了下來。可是看起來像一張一張換姿勢,動作斷斷續續。
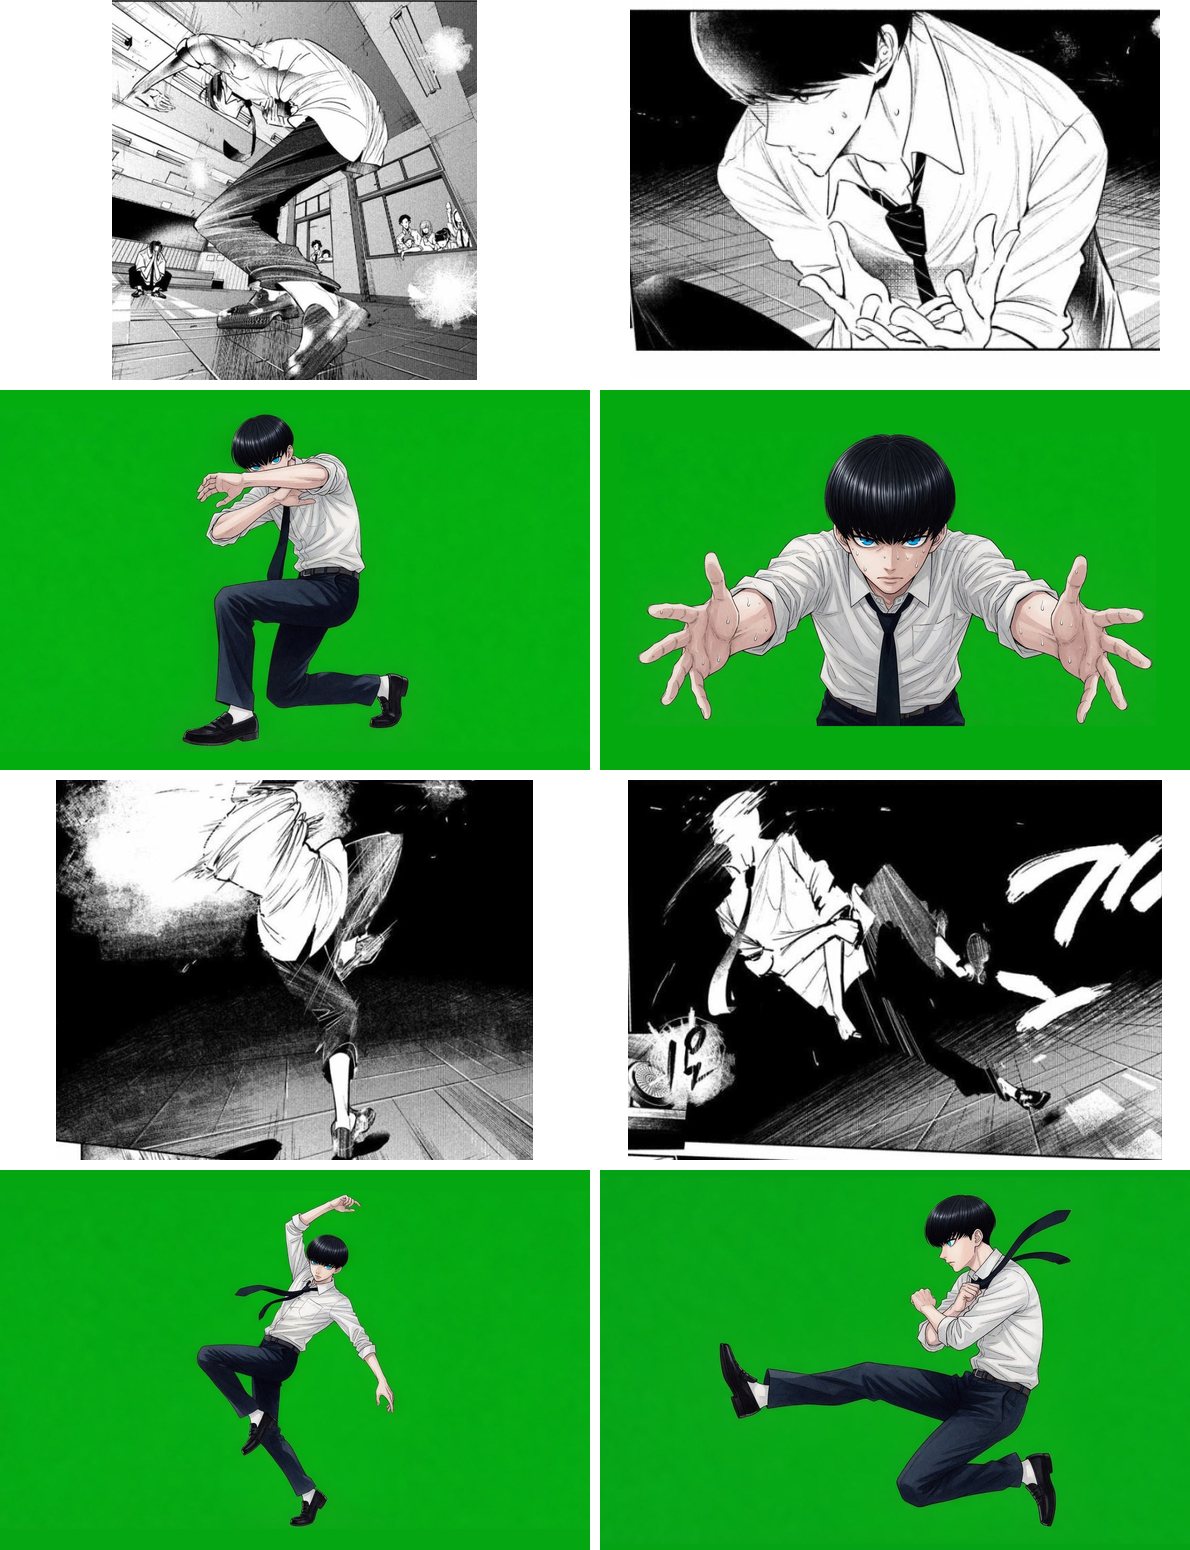
第二版反過來,只留 7 張分鏡,每張照那一格的鏡位重畫:低角度遠景、膝上中景、伸手特寫、側面全身,中間不塞過渡、不強迫定格。H3 自己移動鏡頭、推近拉遠,從伸手特寫拉回全身大約 16 格,沒有硬切。代價是大約三分之一的格跟前一格幾乎一樣:影片是每秒 24 格,扣掉重複的畫面,實際不同的畫面大約每秒 12 張,結尾的弓步也停了 3 秒,偏長。
分鏡給的是姿勢和鏡位,沒給姿勢之間怎麼動、花多久;那一段 AI 會自己補,補得順不順,跟關鍵格放多密直接相關。
第 3 層:給作者手繪,抹影格會變成多出來的手腳
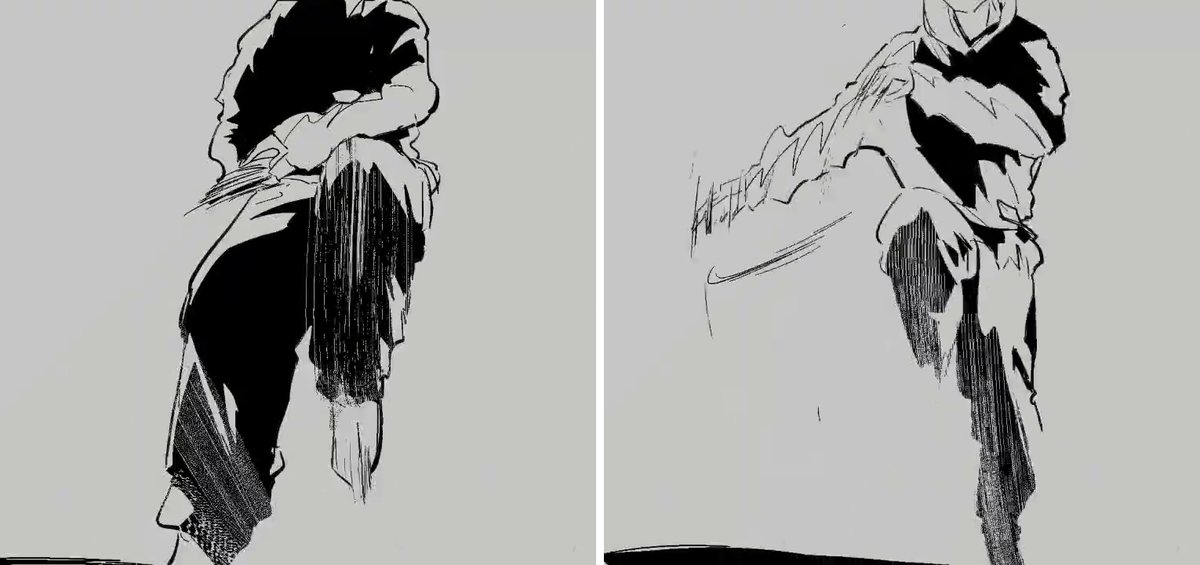
作者的手繪是一拍二,快動作的地方還夾著抹影格(一張畫裡同時畫出好幾個位置,用來表現速度)和速度線;動作轉移模型照單全收,就長出殘影和多出來的手腳。
動作轉移(motion transfer)模型的工作是:給它一張角色圖和一段跳舞影片,它讓角色照著影片跳。第一版我用 Wan Animate 2 直接讀作者的線稿,姿勢大致對,臉偶爾怪,部分動作錯。
我量過作者這支 26.5 秒的手繪:一共 325 張不同的畫,大多是一張畫停兩格(動畫業叫「一拍二」)。快動作的地方還有抹影格,一張畫裡同時畫了好幾個手的位置。對人來說那是速度感;Wan Animate 讀到的,是畫面裡真的有好幾隻手。
我試了三種補救,各自卡在不同地方:
- 先抽骨架、只給模型骨架:Wan Animate 2 不吃骨架圖。原線稿最好,骨架疊線稿次之,純骨架最差,抬腿變成站直、地板動作變成躺著飄
- 改用 H3 加骨架控制:動作只大致跟得上,畫面顆粒很重
- 每個鏡頭從角色圖重新開始:模型每段開頭都先站在角色圖的姿勢,短鏡頭整段被站姿吃掉;前面多塞 1 秒預備也救不回來
接著試了第 2 層的關鍵格法:挑 49 張作者的關鍵姿勢,請 Grok 畫成彩漫格,對齊作者墨線的位置大小,再讓 H3 補中間。每一張關鍵格都很漂亮,格與格之間卻會走樣,第 7.5 秒附近出現兩個伊折疊在一起;作者推近只拍腳的那幾格,Grok 兩次都畫成全身。同一段 12 秒,SCAIL-2 直接讀線稿的動作最貼作者,畫面卻偏糊。
抹影格裡畫了好幾個手的位置,模型就畫出多出來的手;直接讀手繪的路,到這裡走不下去。
轉折:把動作轉成 3D 人偶
從畫面直接學動作走不通之後,我換了一個中間步驟:先把畫面裡的人轉成 3D 人偶,再交給模型。
SAM 3D Body 會把畫面裡的人轉成一個灰色的 3D 身體,每一格都估出全身的關節角度;畫面外或被遮住的部位,是它推估出來的。我原本擔心它只認得真人照片,實測動畫畫面和手繪線稿都比預期好:動畫那段的跳躍、地板動作、倒立都抓得到;作者推近只拍腳的那一格,抽出來的人偶也只有腿。
踩到的坑在偵測人的那一步。一開始每一格各自找人,伊折一倒立,偵測就跳去抓窗外圍觀的同學;改成整段追同一個人之後才穩定。
3D 人偶有兩個用處:它是動作轉移模型最好讀的輸入,乾淨的身體、沒有抹影也沒有背景;它也是整條流程裡唯一能動手改動作的地方。
同一個人偶交給兩個模型,結果各有長短:Wan Animate 的畫面比較舒服,有漫畫的墨線感,偶爾腿變半透明;SCAIL-2 的動作比較準,畫風卻偏寫實的塗抹感,臉是糊的。最後的做法是接力:SCAIL-2 先照人偶畫,Wan 再照 SCAIL 的成品重畫一次,姿勢跟 SCAIL、筆觸是 Wan 的。
完整版的姿勢對得上作者:我抽 14 格,跟作者同一時刻的原畫並排用眼睛比對,每一格的姿勢都對得上,倒立和最後倒地也有;這是目測,不是程式量的。跟作者不同的是兩件事:作者換鏡的地方,這版是連續動過去;作者一拍二的頓挫感也變順了。哪一步把頓挫抹掉,我沒有逐步查,人偶的動作本身就是平滑的,是最可能的原因。
第 4 層:給動畫本身,修動捕
動作轉移模型只會照抄,所以直接拿動畫片段去讀,詭異的感覺會原封不動地留下來;要修,只能在 3D 人偶上改。
最早的兩個嘗試都在畫面層:Wan Animate 2 忠實讀動畫片段,以及先把動畫的節奏改掉再讀。忠實版把動作連同詭異感一起帶了過來;改時間版在花木那支插了 4 次停格,生成後只量得到 1 次,其餘被模型抹平。SCAIL-2 直接讀動畫則多了一個問題,把教室和窗外圍觀的同學一起畫進了背景。
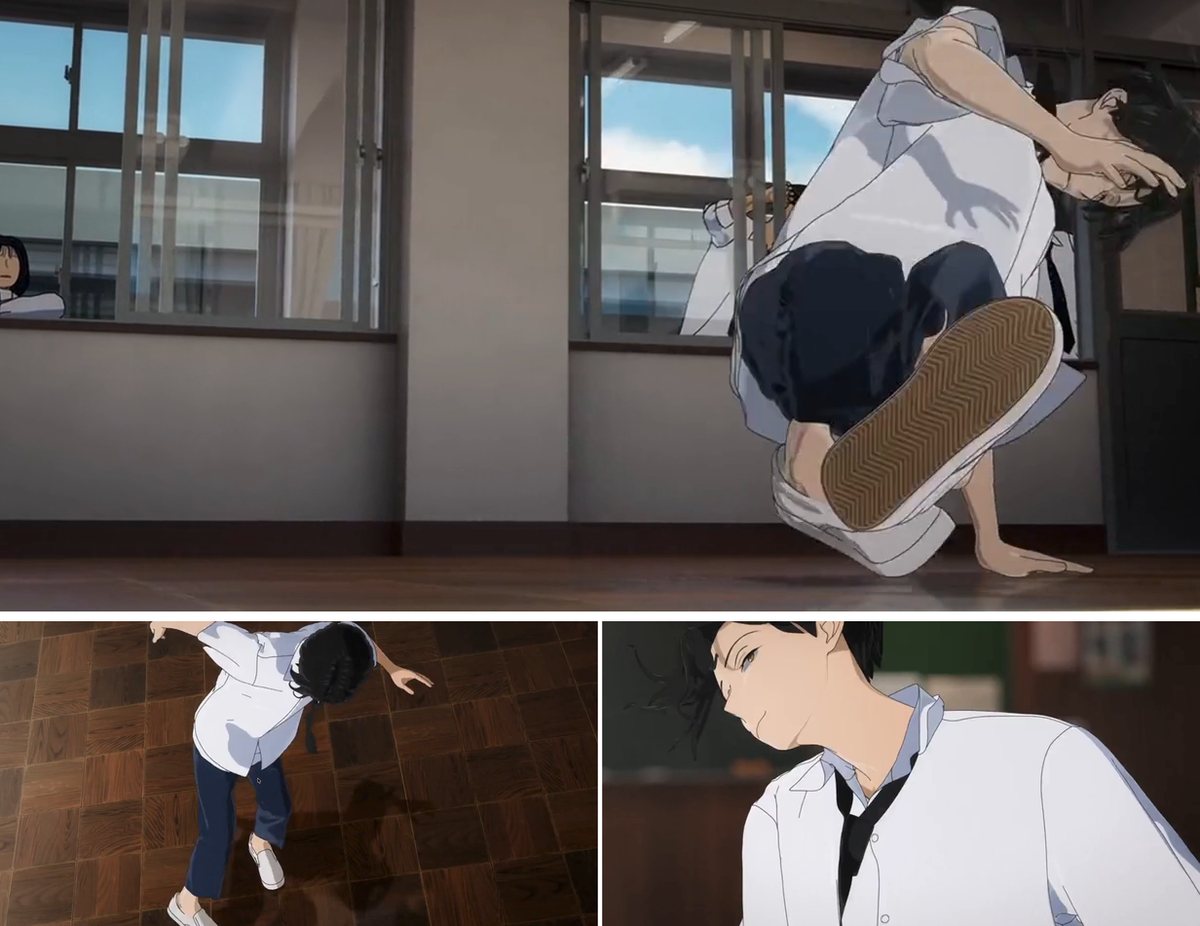
改走 3D 人偶之後,我在人偶上只改了時間:每兩格換一張畫,大約每秒 12 張;動作到頂點的姿勢多停兩格,14.8 秒的測試段裡有 28 處;多出來的格數再從動作最快的瞬間抽掉,讓總長度不變、舞步仍然踩在原本的音樂上。
改完頓點變清楚了,抬腿和轉身的弧線卻還是動捕的弧線。以抬腿踢出為例:修節奏之後,腿在最高點會多停兩格,但腿抬上去的路線,還是動捕演員那一條。手繪動畫在大動作之前會先往反方向縮一下,頂點的姿勢也會畫得比真人誇張;這兩件事要直接改人偶的關節資料,這次沒有碰。
完整版還多了一個問題。我讓 Wan 從頭到尾一路接著畫,上一個鏡頭的鏡位會被帶到下一個:原本從上往下拍的鏡頭,景別被拉近成近景;原本只拍頭的特寫,被拉遠成全身。動作本身是對的,鏡位跑掉了。
節奏可以在人偶上修,讓動捕不像動捕的另一半在弧線和姿勢上,這次還沒動手。
加碼:自己編一段舞,同一份分鏡丟給三個模型
第 1 層讓 AI 聽著音樂自由發揮,第 2 到 4 層照抄漫畫、手繪或動畫;最後一輪換一種考法:不照任何原作,自己編一段 26.5 秒的街舞,鏡位、招式、切點都先寫死在分鏡裡,同一份分鏡交給 Grok Imagine、MiniMax H3、Seedance 2.5,看它們守得住幾成。
配樂沿用作者那支手繪的原曲,量得 129.2 BPM:2.32 秒鼓聲進來,9.78 秒有一下鈸,24.6 秒能量收掉。我切成 5 個鏡頭,平均一鏡 5.3 秒,切點都落在小節的第一拍。招式挑街舞常見的幾種,名稱都是舞者的慣用說法:chest pop 是胸口往前一彈,toprock 是站著踩的步法,six-step 是雙手撐地、讓腿繞身體一圈。每一鏡換一個鏡位:
| 鏡 | 時間(秒) | 鏡位 | 招式 |
|---|---|---|---|
| 1 | 0–4.2 | 全身、正面、固定 | 聽拍點頭,鼓聲進來時 chest pop,接 two-step |
| 2 | 4.2–9.8 | 腰上、斜前方、慢慢推近 | 連續 chest pop、arm wave、body roll 後指向鏡頭 |
| 3 | 9.8–15.3 | 全身、低角度、環繞 | 鈸聲時跳起落地、Running Man、Roger Rabbit、轉一圈 |
| 4 | 15.3–20.9 | 全身、俯拍 | toprock、下地、six-step |
| 5 | 20.9–26.5 | 膝上、低角度、推近 | 從地上轉起來、兩下 arm hit、24.6 秒抱胸定格到結束 |
角色換成伊折。我請 GPT 照兩張彩漫封面畫出角色圖、四視圖和細節圖,背景改成什麼都沒有的純白空間,再畫 5 張開場圖給三個模型共用。分鏡、音樂、開場圖三樣都相同,但三個模型接收它們的方式不一樣,下面逐一說明;比的其實是三種做法,不只是三個模型。
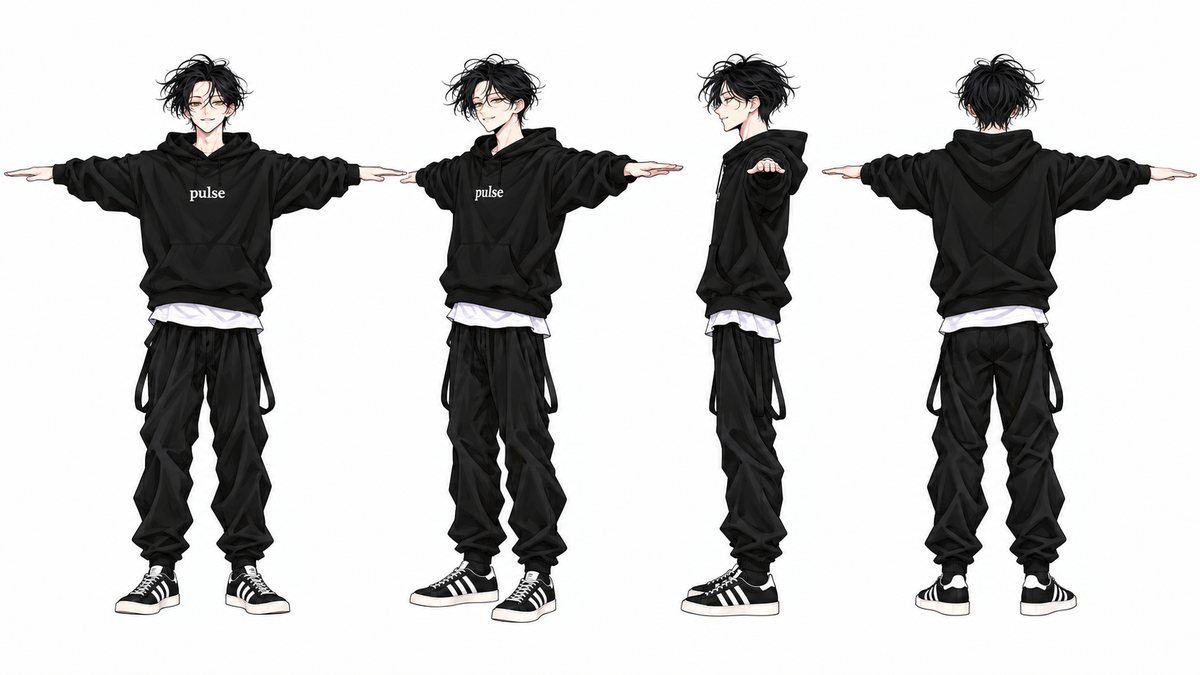
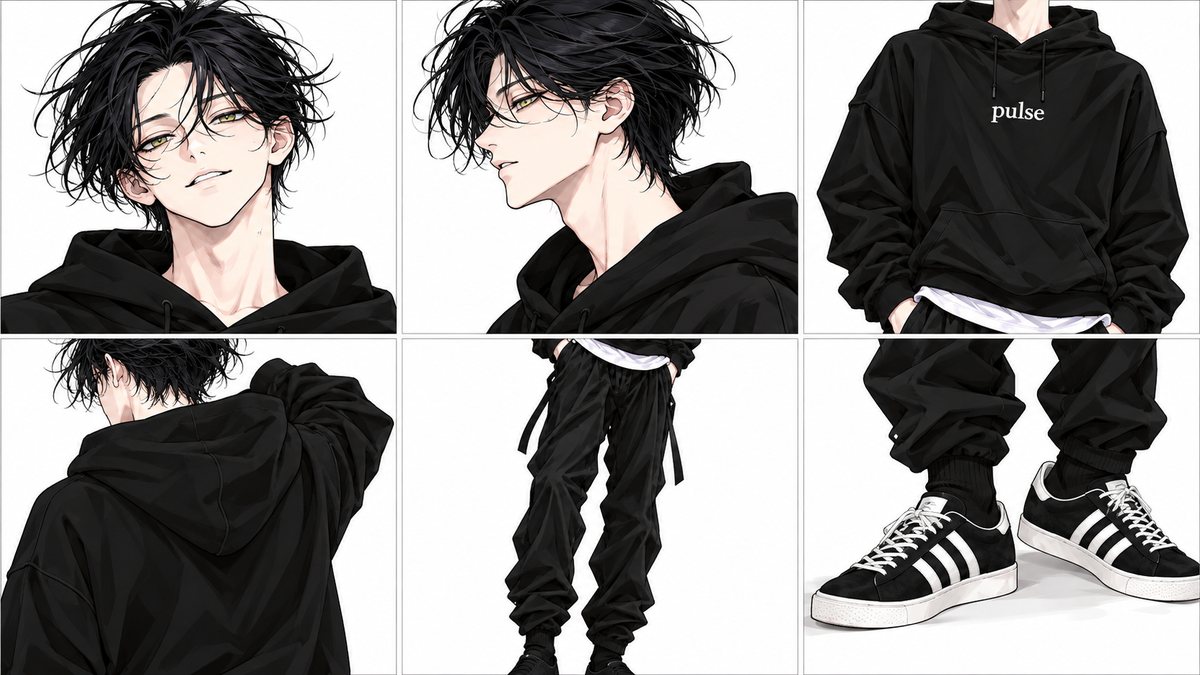
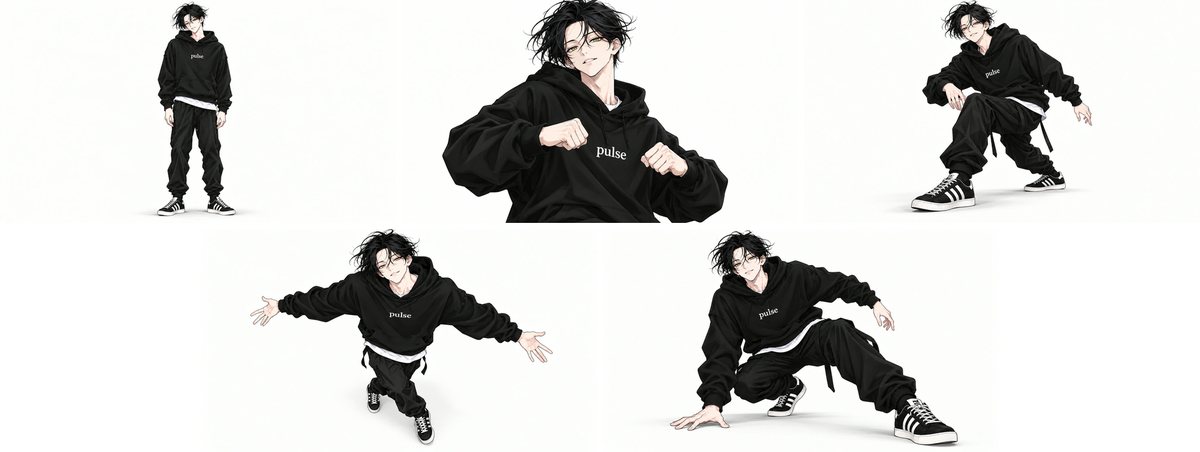
三個模型各有一個明顯的長處,也各有一個明顯的毛病:
- Grok Imagine 把開場圖直接當第一格,構圖最貼開場圖。它生成時聽不到音樂,配樂是剪完才鋪上的。腰上那一鏡跳到一半,鏡頭自己拉遠成全身;Running Man 和 six-step 那兩鏡動作軟,看起來像在做復健
- MiniMax H3 同時拿到角色圖、臉部特寫、開場圖和那一鏡的音樂,是聽著音樂跳的,鏡位也守得最穩。它的毛病是會把參考圖畫進畫面:四視圖變成角色兩側半透明的分身,開場圖留成殘影;拿掉四視圖、有兩鏡改成開場圖直接當第一格之後才乾淨
- Seedance 2.5 一樣聽音樂,動作幅度三家裡最大。它不允許「開場圖釘成第一格」和「參考音樂」同時使用,我選了音樂,開場圖只能當參考,結果純白背景守不住,有一鏡畫成帶牆角陰影的淺灰色房間。第一輪它還把 arm wave 畫成手臂拖著一道發光軌跡
做到哪、還差什麼
到 2026 年 10 月為止,我實測的結果整理如下:
- 做得到:聽著音樂跳;把關鍵姿勢連成一段,鏡頭會跟著移動;照一段舞把角色換掉;從動畫畫面和手繪線稿抽出 3D 人偶;兩個模型接力各取一半優點;照一份分鏡在不同鏡位之間切換
- 做不到:從名稱和音樂跳出原作那段舞;照搬手繪的頓挫感;一路接著畫的同時保住每個鏡頭的鏡位;每一鏡都守住分鏡寫的鏡位;只拿參考圖當參考、不把它畫進畫面
- 還沒試:直接改人偶的關節資料,把動捕的弧線修得像手繪
- 代價:第 3、4 層的完整版加起來 71.5 秒,一張 RTX 3090 跑了大約 8 小時,差不多一個上班日
這次最確定的收穫是順序:先把動作轉成 3D 人偶,再交給模型換人;想修動作,就在人偶上修。
延伸閱讀
| 資源 | 為什麼重要 |
|---|---|
| Hinata〈《絕妙舞步》變《絕望舞步》〉(YouTube Short) | 這篇的起點:動畫的動捕舞蹈和作者手繪並排,差距一眼就看得出來 |
| 珈琲的手繪動畫原帖(X) | 第 3 層拿來比對的原作,一拍二和抹影格都在這支裡 |
| CBR,2025 年 10 月 | 點出同一段舞在手繪和 3D 之間來回切換,流暢感被切斷 |
| AniTrendz,2026 年 1 月 | 點出 3D 角色的臉幾乎凍住、眼睛沒有光 |
音樂與影像版權
文中的截圖、片段和配樂都屬於原權利人,這裡只為說明實驗結果而引用。權利人若希望移除,請留言告知。
| 類型 | 作品與權利人 | 用在哪 |
|---|---|---|
| 音樂 | Jazztronik〈Samurai〉 | 作者珈琲手繪動畫第 2 支的配樂。第 3 層四支、第 2 層的鏡位版和加碼的三模型比較,音軌就是這首歌;第 1 層 H3 兩支和第 2 層密排兩支拿它當生成的輸入,音軌是 H3 照它生成的 |
| 手繪動畫 | 珈琲(X:@ccffeee) | 第 3 層的動作來源;原作只用 X 官方嵌入播放,沒有轉檔或另存 |
| TV 動畫 | 《ワンダンス》第 5 集 ©珈琲・講談社/ワンダンス製作委員会 | 第 4 層的截圖、動作來源和並排的原片片段;第 4 層完整版的音軌取自這段原聲 |
| 漫畫 | 珈琲《ワンダンス》第 7 話(講談社) | 第 1、2 層的分鏡截圖 |
| YouTube Short | Hinata〈《絕妙舞步》變《絕望舞步》〉 | 起因那一節的截圖 |