分享自製換裝娃娃
從一張設計圖到 3D
跟 Opus 5.5 協作測出來的工作流:用 ChatGPT、Tripo、Blender 和 three.js,把一張設計圖做成能在瀏覽器裡換裝、跳舞、說四種語言的 3D 換裝娃娃。每一步附做法、驗收標準和原因。
一張設計圖,十個步驟

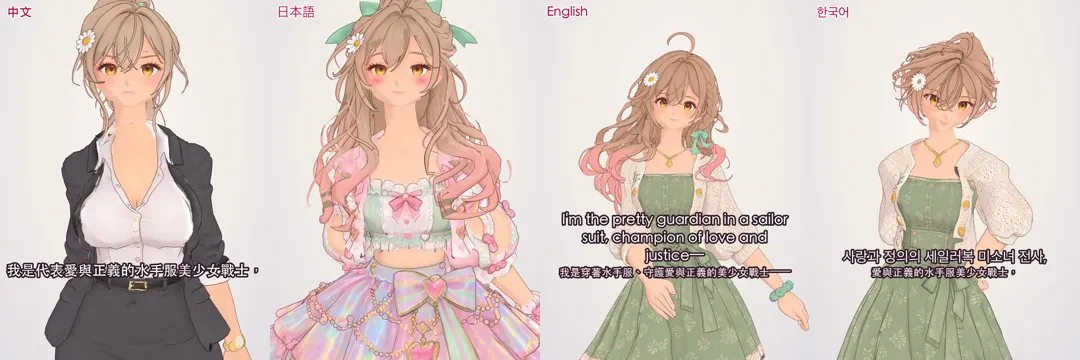
影片裡是陽菜 Hina,四種造型各講一種語言:OL 套裝配生氣講中文,偶像服配害羞講日文,短髮講韓文,原本的造型講英文。她是一個 3D 換裝娃娃,存成 VRM(3D 角色常用的檔案格式),從一張 ChatGPT 畫的設計圖開始,2026-09-29 開工,10-05 做完公開版;中間 Claude Code 的額度用完,停了幾天。
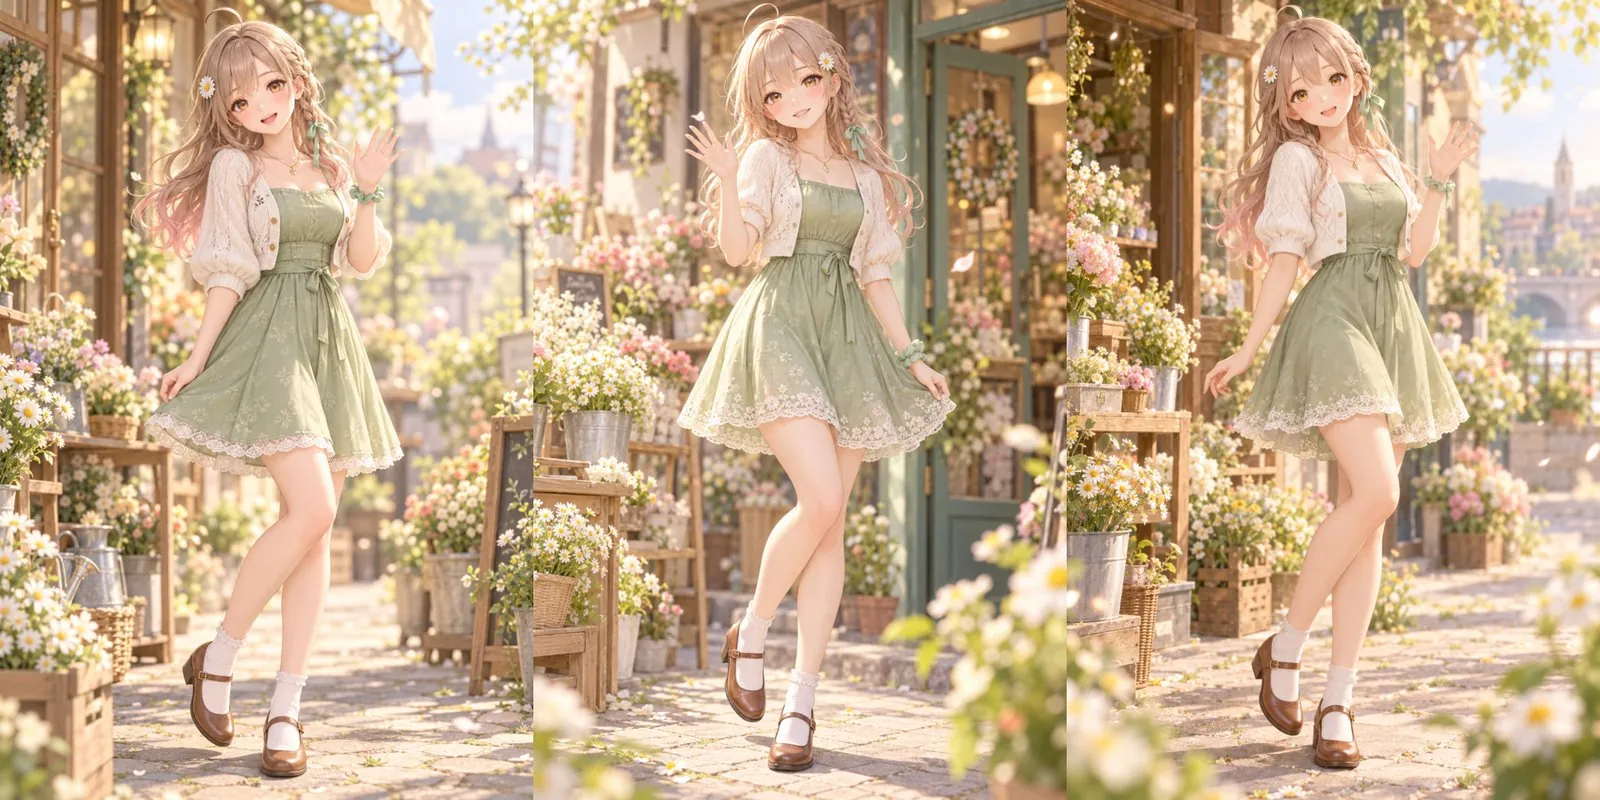
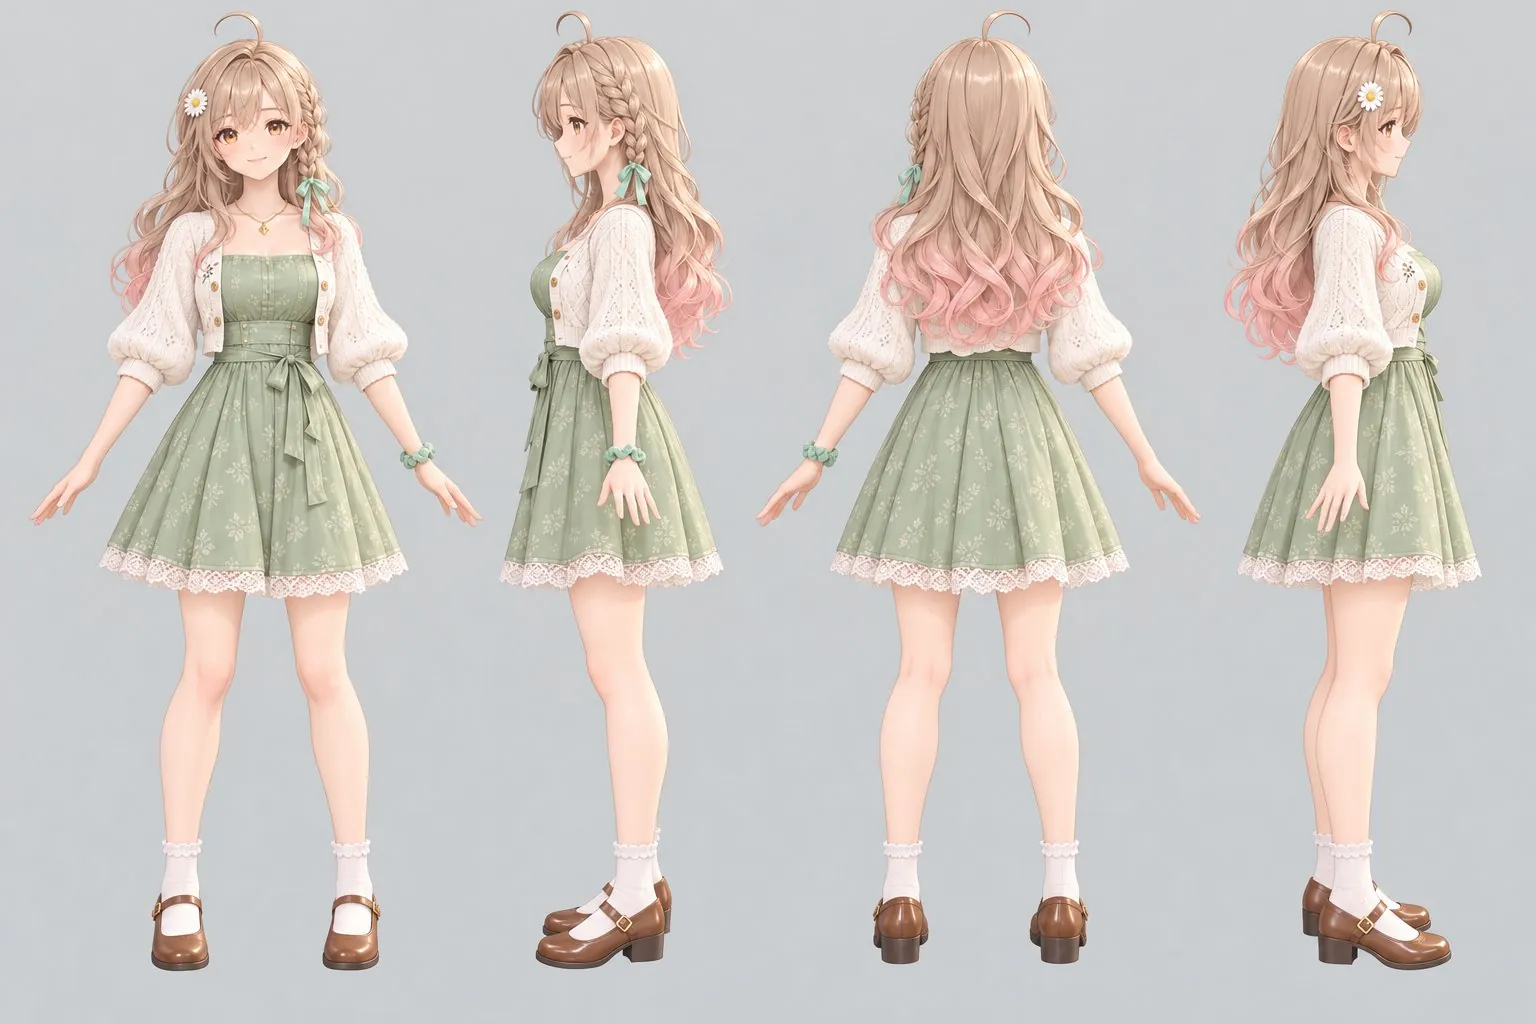
整個專案我都是跟 Opus 5.5 對話完成的。這篇把測出來的做法整理成十個步驟,每一步分三格:
- 做法:照著做的步驟
- 驗收:可以量的標準
- 為什麼:測試時遇到什麼,才定成這樣
用到的工具:ChatGPT(設計圖、四視圖)、Tripo(3D 生成、自動綁骨)、Blender(組裝和修正)、three.js 和 three-vrm(網頁算繪)、ElevenLabs(聲音)、wav2vec2(對嘴)、Mixamo(動作)。
我看圖拍板,Opus 5.5 動手
分工第一天就定好,之後沒改過:
- 我:決定設計方向;每一步結束看圖,決定過不過;每次花 Tripo 點數前核可;帳號登入和付款
- Opus 5.5:寫 Blender、量測和網頁的程式,在背景跑 Blender;操作 ChatGPT 和 Tripo 的網頁;每一步產出比對圖給我看
看圖有兩條規則:
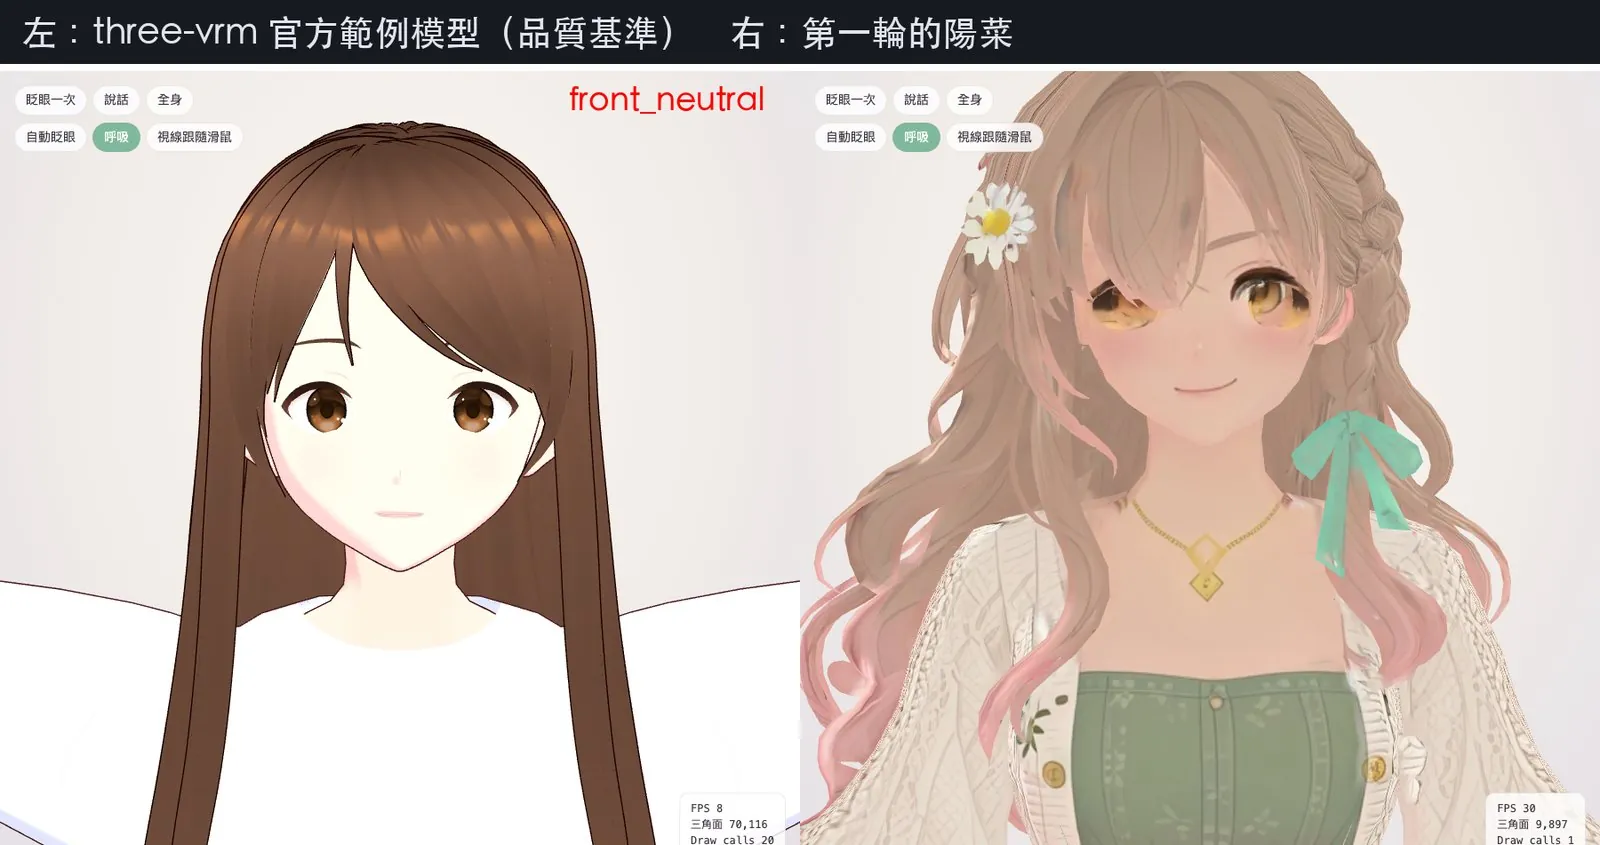
- 驗收圖至少 1024 px,臉另外裁一張放大圖
- 臉要看正面、左右 30°、正側面四個角度
為什麼
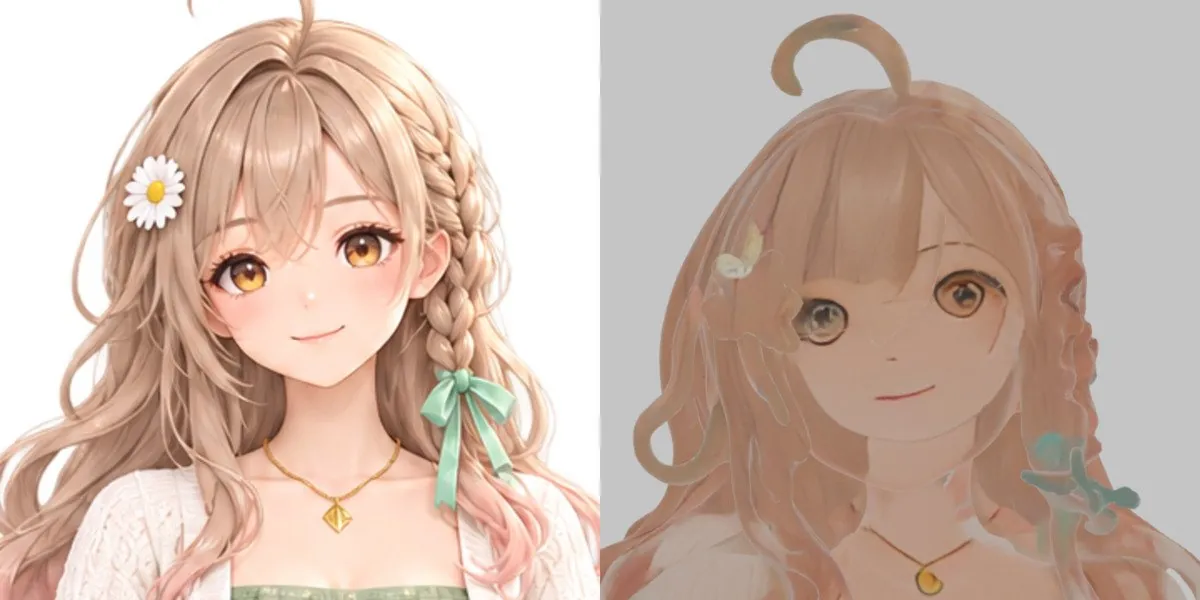
第一輪我想用一張設計圖直接生成整隻模型,這太異想天開了:生出來的模型面數不夠,細節也不足。所以後來改成頭、頭髮、身體分開生成,最後再合併。
畫三組四視圖
做法
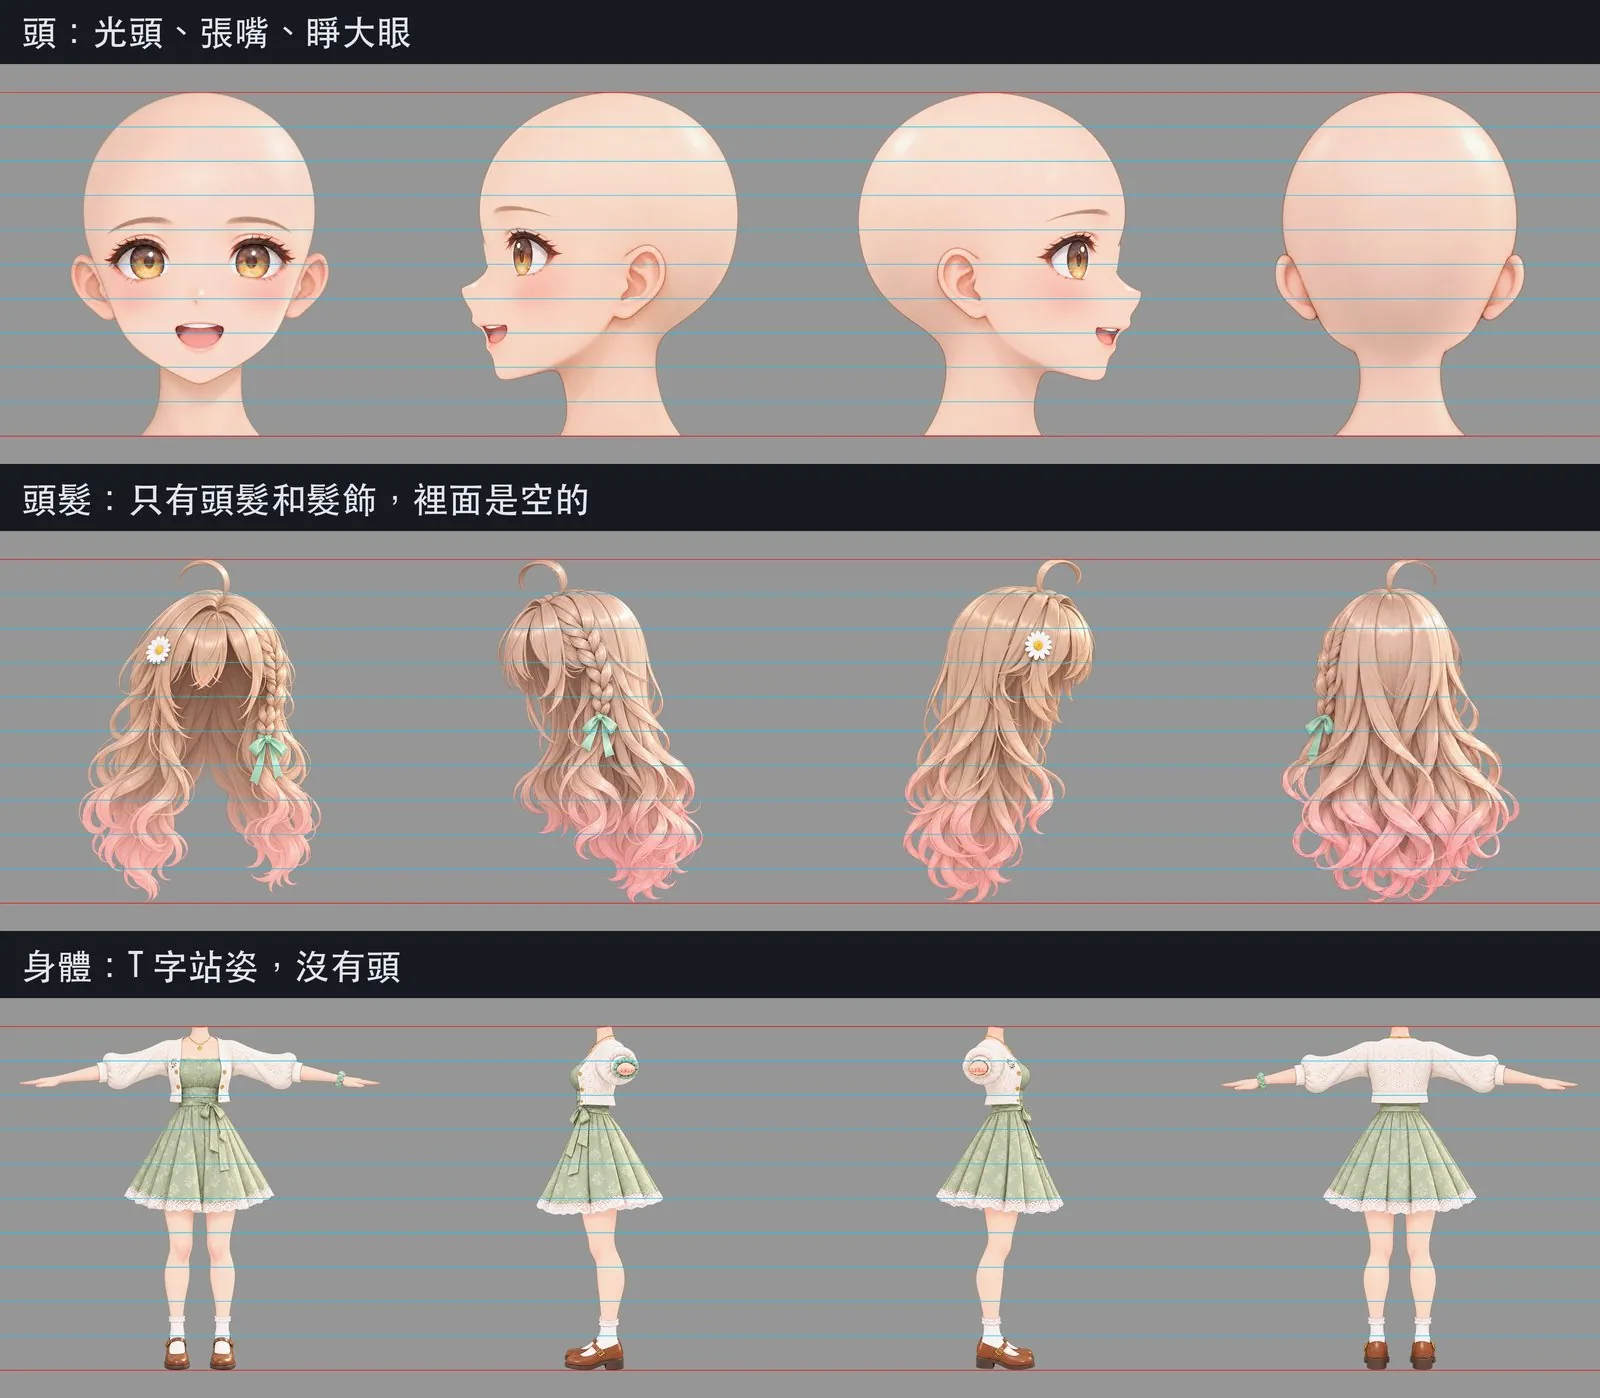
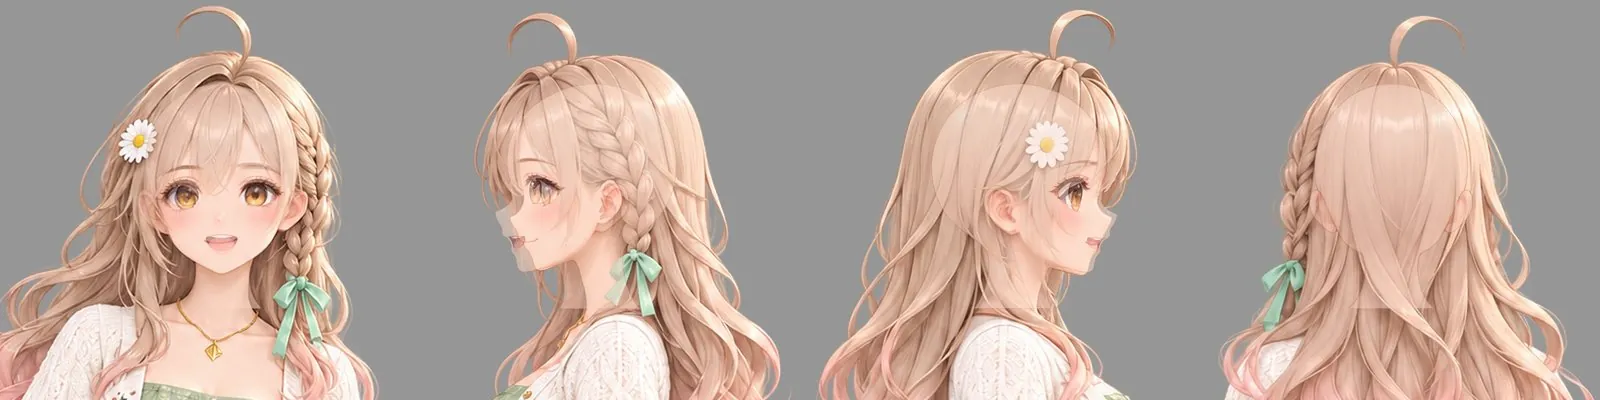
- 請 ChatGPT 畫三組四視圖(正面、左、右、背面):
- 頭:光頭,露出耳朵;眼睛睜大,看得到整個虹膜;嘴巴張成「啊」,看得到上排門牙和舌頭;脖子在鎖骨上方切平
- 頭髮:只有頭髮和髮飾,裡面是空的
- 身體:T 字站姿;脖子切在跟頭同一個高度
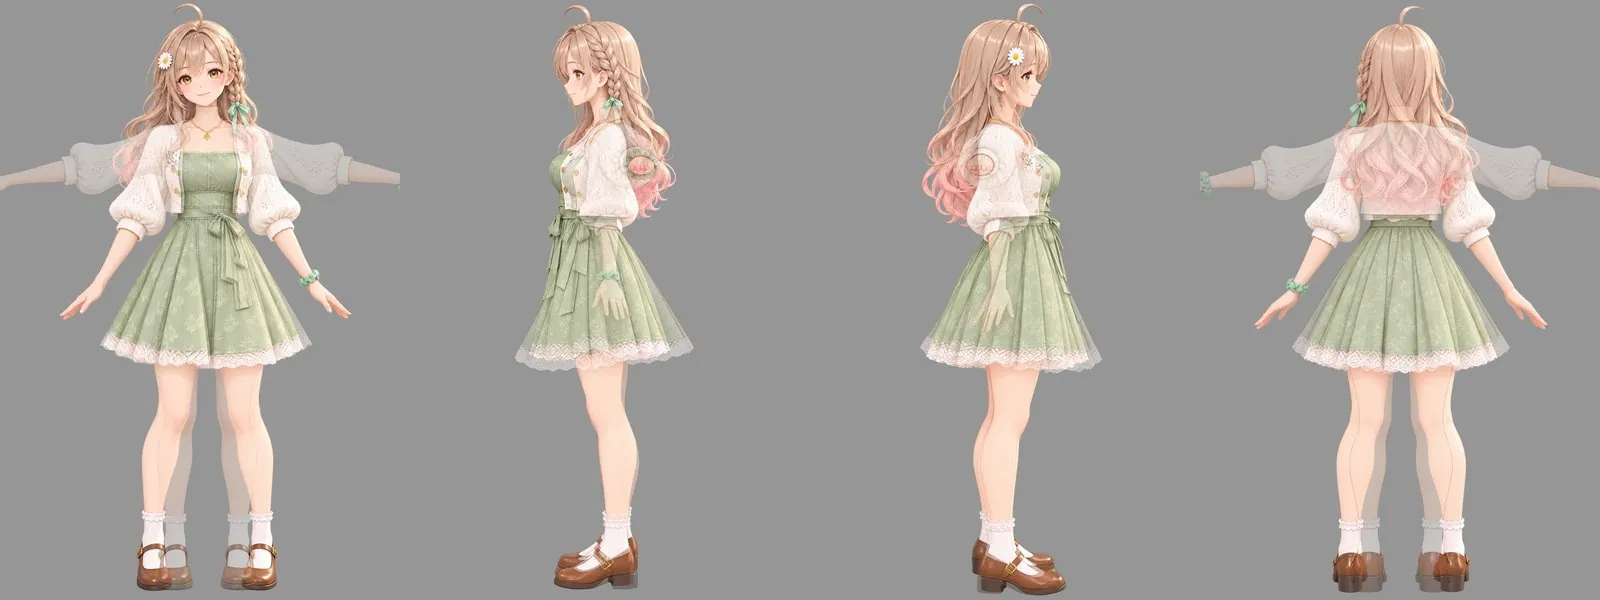
- 每張都附上設計稿同角度的視圖,請它「編輯附圖」
- 每一張開一個新對話
- 身體的側面圖寫明「手臂正對鏡頭」
驗收
- 頭頂、下巴、肩膀、腳底在四張圖裡的高度差,小於圖高的 2%
- 左側面圖裡,角色的臉朝畫面左邊
- 四張圖的飾品數量一樣
為什麼
- 頭部張嘴生成,牙齒、舌頭和口腔才會是立體網格。閉嘴可以往回做,閉嘴的頭做不出口腔
- 只靠文字描述畫的頭髮四視圖,髮型跟設計稿差很多
- 在同一個對話裡接著生側面,會變成 3/4 視角;身體側面沒寫明,手臂會往背後伸
- 設計稿本身也會矛盾:側面的鼻尖在眼睛到下巴的 44%,正面在 27%。以正面為準
Tripo 生成,貼圖最後上
做法
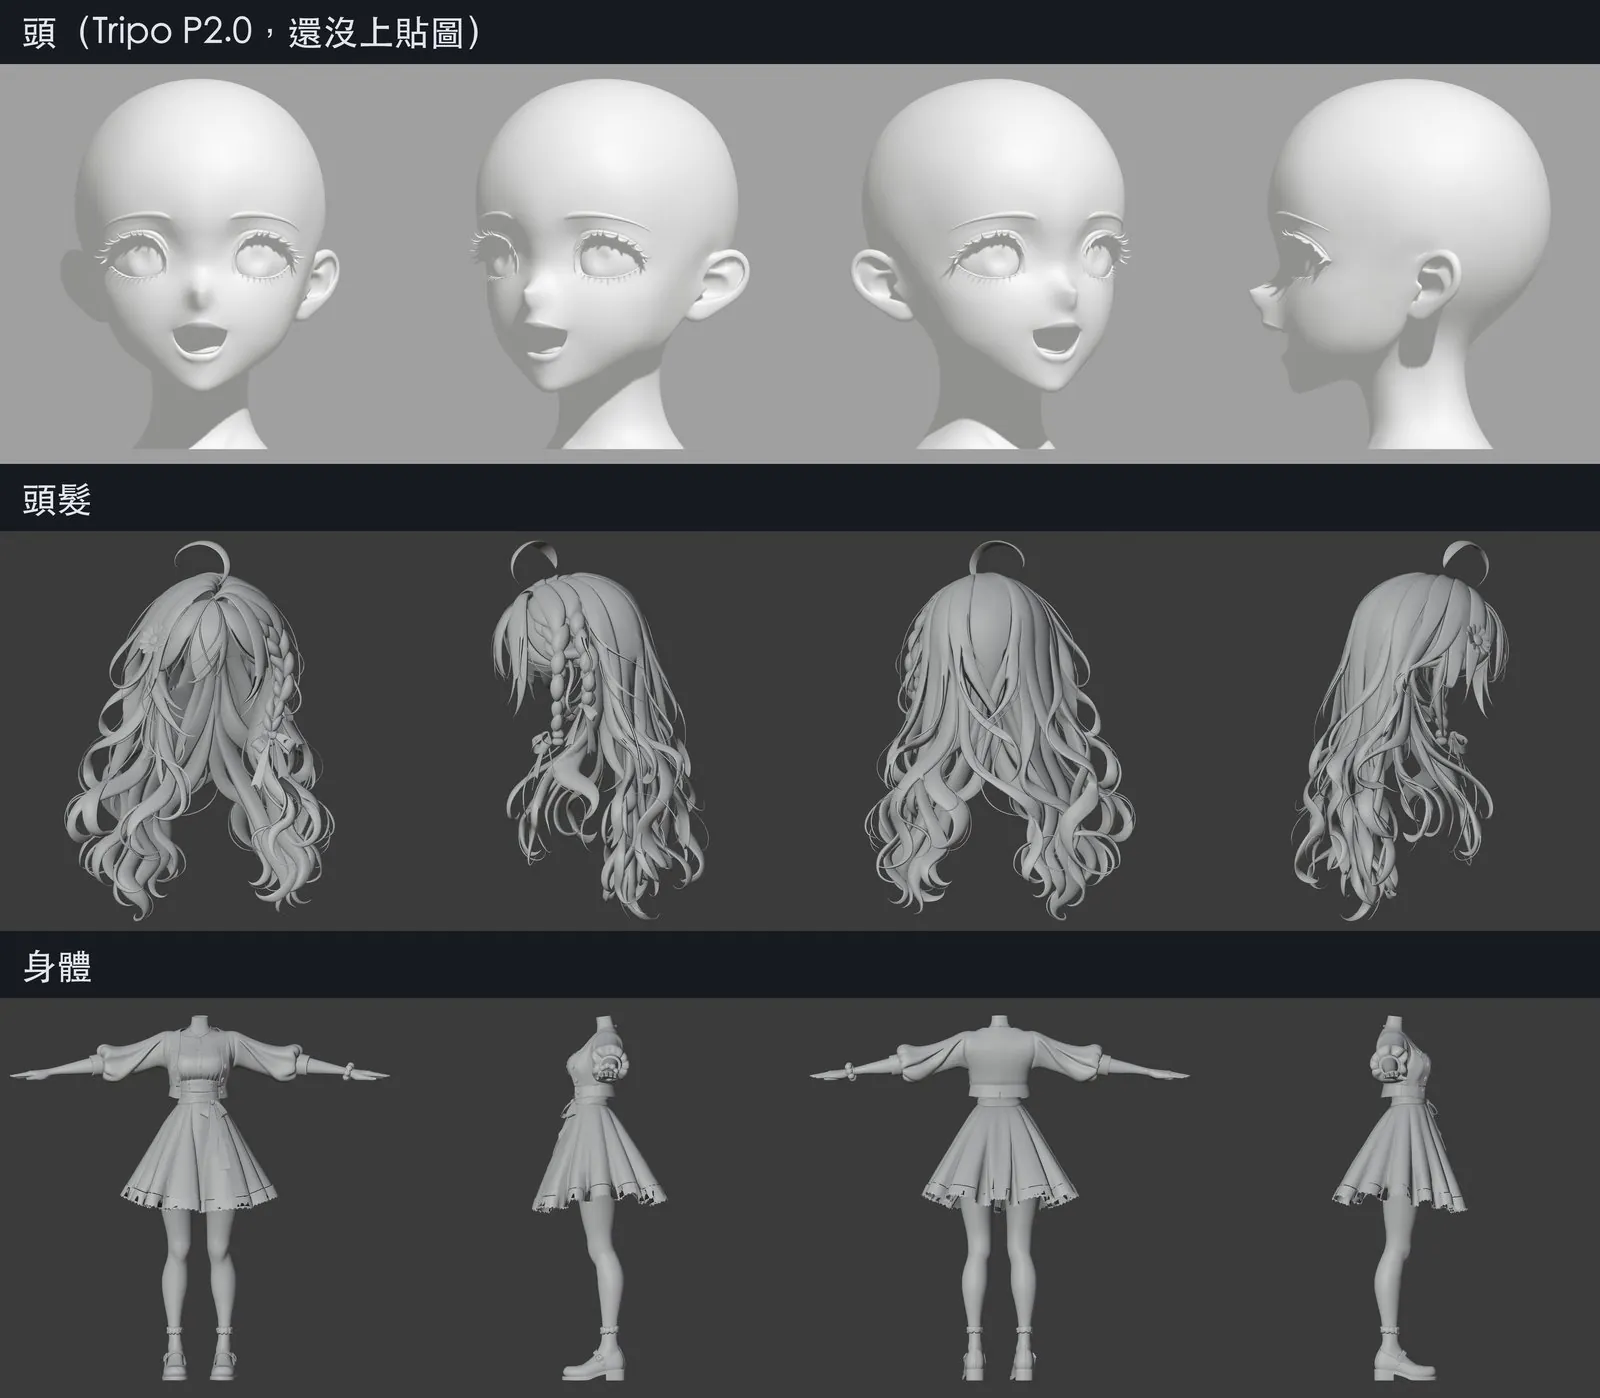
- 用 Smart Mesh P2.0 多視圖,一件一件送:頭 → 身體 → 頭髮。每件 100 點
- 每次送出前重設四項:模型 P2.0、上傳框第 2 個圖示(多視圖)、面數 25,000、隱私 Private
- 先只生網格。組裝、修比例都做完,最後才上貼圖(每件 20 點),再照頂點位置把 UV 搬回修過的網格
驗收
下載後數面數,每件約 25,000 個四邊形面。只有 5,000 就是設定被重設了。
為什麼
- 頁面每次載入都回到預設,面數預設是 5,000
- 上傳框第 3 個圖示是批次模式,四張圖各生一個模型,扣 300 點
- 頭最難,先生頭,不滿意只重抽頭
- 實測上貼圖不改網格:頭的 52,220 個面全部找得回來,頂點位置不變,只是沿 UV 接縫拆開。所以網格可以放心先改
- Left 格要放角色自己的左側面。第一輪放反,頭的側臉長到後腦勺,360 點作廢
照設計稿的高度組裝
做法
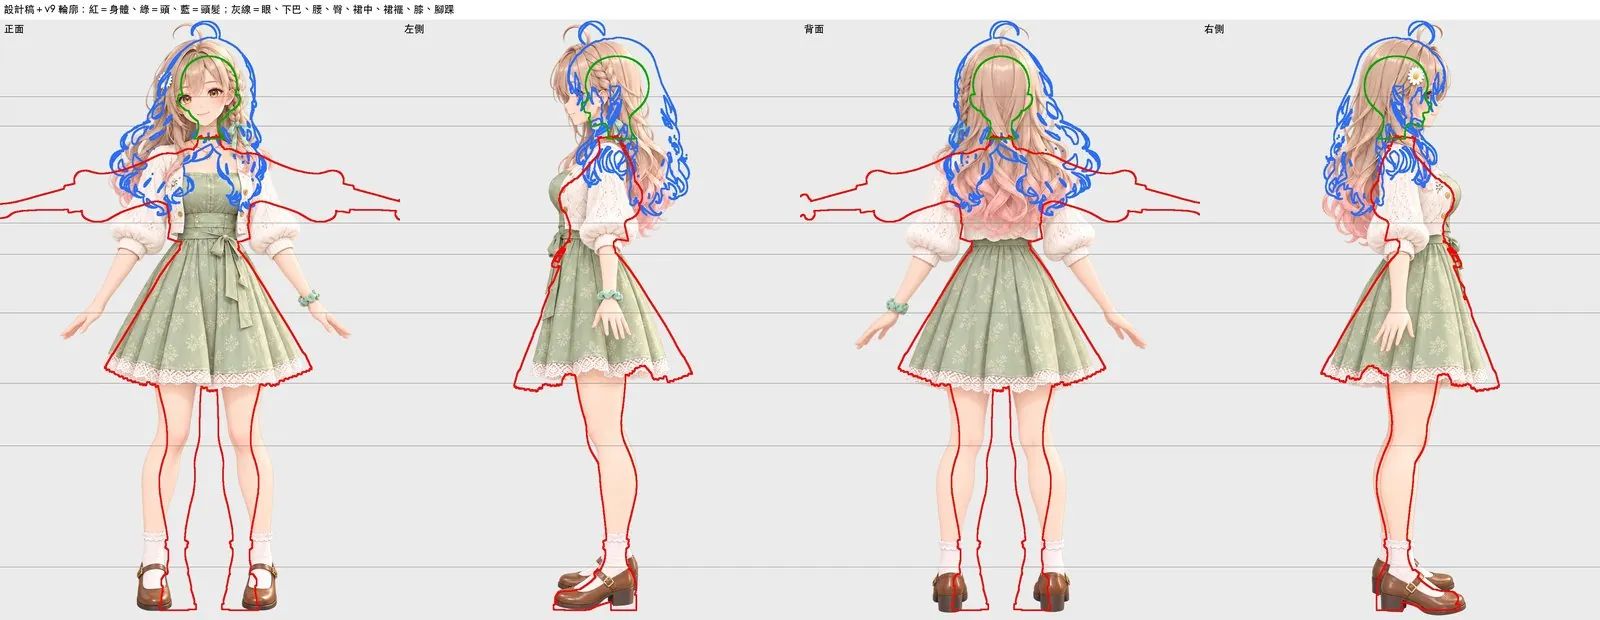
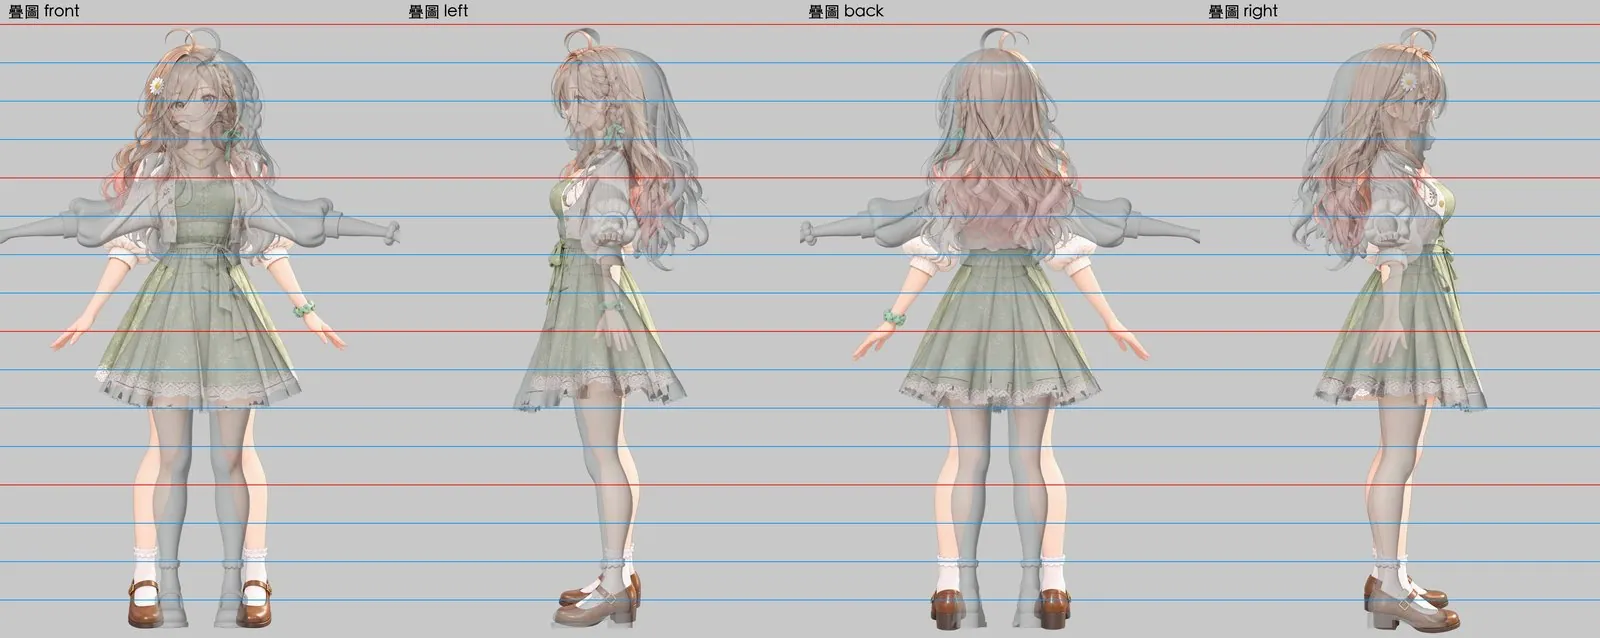
- 在設計稿上量出髮頂、眼睛、下巴、頸根的像素高度
- 用裙襬和鞋底換算成公尺(這次是每像素 0.785 mm),照高度擺三個部件
- 逐列比對模型和設計稿的輪廓寬度,列出差距表
- 一次修一個部位,修完重跑整張表,再修下一個
- 正面和背面對不上時,取兩邊平均
驗收
每修一處就重跑比對表,給我看修前修後的對照圖。
為什麼
- 照脖子寬度縮放,頭大了 1.4 倍。生成的脖子比身體那段細
- 第一張比對表列出十幾項差距,其中兩項是量錯了:下巴「窄 22%」是用眼睛讀的數字,逐欄重量後是 70 對 69 px;腳踝「細 16%」量到的是鞋口,模型那一列還是襪子。差距大得不合理,先檢查量的位置
- 設計稿的前後視圖會打架:同一條裙子,正面比背面寬 10%
接縫一層一層修
做法
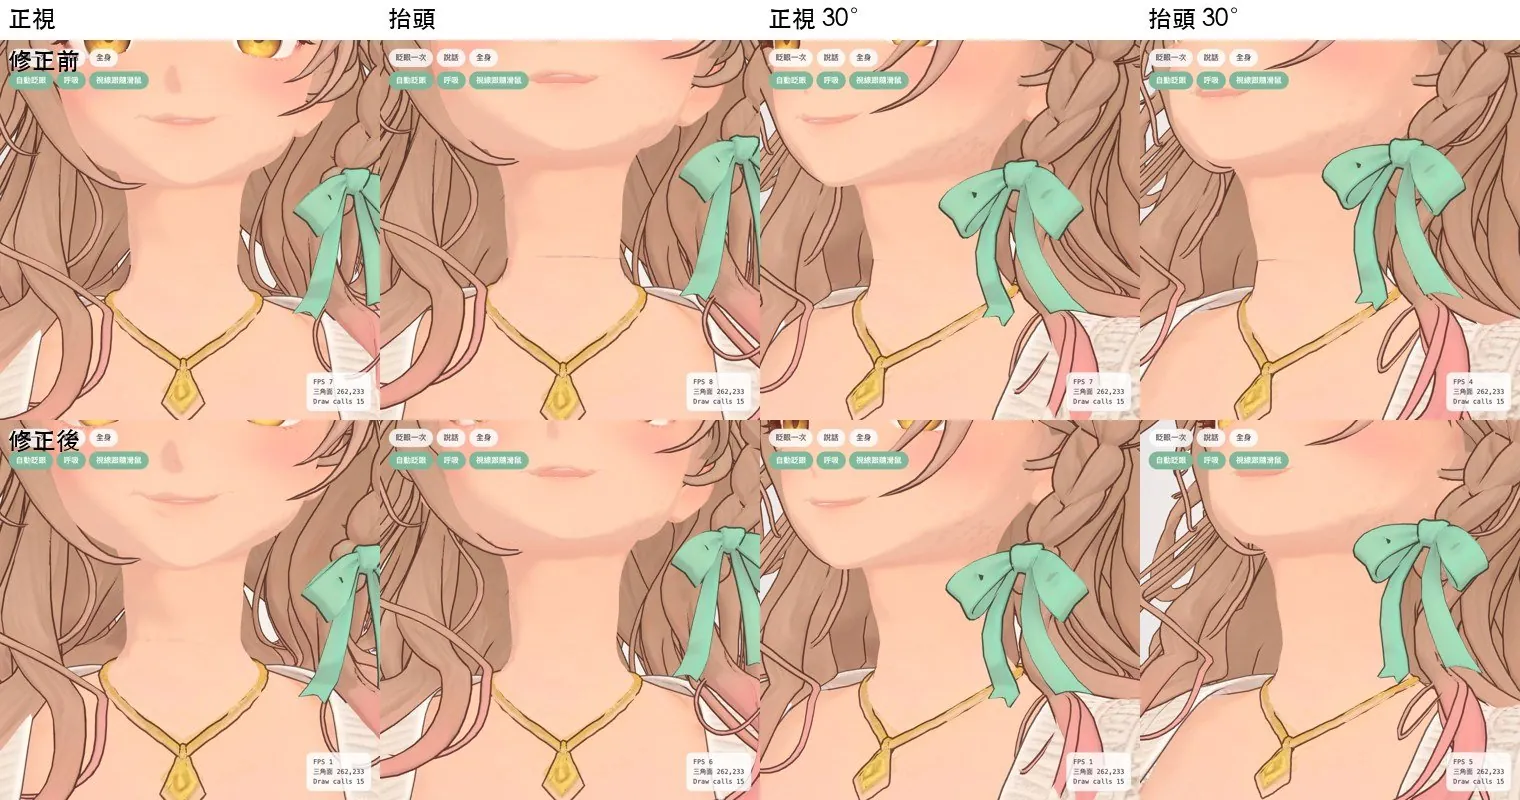
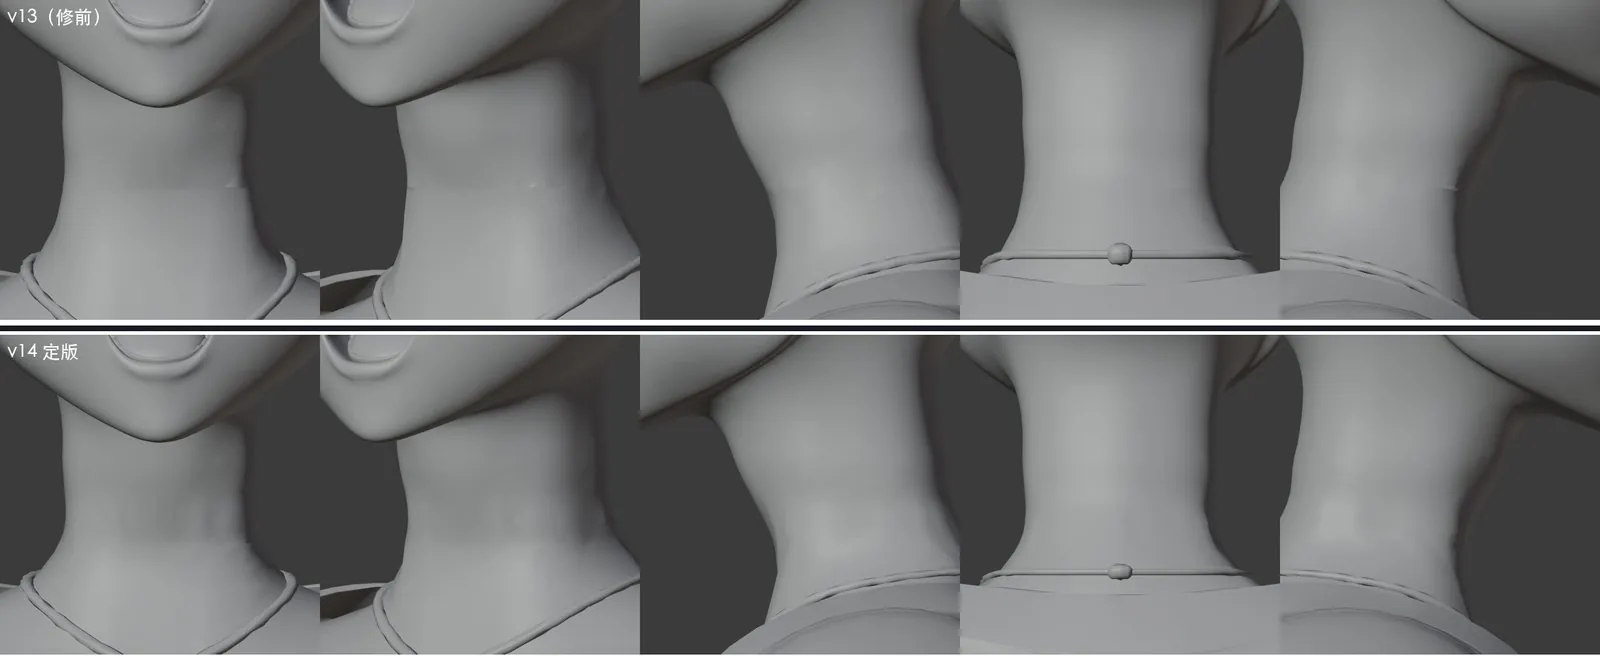
頭和身體接在脖子上,照下面的順序檢查和修正。
| 順序 | 層 | 檢查 | 修法 | 這次的結果 |
|---|---|---|---|---|
| 1 | 幾何 | 沿邊取樣量縫隙 | 身體的切口補上頭那圈的每個頂點 | 0.19 mm → 0 |
| 2 | 法線(受光方向) | 接縫兩側的法線夾角 | 接縫用兩邊的平均法線 | 22.2° → 0.01° |
| 3 | 貼圖 | 切口兩側的 RGB 差 | 身體貼圖裡接近膚色的像素,每個通道乘上增益 | (13, 9, 11) → (1, 1, 2) |
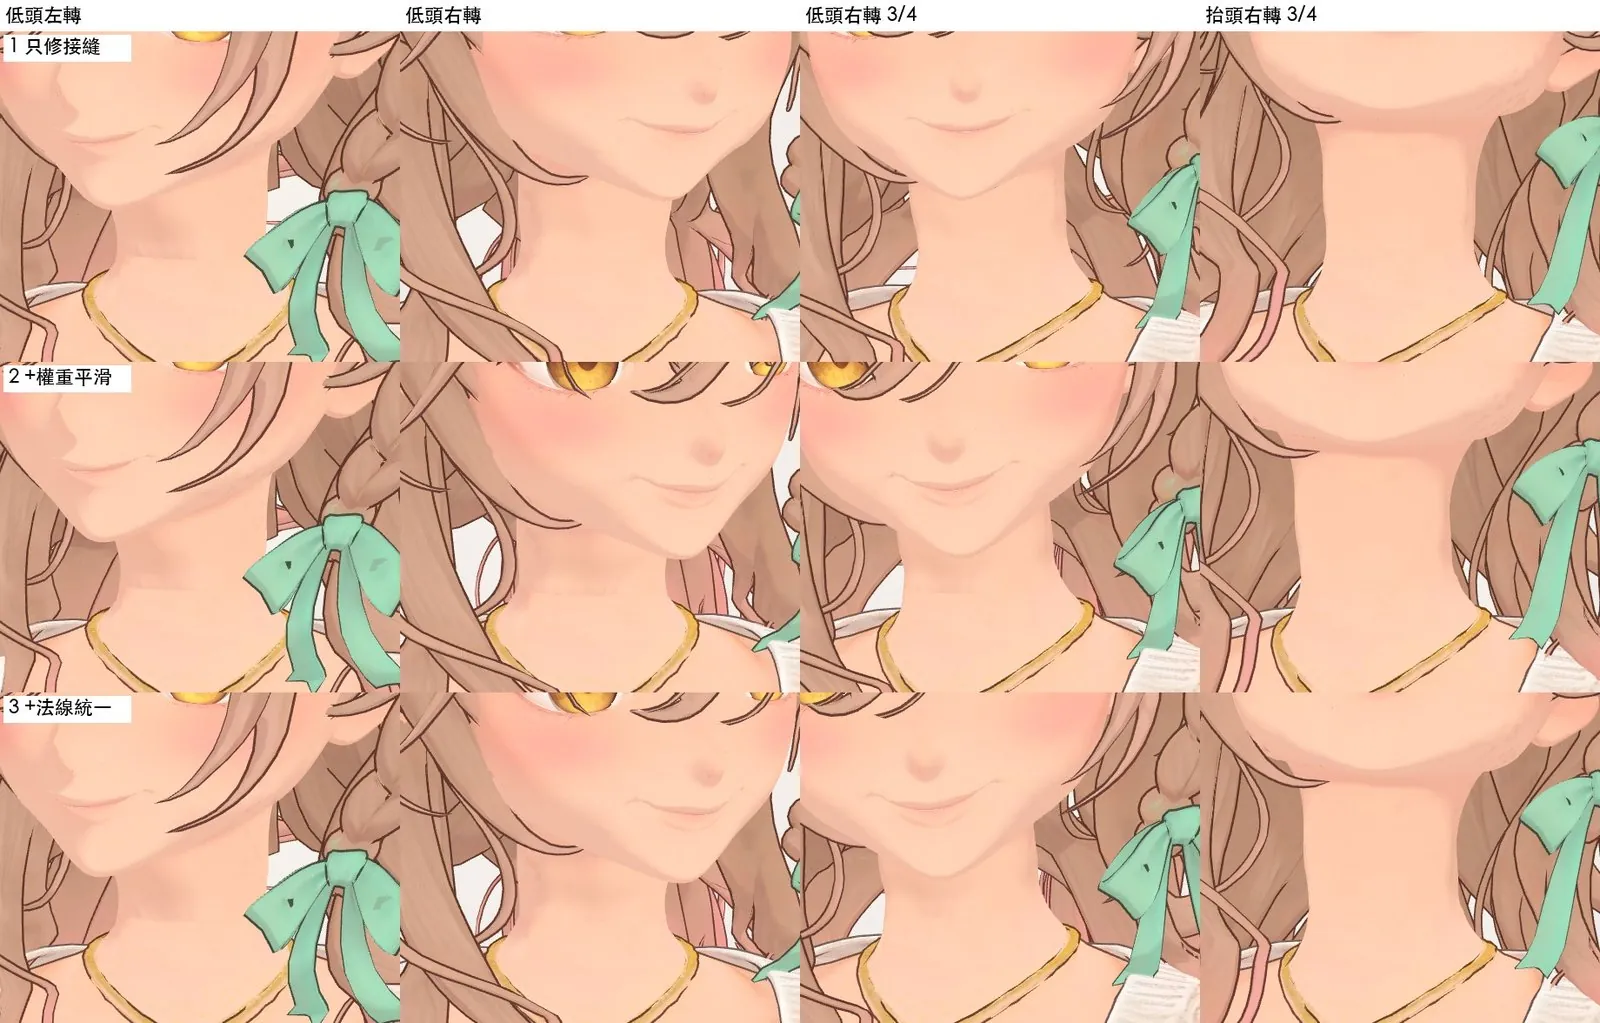
| 4 | 權重(跟哪根骨頭動) | 七種姿勢下的最大裂縫 | 頭的邊貼到身體的邊,權重照身體內插,往上 15 mm 混回原本的 | 3.27 mm → 0.001 mm |
| 5 | 描邊 | 目視 | 接縫 1 cm 內不畫描邊 | 黑線消失 |
為什麼
頭和身體分開生成,接縫在每一層都出過一次問題,前一層修好,下一層才看得出來。權重修了兩輪:第一輪處理抬頭時裂開,第二輪處理低頭時下巴底下的摺痕。
綁骨和彈簧骨
做法
- 整隻減面到 4.5 萬面,上傳 Tripo Auto Rig(VRM 1.0 人形骨架,20 點)
- 下載後試 4 個 90° 方向,用 ICP 對回原位
- 用最近面內插,把權重抄回完整的網格
- 頭髮的權重全部設成只跟頭骨
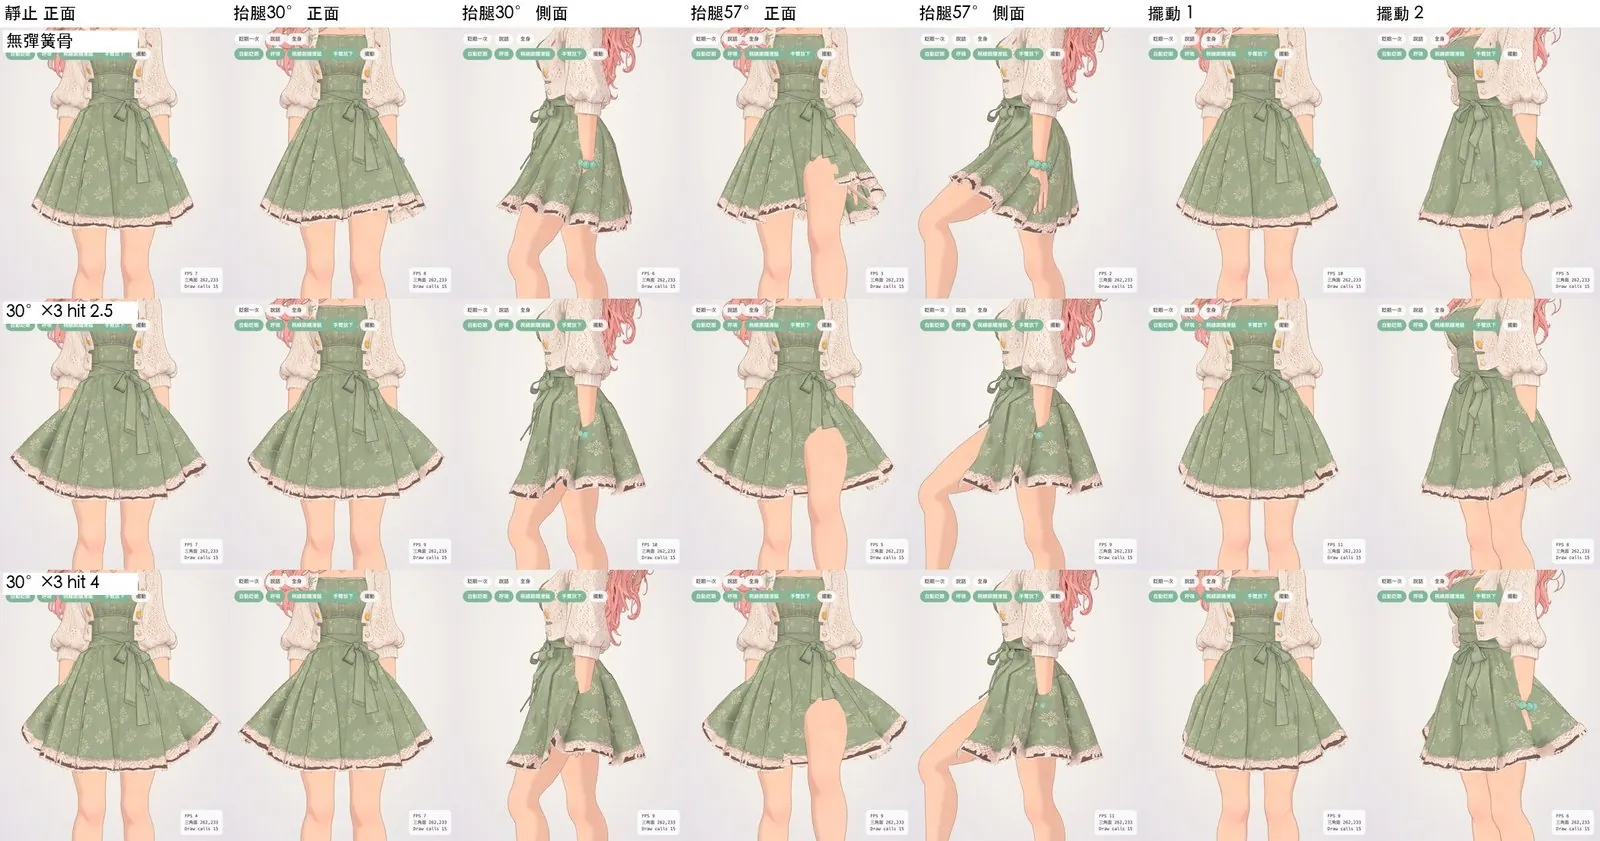
- 加彈簧骨:頭髮繞頭每 20° 一條鏈(13 條、每條 5 節),裙子繞臀骨每 30° 一條(12 條、每條 3 節)
- 裙子左右兩半照高度分一部分權重給同側大腿,裙襬最多一半
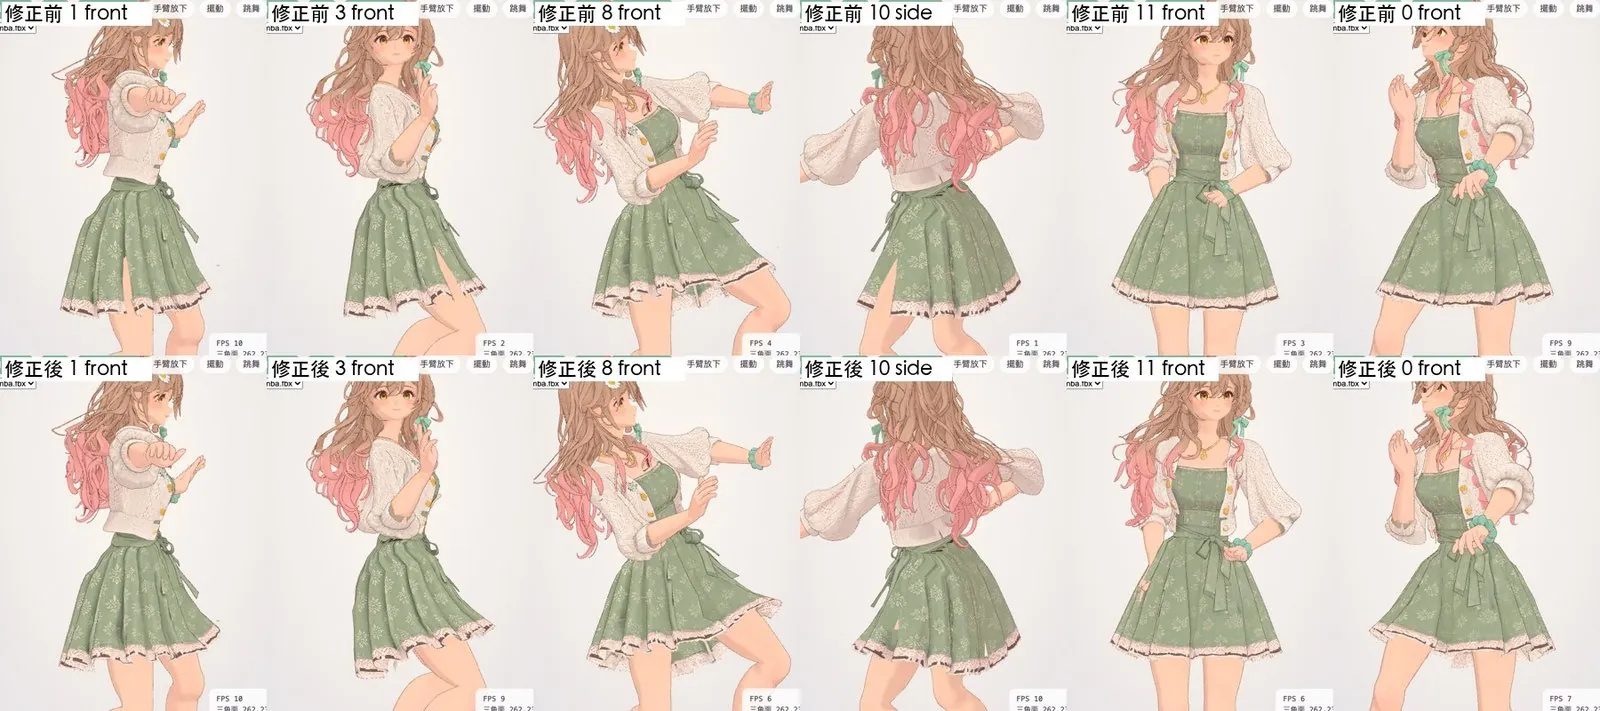
- 量一份軀幹輪廓(每 2 cm 一層、每層 36 個方位)。網頁播動作時,手進入輪廓就把上臂往外轉,每次 4°,最多 48°
驗收
- 0 個頂點沒有權重,對位殘差約 1 mm
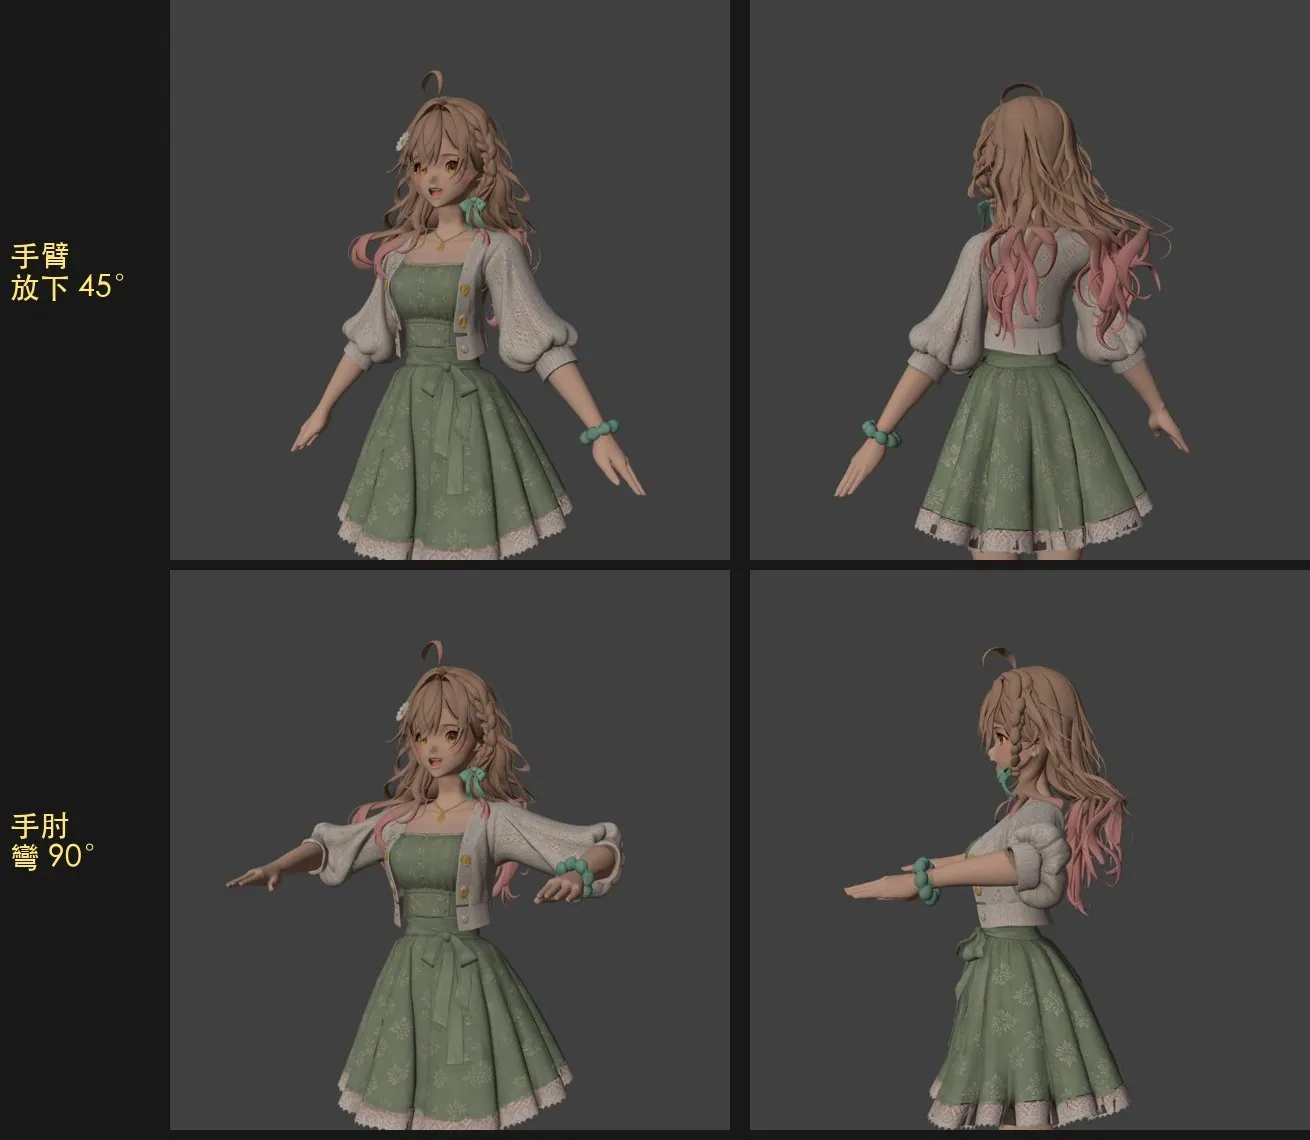
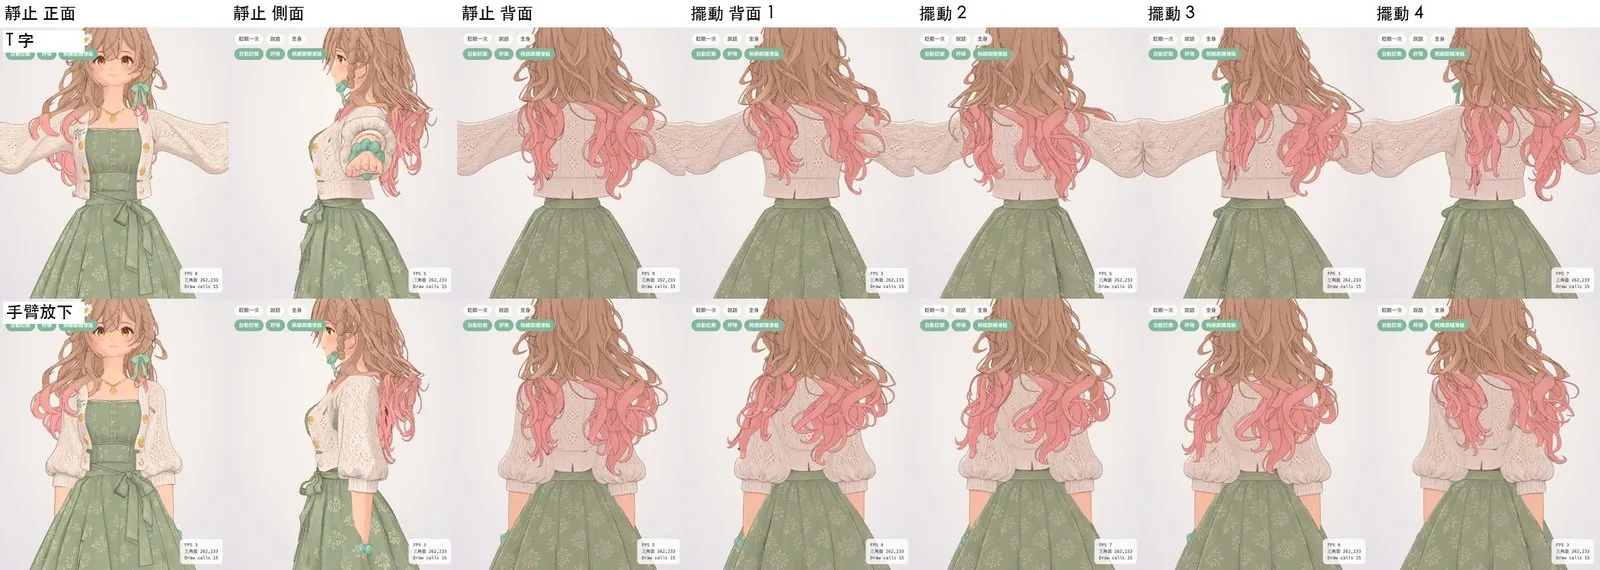
- 六個姿勢(手臂放下 45°、手肘 90°、膝蓋 60°、轉腰 20°、轉頭 30°、點頭 15°)的特寫,關節和脖子沒破
- 36 個測試姿勢裡,陷進軀幹的手部頂點從 976 個降到 59 個
為什麼
- 整隻 15.7 萬面送 Auto Rig,會跳出「Polygon Limit Exceeded」
- Tripo 會把上傳的模型轉向,再縮成 1 m 高
- 用 Tripo 給的頭髮權重,手臂一放下瀏海就被扯皺
- 裙子試過 20° × 4 節:裙子內襯太貼大腿,碰撞體被縮到 5 mm,大腿直接穿出
- Mixamo 的動作是用別的體型做的,手會插進胸口和腰
表情從張嘴往回做
做法
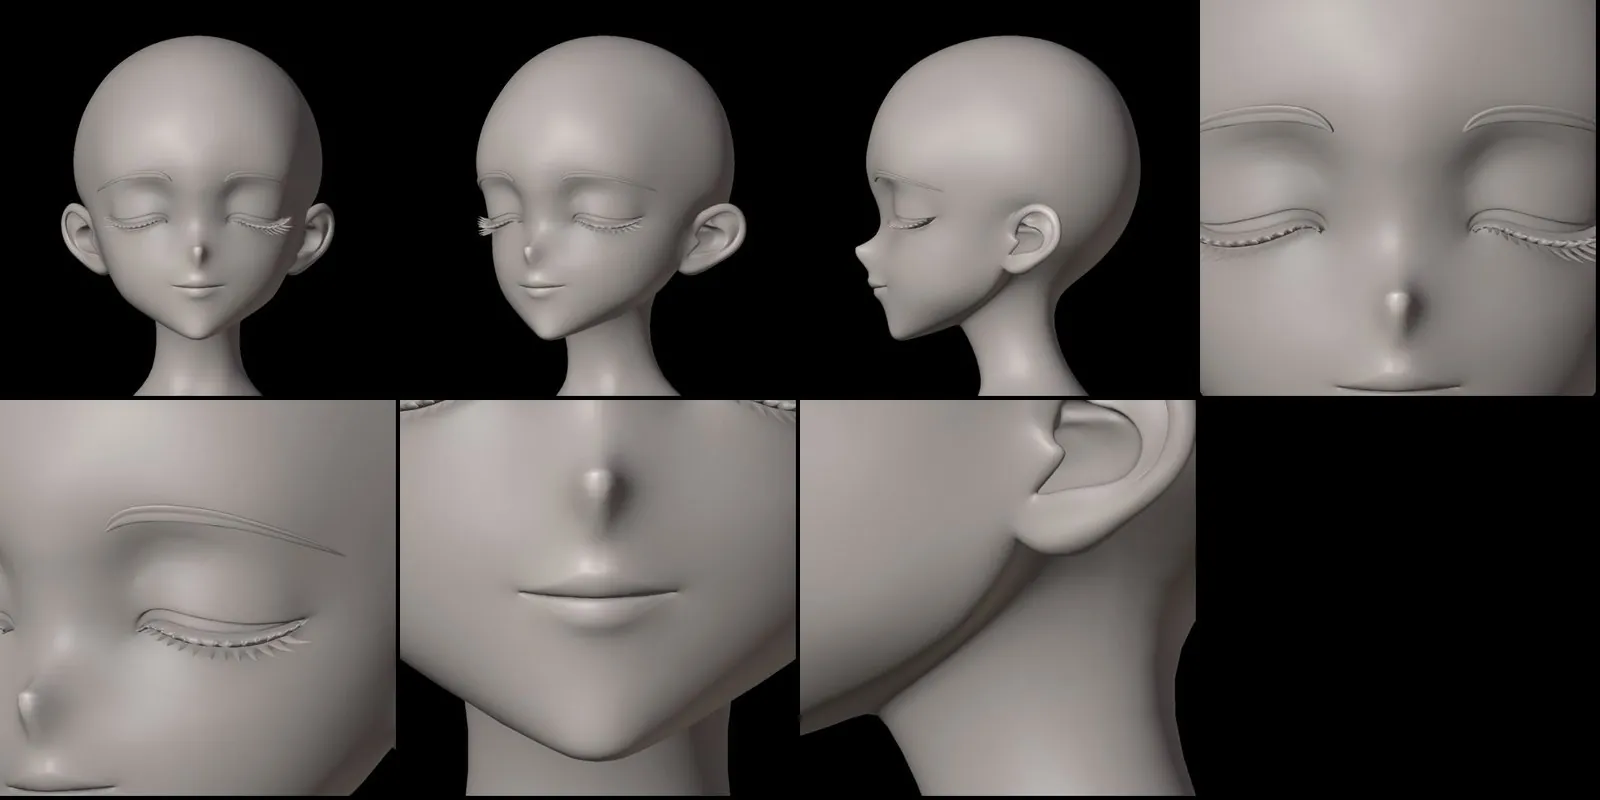
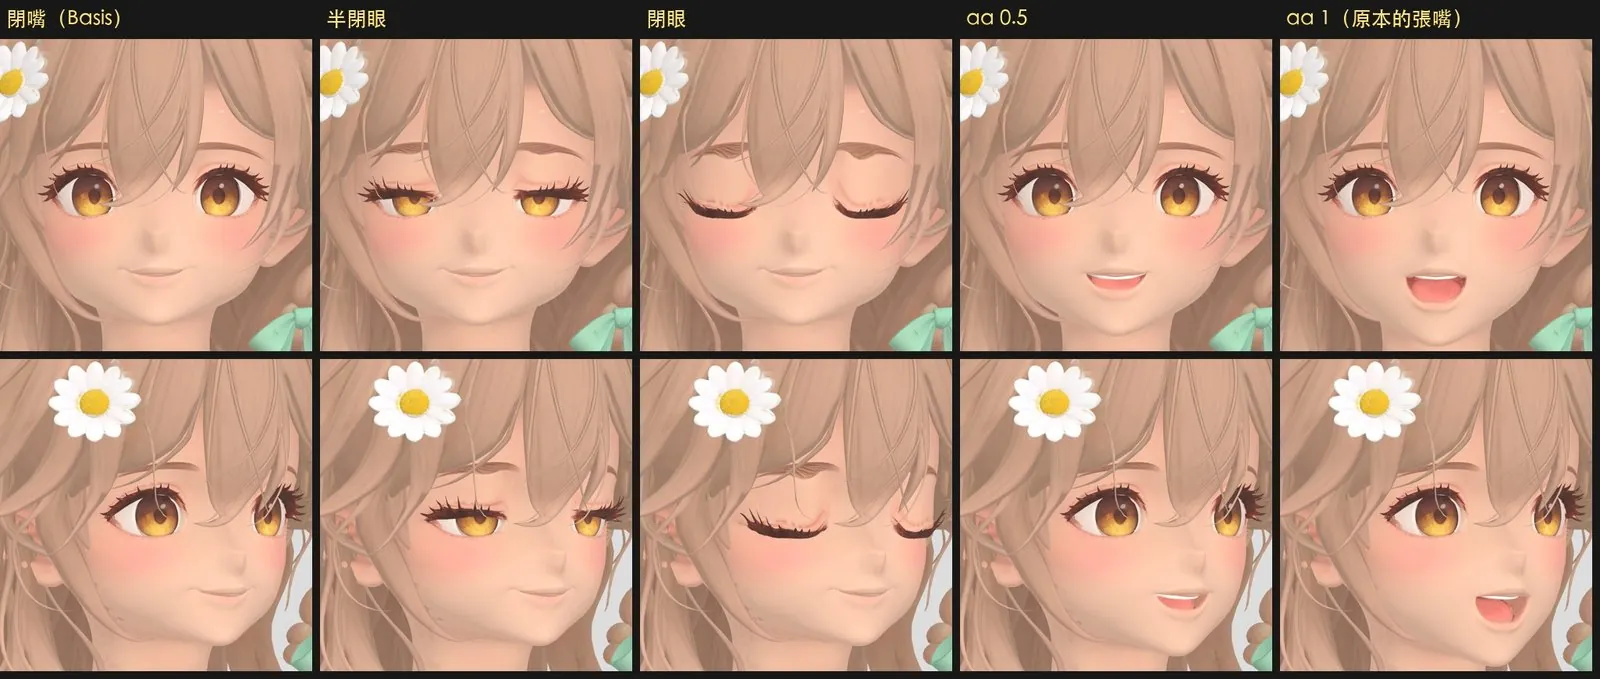
- 閉嘴、閉眼都從張嘴睜眼的模型往回推,做成 shape key(記錄頂點位移的變形)
- 另外生成一顆閉眼閉嘴的參考頭(100 點),對齊後讓眼皮和嘴唇取它表面的深度,往周圍漸弱
- 眼皮的滑動用調和場求解,固定眼皮硬的那段、下眼瞼和外圈
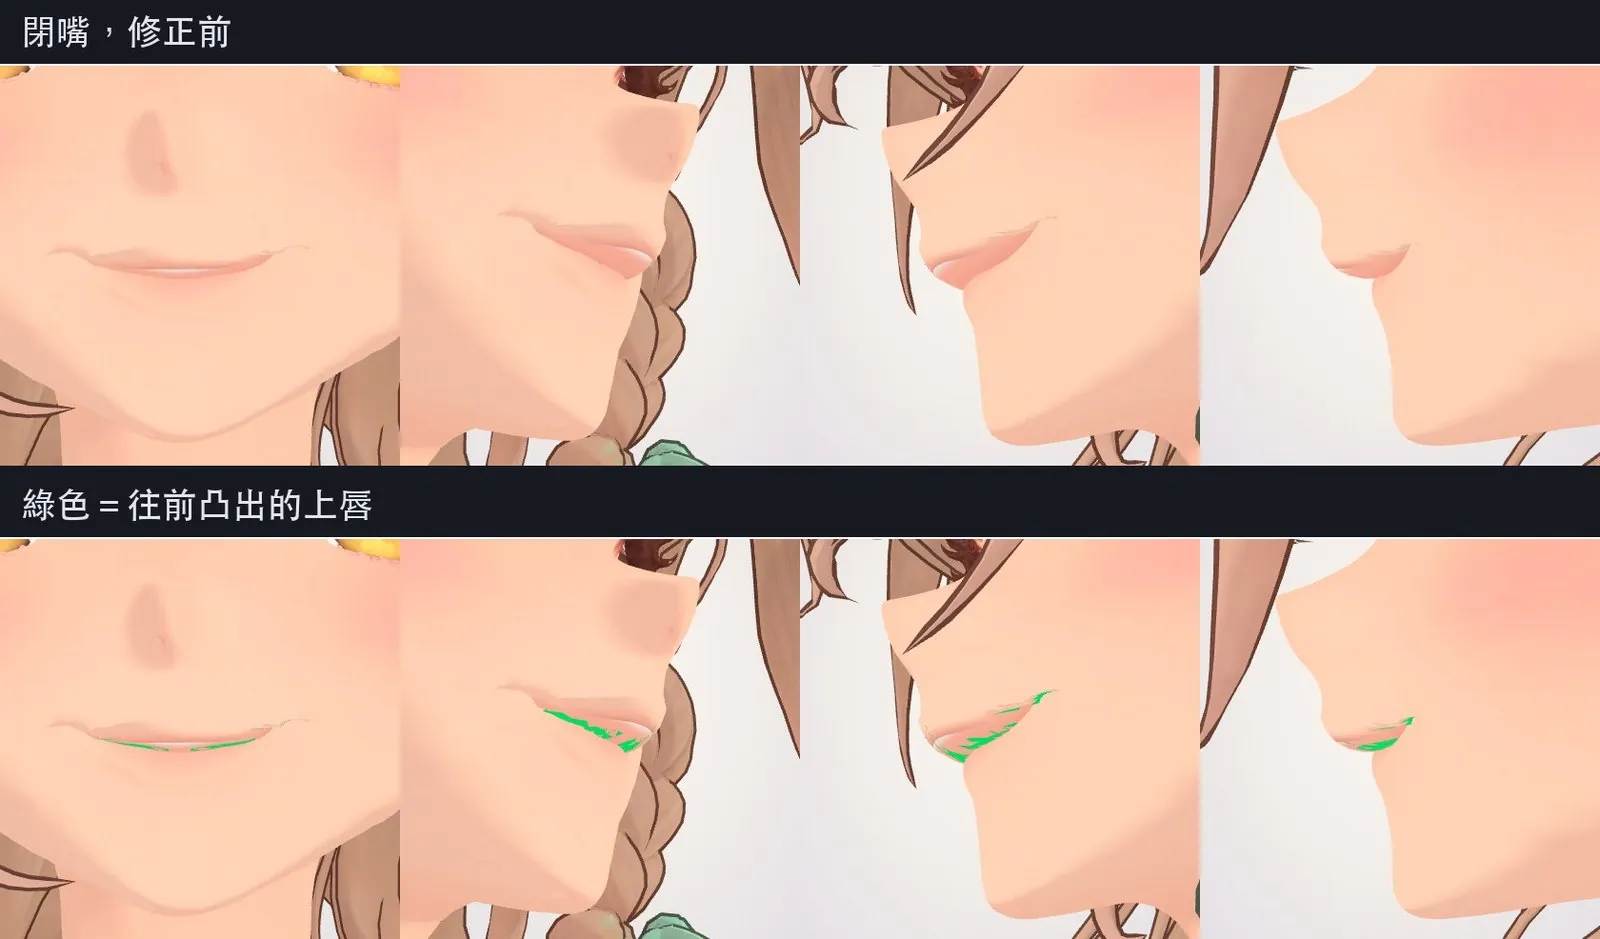
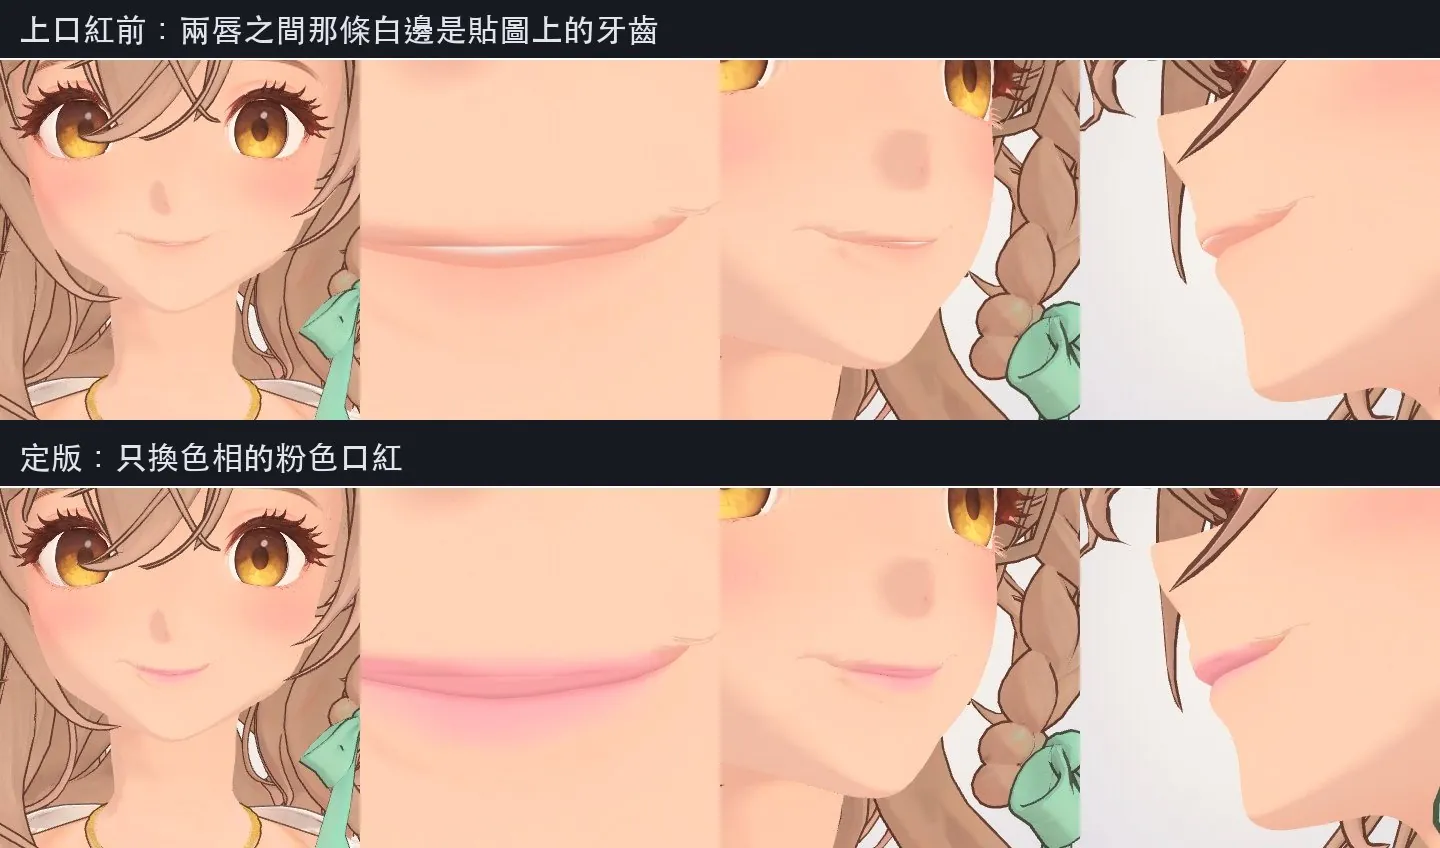
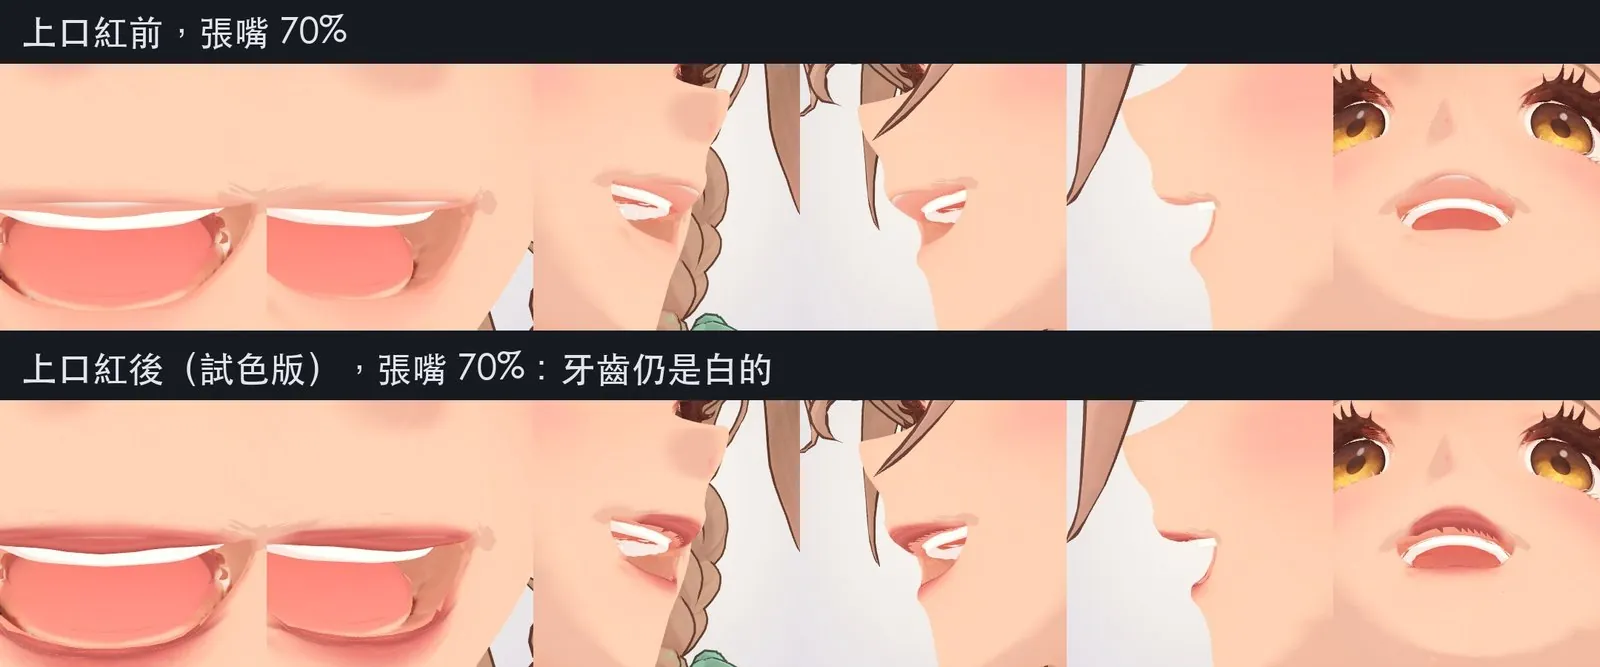
- 嘴唇之間的牙齒貼圖,用口紅蓋掉:沿兩唇之間的凹痕烤進臉部貼圖,唇線上方 2.2 mm 內比唇色淺的像素先蓋成唇色
- 口紅只換色相,保留原本唇色的明暗
驗收
- 閉嘴:從五個角度看嘴巴裡面,可見像素是 0(對照組:全開時正面 10,854 px)
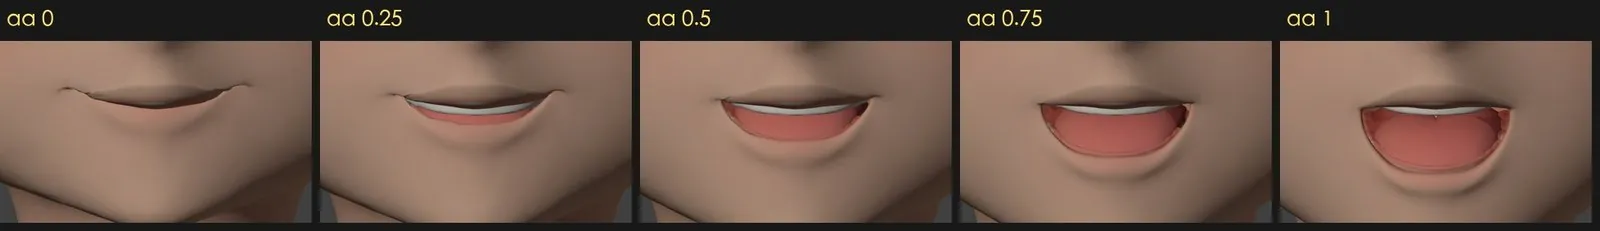
- 張嘴:開到 25%、50%、75%、100%,牙齒和舌頭都不穿出嘴唇
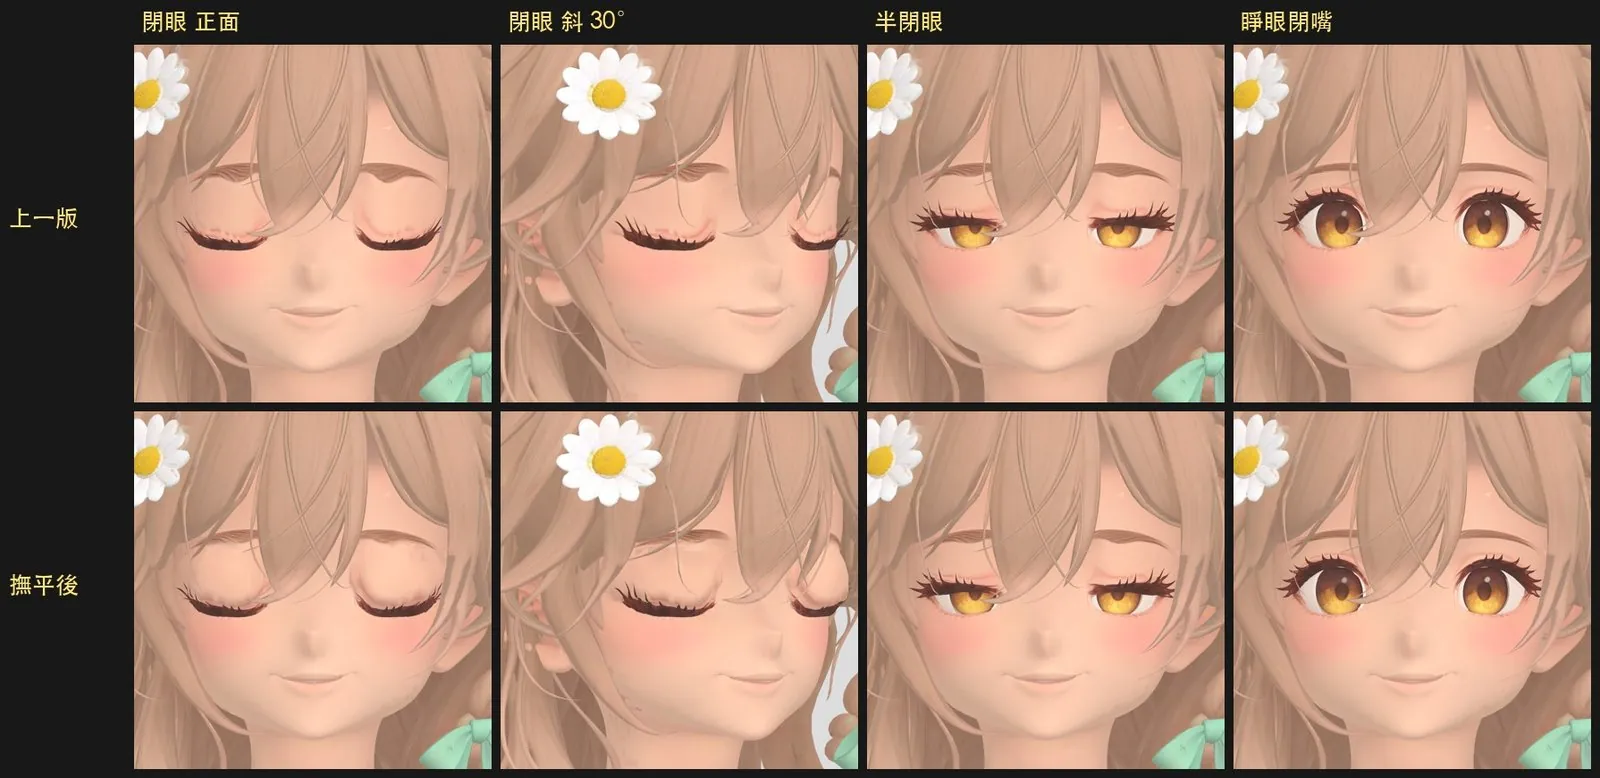
- 閉眼:從正面和左右 30° 數露出的眼球縫(這次定版右眼 0 條,左眼 1–3 條)
- 每個表情都從側面看一次
為什麼
- 這顆頭的眼球比周圍皮膚深 6 mm。眼皮照原本的深度往下滑,眼窩出現 U 形凹痕;撫平之後又像腫起來
- 上唇直接合起來,會往前凸 6.4 mm,從正面看不出來。借參考頭之後降到 3.8 mm,參考頭本身是 4.0 mm
- Tripo 把上排牙齒畫在張嘴的貼圖上,閉嘴後剛好落在上唇下緣,正面看是一條白邊。烤上口紅後,唇線上的白色像素從 577 個降到 0
換裝和表情
做法
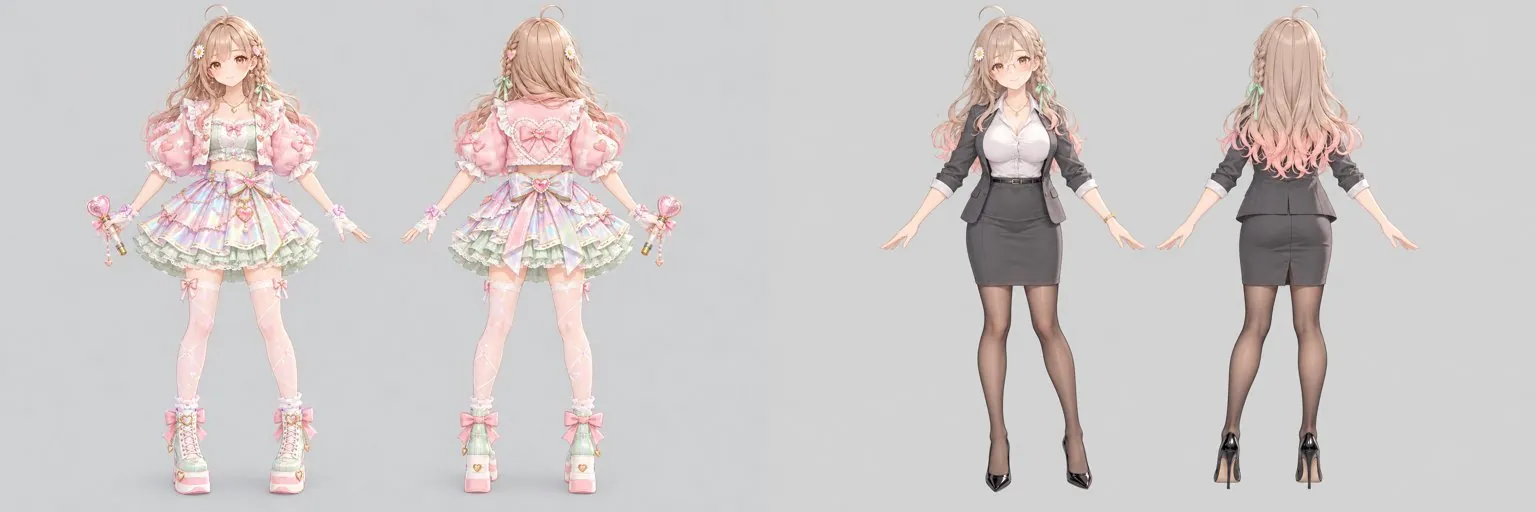
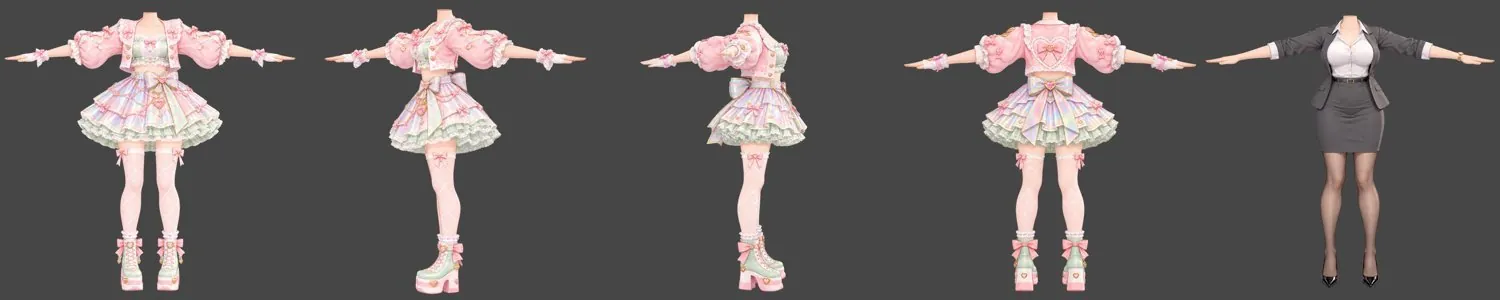
- 衣服:請 ChatGPT 把四視圖改成新衣服 → Tripo 生成 T 字站姿的無頭身體 → 用 ICP 對齊陽菜,每輪排除誤差最大的 30% → 每個頂點抄陽菜身體最近點的權重,不含裙子,保留影響最大的四根骨頭 → 脖子切口接到頭上
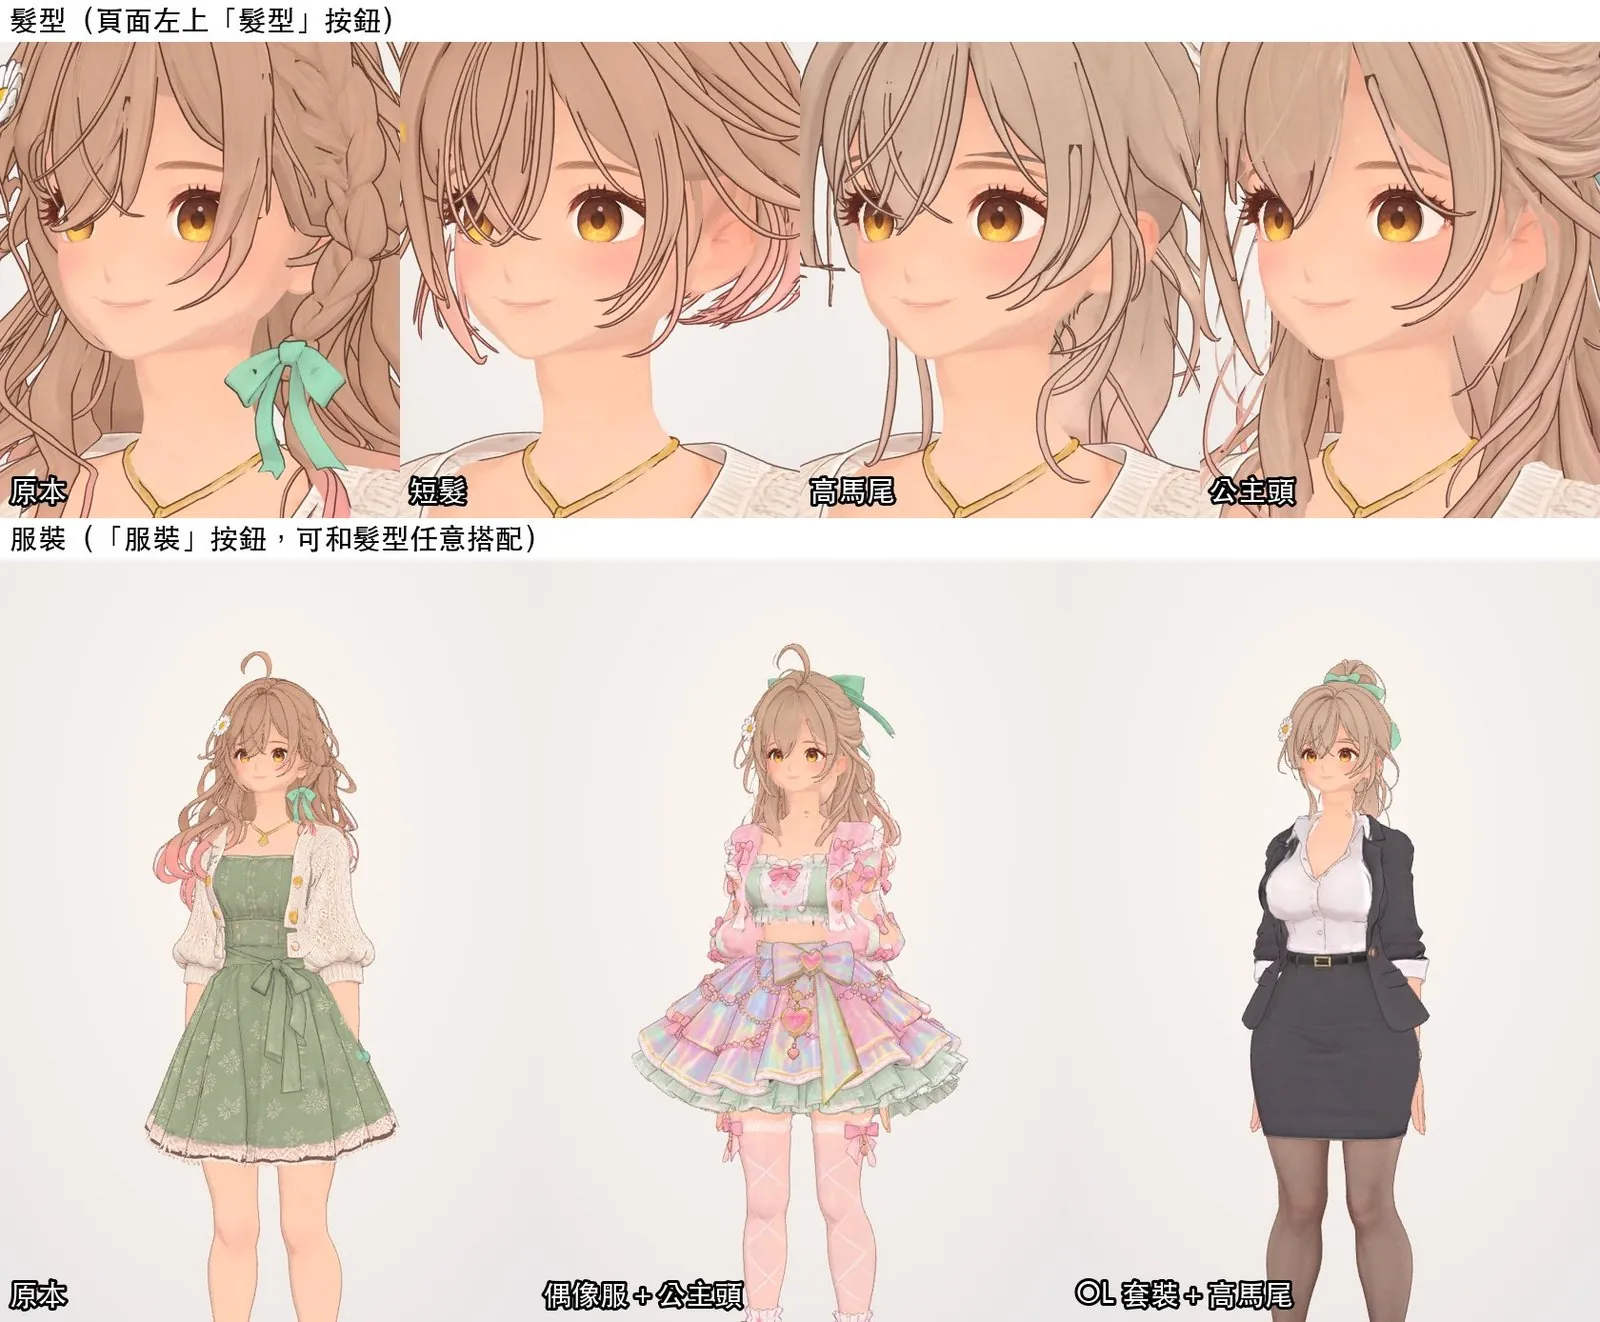
- 髮型:Tripo 生成「頭加頭髮」,把陽菜的頭疊到那顆頭上算出對位,頭髮跟著搬過來,綁到頭骨
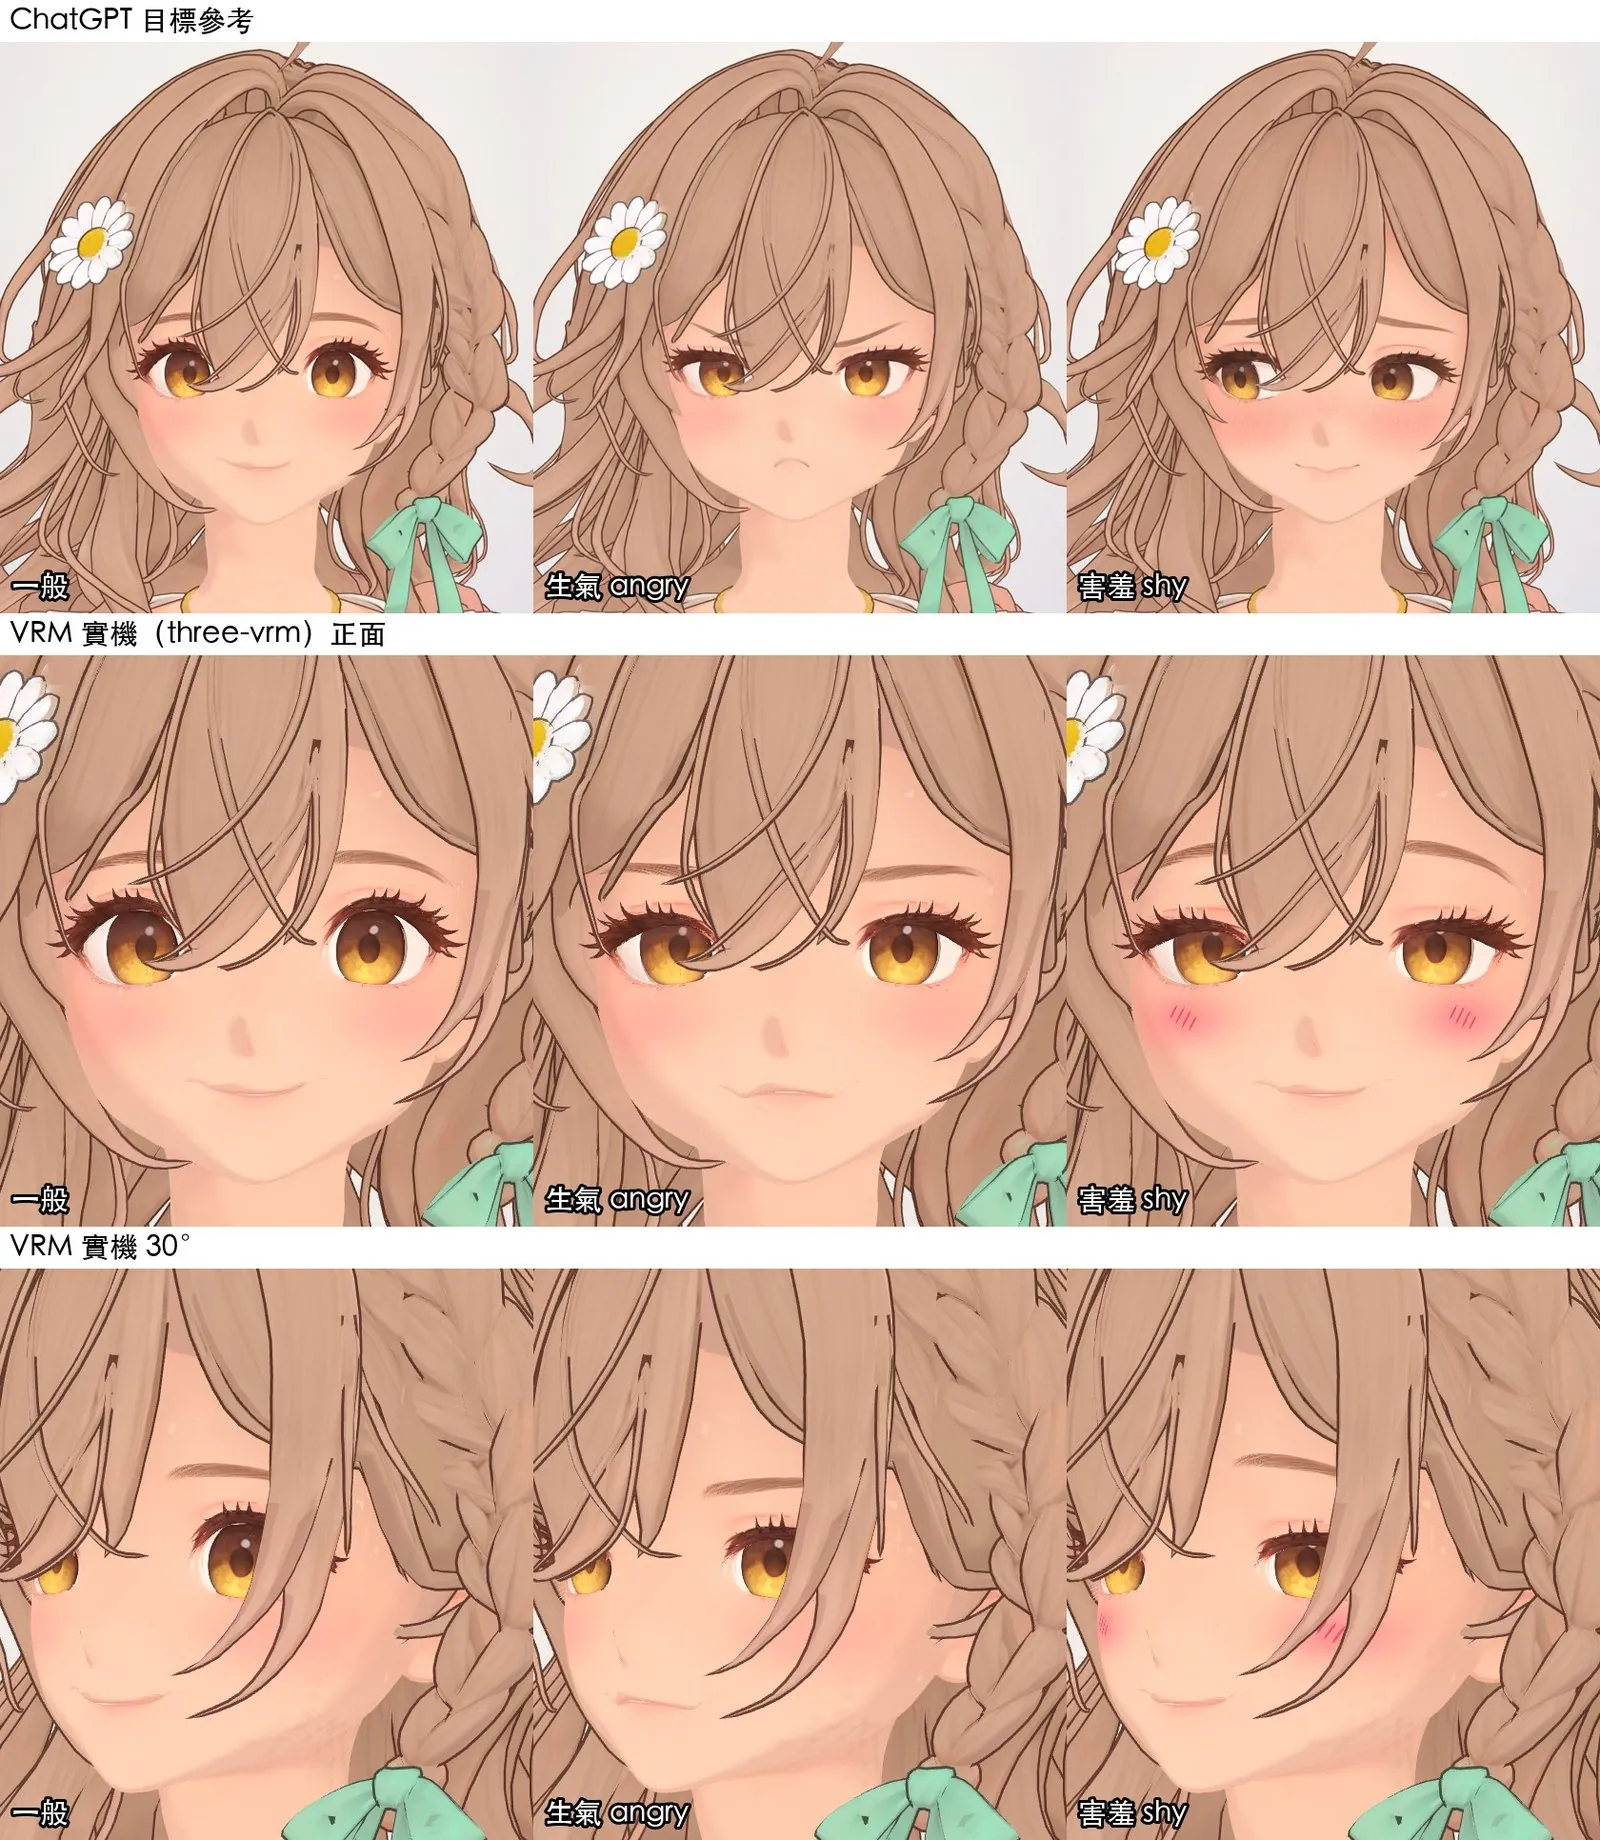
- 生氣、害羞:眉毛從貼圖摳出來做成貼片,原位補上膚色;害羞另外加臉紅
驗收
每一件都在網頁上實際穿過,每個表情都在網頁上切過一次。
為什麼
- 一具身體綁好之後,衣服抄它的權重,換幾件都不用重新綁骨
- 眉毛畫在皮膚上時,皮膚一動 2–4 mm,眉尾附近就有 22–47 個三角形翻面
- 紫色捲髮做好了沒放上去:頭髮太稀,看起來像禿頭
目前有高馬尾、公主頭、短髮三種髮型,偶像服、OL 套裝兩套衣服。
聲音和對嘴
做法
- ElevenLabs 的 Voice Design 用文字描述聲線,生成陽菜的聲音;Eleven v4 念出中、日、英、韓台詞(免費方案)
- wav2vec2(XLSR-53,輸出國際音標的版本)每 20 ms 辨識一個音
- 音標歸成 a、i、u、e、o 五種嘴形。i、u 開頭的滑音(像「月」「亮」),嘴形用後面那個母音;b、p、m、f、v 短暫閉嘴
- 開口大小看音量,分閉、半開、全開三段,每秒 30 格
- 模型只有一個張嘴形狀。i、e、o、u 在網頁上從它推出來:開口縮小,嘴角往外拉成 i、e,往內收、往前噘成 o、u
- 字幕用 ElevenLabs 回傳的逐字時間,每種語言各校正一個位移
驗收
字幕時間要跟聲音對上。把「這個字正在念」和「聲音夠大」兩條時間線錯開比對,取重疊最多的位移。這次的結果是中文提前 0.24 秒、韓文 0.15 秒、日文 0.12 秒、英文 0.04 秒。
為什麼
對嘴只看聲音,四種語言共用同一套程式。ElevenLabs 回傳的時間比實際聲音晚,晚多少要看語言。
放上網頁
做法
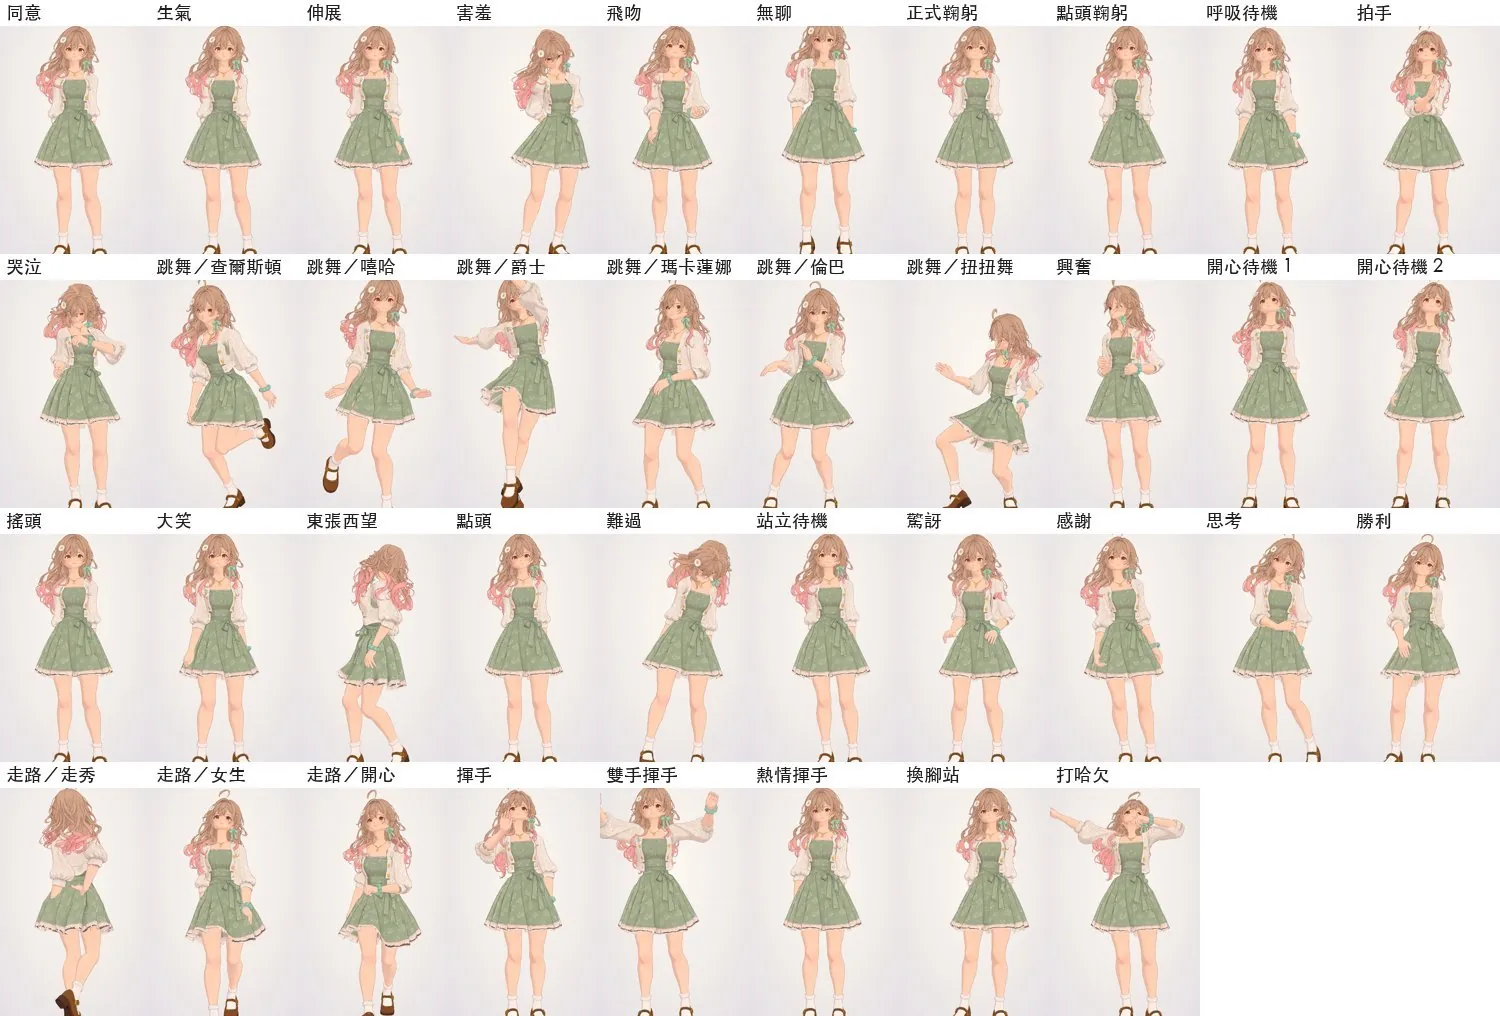
匯出 VRM,用 three.js 和 three-vrm 在網頁上即時算繪。Mixamo 的動作先在本機轉到陽菜的骨架上。成品在文章最下面,可以直接玩。
公開版另外做了三層保護:
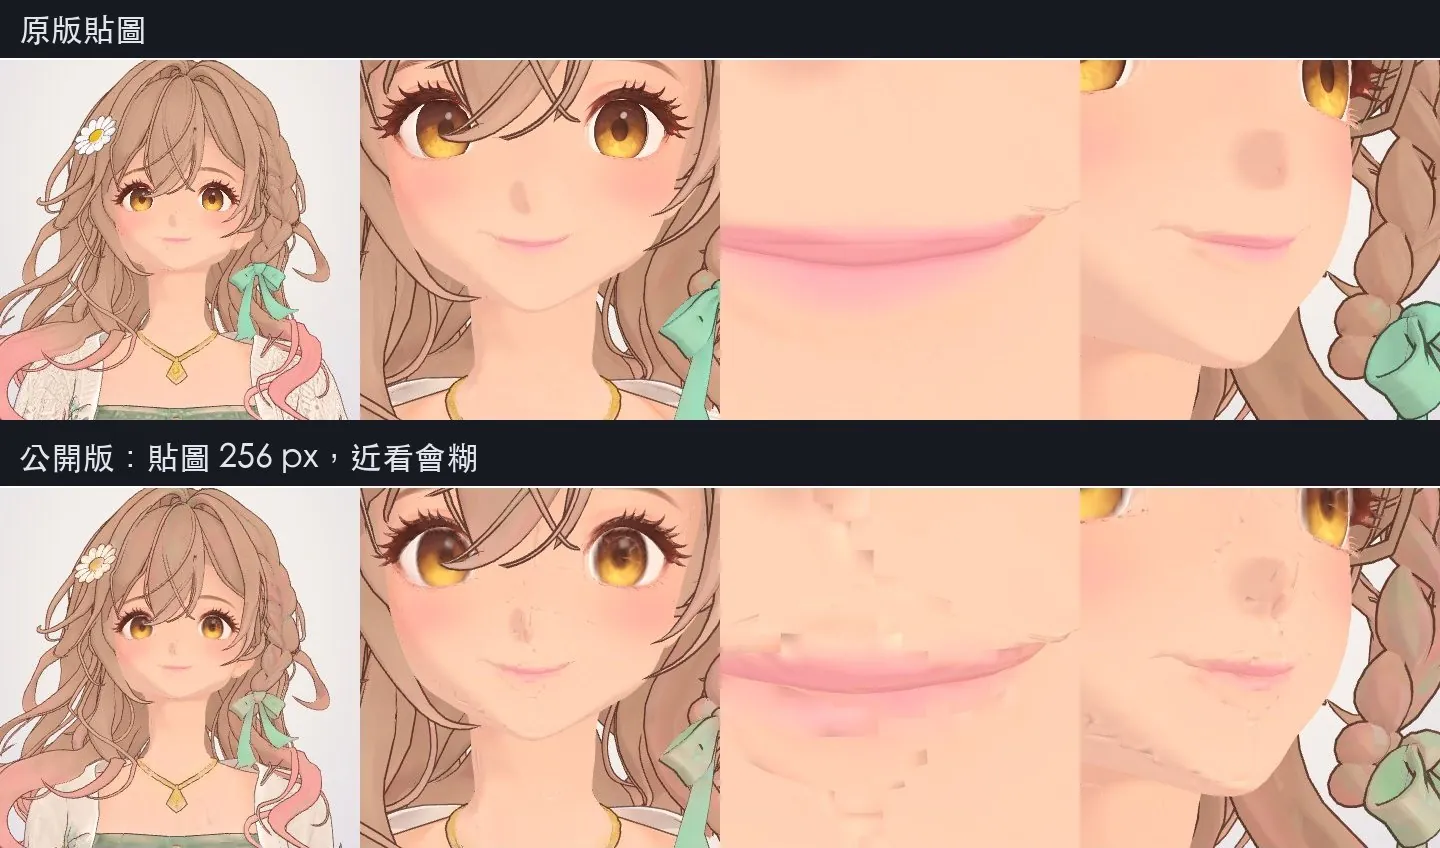
- 貼圖降到 256 px,原版留在自己的電腦裡
- 模型和動作加密傳送
- 貼圖裡藏了看不見的浮水印
網頁上能轉的模型,檔案終究會到讀者的電腦,這三層只能提高門檻。
驗收
授權一項一項查過。
- Mixamo:可以商用,不能散布原始動作檔。公開版只放轉換過的動作;這是我照遊戲的做法對條款的解讀,沒有向 Adobe 確認
- Bandai Namco 動作資料集:CC BY-NC-ND。套到別的角色上算改作,公開版沒放
- ElevenLabs 免費方案:標註 elevenlabs.io,不營利
花了多少
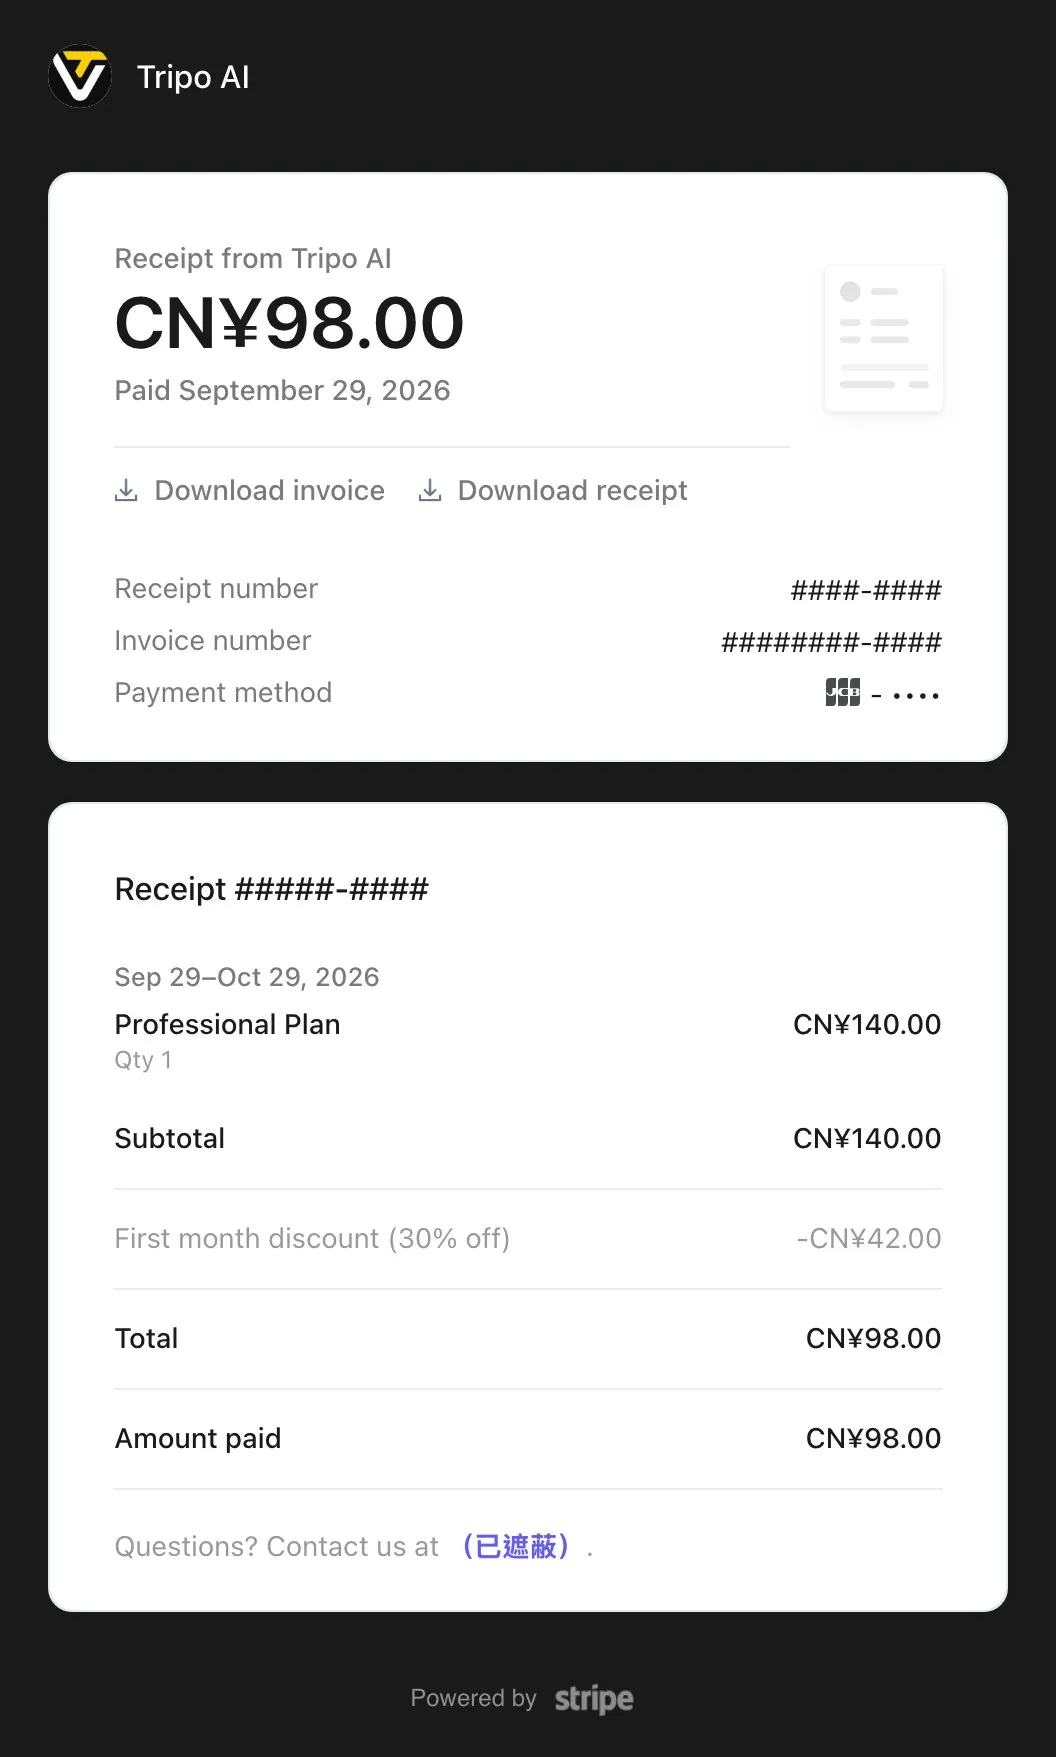
有紀錄的現金支出只有 Tripo 一個月的 Pro 方案:月費 CN¥140,首月七折,實付 CN¥98。2026-09-29 付款,計費期間 9/29–10/29。匯出 P2.0 的模型需要 Pro。
點數(有紀錄的部分,換裝的生成沒有記到):
| 用途 | 點數 |
|---|---|
| 頭、身體、頭髮的網格 | 300 |
| 身體、頭髮貼圖(頭用 8K 試用,0 點) | 40 |
| Auto Rig | 20 |
| 閉眼閉嘴參考頭 | 100 |
| 第一輪左右放反,作廢 | 360 |
其他工具:ElevenLabs 免費方案、Mixamo 免費、Blender 和 three.js 是開源軟體。ChatGPT 和 Opus 5.5 的訂閱費不算在上面的現金裡。
Opus 5.5 這一週寫的程式和修正,一共 93 個 commit。
還沒做完的
目前的已知問題:
- 閉眼時外眼角有一道細片,睫毛帶偏厚、有幾根尖刺;左眼從側面看還露出 1–3 條眼球縫
- 低頭加轉頭時,下巴底下還有淡淡的摺痕
- 右嘴角有 2 個小面轉折超過 60°
- 近看下唇下方有細細的顆粒
- T 字站姿時手臂會穿過頭髮(公開版預設手臂放下)
- 還沒在手機上測效能。公開版頁面的統計是約 27 萬個三角面,描邊會把模型再畫一次
下一步是把陽菜做成完整的換裝娃娃。下面三項都還沒試:
- 換裝系統
- 瞳色:眼球是獨立的網格,打算只換那一塊貼圖的顏色
- 表情:補上 VRM 標準的開心、難過、驚訝、放鬆
- 服裝和動作:繼續加
- 捏身材和臉型
- 身高、腿長、頭和臉的大小:打算縮放骨頭。預期的風險是非等比縮放會讓臉和手變形
- 胸圍、腰圍、臀圍、臉寬:打算做成 shape key,用滑桿調
- 衣服:每件衣服都要有一組跟身體對應的 shape key,身體調胖時衣服才會跟著變。預期這是工作量最大的一塊:每加一根身材滑桿,每件衣服都要多做一組
- webcam 動作捕捉:打算在瀏覽器裡偵測臉部和身體的特徵點,換算成骨頭角度和表情權重,即時套到陽菜身上。影像只在讀者的電腦裡處理,不上傳
玩玩看
拖曳可以轉視角,按鈕可以換髮型、衣服和表情,右上角選單有 38 個動作。為了降低模型被直接下載走的風險,網頁版的貼圖降到 256 px,近看會有點糊,這是正常的。
版權聲明
- 陽菜 Hina 的角色設計、3D 模型、貼圖、表情與換裝 © 2026 JonesHong。只供在本頁觀看,不得下載、轉載、再散布或改作
- 3D 網格與貼圖:以 Tripo AI 生成(tripo3d.ai)
- 設計圖與四視圖:以 ChatGPT(OpenAI)生成
- 聲音:以 ElevenLabs 生成(elevenlabs.io)
- 動作:Mixamo(© Adobe)。頁面只放轉換後的動作資料,不提供原始檔
- 網頁算繪:three.js(MIT,© three.js authors)、@pixiv/three-vrm 與 @pixiv/three-vrm-animation(MIT,© pixiv Inc.)
- 3D 編修:Blender(GNU GPL,Blender Foundation)
- 對嘴:wav2vec2 XLSR-53 音標辨識模型(Apache-2.0,Meta)
拿十個步驟對照你的角色檔
分開生成、逐層修接縫、表情看側面、公開前查授權:這四件事最容易漏。
把下面這段貼給你的 AI,讓它對照你手上的 3D 角色。
延伸閱讀
| 資源 | 為什麼重要 |
|---|---|
| Nano(@Dstudio_ai)的製作分享 | 頭和身體各 2 萬面,一半以上的時間在刷權重,臉部貼圖要手修。我們因此把每個部件設成 25,000 面。 |
| お寿司職人(@SushiNFTart)的長文 | 頭髮、頭、身體三件分開生成,嘴巴從張嘴的模型往回做。這套工作流的順序從這篇來。 |
| three-vrm 的 humanoidAnimation 範例 | Mixamo 動作怎麼轉到 VRM 骨架上。步驟 10 預先轉換動作,用的就是它的轉換程式。 |