AI 이미지 생성 3년:
영어 주문에서 중국어 한 문장으로
처음에는 제 컴퓨터에 Stable Diffusion WebUI를 설치했고, 이후 더 완성도 높은 결과와 편리함을 위해 Midjourney를 구독했습니다. 펑자대학교에서 AI 그림 수업도 두 번 했습니다. 그때는 이미지 한 장을 만들려면 영어 키워드와 네거티브 프롬프트, LoRA를 길게 나열해야 했지만, 2026년에는 쉬운 중국어 한 문장이면 충분합니다.
처음에는 제 컴퓨터에서 주문을 외웠습니다
Stable Diffusion은 2022년 8월 오픈 소스로 공개됐고, AUTOMATIC1111의 Stable Diffusion WebUI도 같은 달에 나왔습니다. 저는 2023년 2월 말에서 3월 초 사이에 제 컴퓨터에 이 WebUI를 설치해 사용하기 시작했습니다. 하드디스크에서 찾을 수 있는 가장 오래된 생성 이미지는 3월 24일자입니다. 나중에는 ComfyUI도 써 봤습니다. 그래픽 카드 성능이 부족할 때는 RunPod에서 클라우드 그래픽 카드를 빌렸고, 2023년 10월에 25달러, 2024년 3월에 10달러를 충전했습니다.
그때 마음에 드는 이미지 한 장을 만들려면 프롬프트가 문장보다는 주문에 가까웠습니다. 모델은 영어만 알아들었고, 짧은 단어가 더 잘 통했습니다. 인물, 동작, 조명, 화풍을 키워드마다 쉼표로 이어 쓰고, 앞에는 ‘품질 키워드’를 잔뜩 붙였습니다. 원하지 않는 요소도 손가락이 더 생기거나 몸이 뒤틀리거나, 흐릿하거나 워터마크가 찍히는 것처럼 네거티브 프롬프트에 하나씩 나열해야 했습니다. 특정 화풍이나 인물을 원하면 LoRA를 따로 적용하고 가중치도 조절해야 했습니다. 샘플러, 스텝 수, CFG까지 모든 설정이 결과에 영향을 줬습니다. 당시 흔한 작성 방식은 대략 이랬습니다(예시):
<code>긍정:masterpiece, best quality, 1girl, sitting by the window, morning light,
      backlighting, soft focus, pajamas, <lora:어떤 스타일:0.7>
네거티브:worst quality, low quality, lowres, bad anatomy, bad hands,
      extra fingers, deformed, blurry, watermark
Steps: 30, Sampler: DPM++ 2M Karras, CFG scale: 7, Size: 512x512
</code>
이미지 크기도 작았습니다. 기본은 512×512, 커 봐야 768×512였습니다. 더 큰 이미지를 원하면 작은 이미지를 먼저 만든 뒤 다른 모델로 확대해야 했습니다. 이렇게 모든 설정을 채워 넣어도 같은 설정으로 몇 번씩 다시 돌린 끝에야 손가락 수가 맞고 얼굴이 비뚤어지지 않은 한 장을 고를 수 있었습니다. ComfyUI는 이 모든 것을 노드 그래프로 펼쳐 보여 줬습니다. 제어할 수 있는 것은 많아졌지만 배우고 조절할 것도 그만큼 늘었습니다.
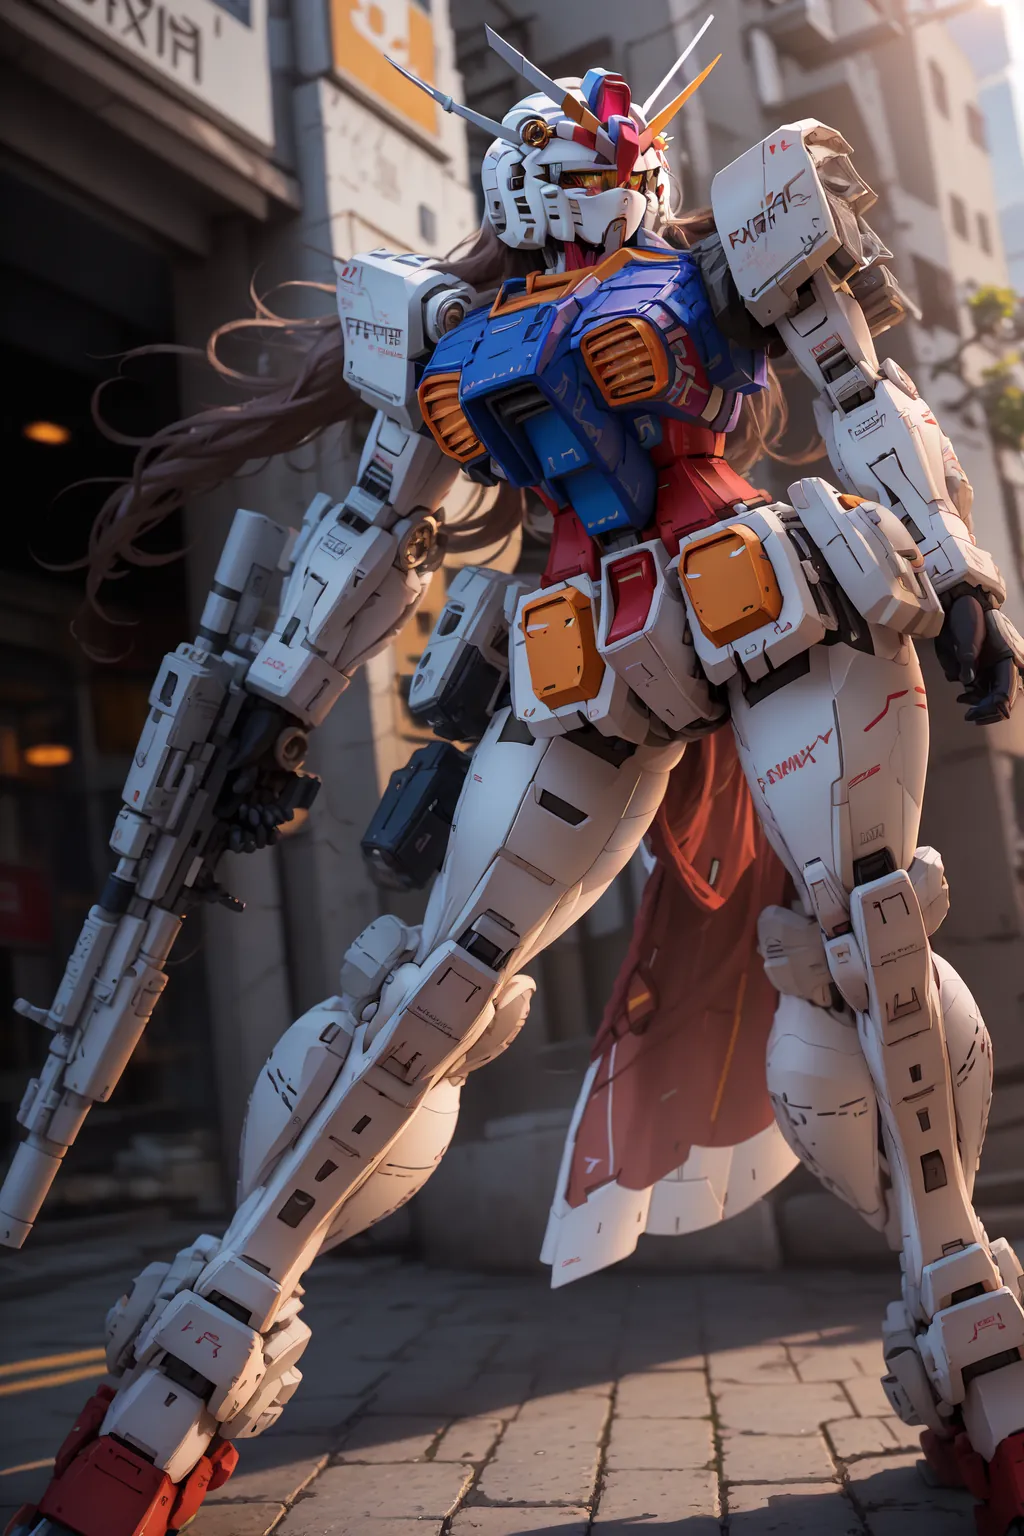
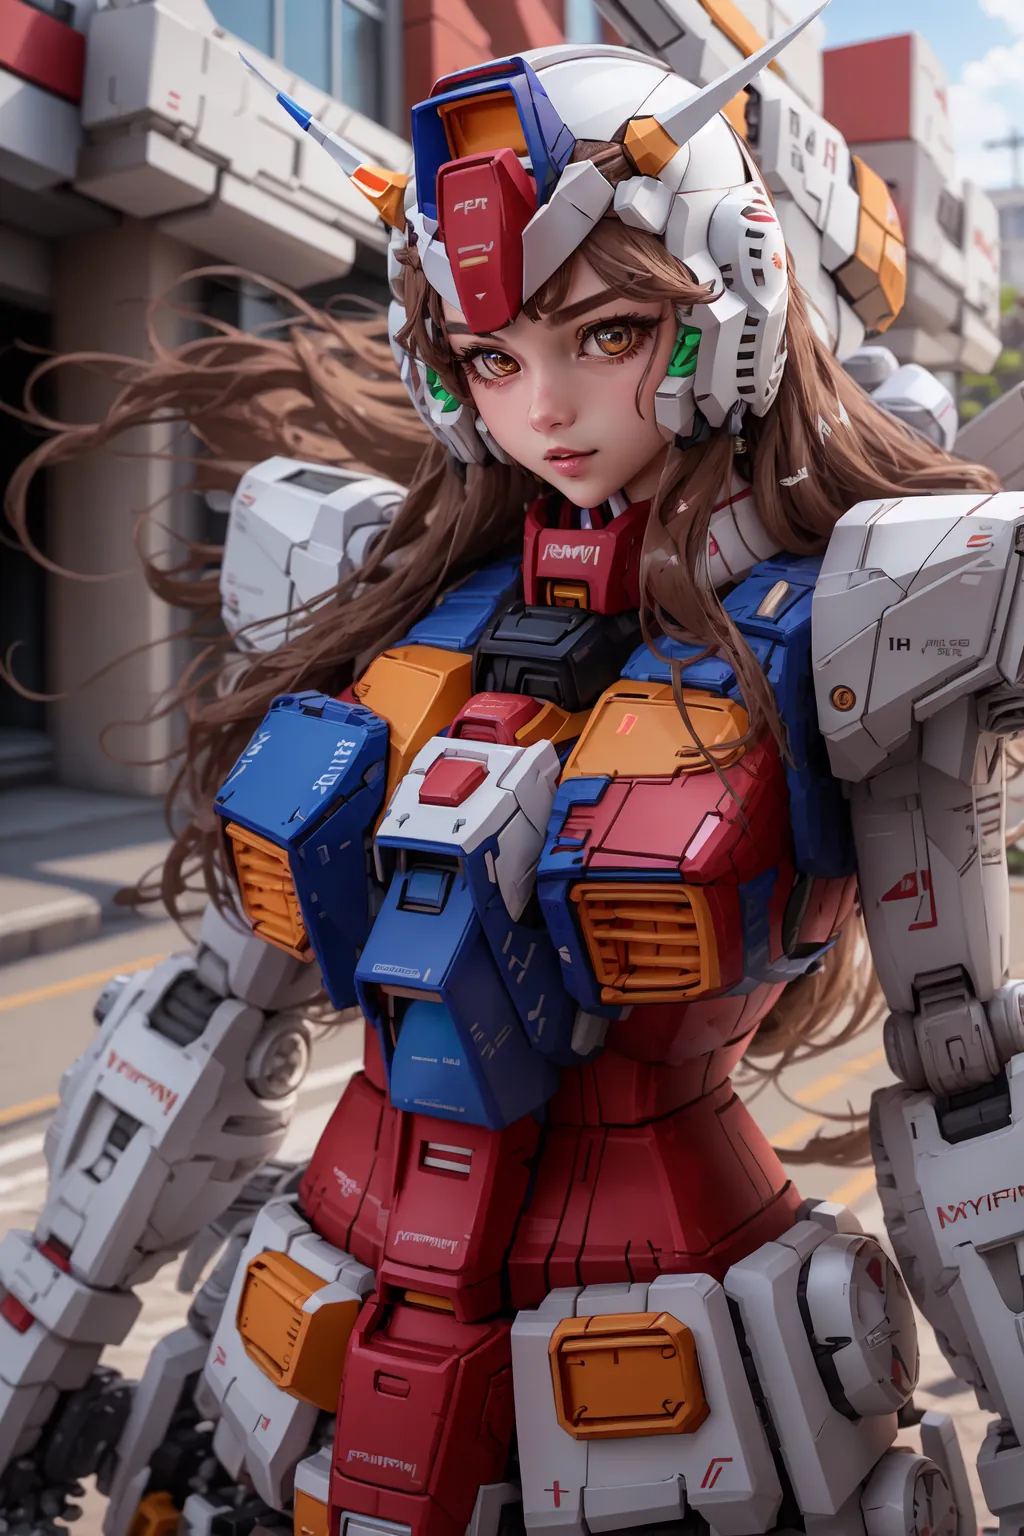
아래 두 장은 2023년 3월 29일 제 컴퓨터에서 이렇게 만들어 낸 이미지입니다. 긍정 프롬프트에는 키워드 33개와 LoRA 3개를 넣고, 네거티브 프롬프트에는 항목 64개를 적었습니다. 먼저 512×768로 생성한 뒤 SwinIR로 두 배 확대해 1024×1536으로 만들었고, 앞뒤로 합쳐 50+25스텝을 돌렸습니다.
로컬 모델은 NSFW 이미지를 시험하는 데 더 많이 썼습니다. 이런 이미지는 클라우드 서비스에서 생성해 주지 않아서 제 컴퓨터에서 직접 돌려야 했습니다.
2023: 완성도와 편리함을 위해 Midjourney를 구독했습니다
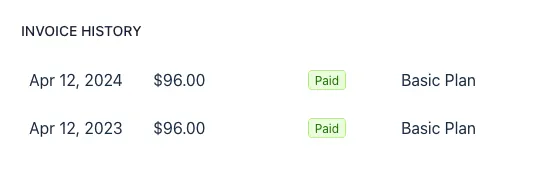
2023년 2월에 ChatGPT Plus를 시작했고(월 20달러), 4월에는 Midjourney의 Basic 요금제를 연간 결제로 구독했습니다. 1년에 96달러였고, 두 차례 구독했습니다. 구독한 이유는 간단합니다. 제 컴퓨터에서 주문을 외우고 설정을 조절하는 것에 비해 Midjourney의 이미지는 정교하고 보기 좋았으며, 결과도 안정적이고 사용하기도 편했습니다.
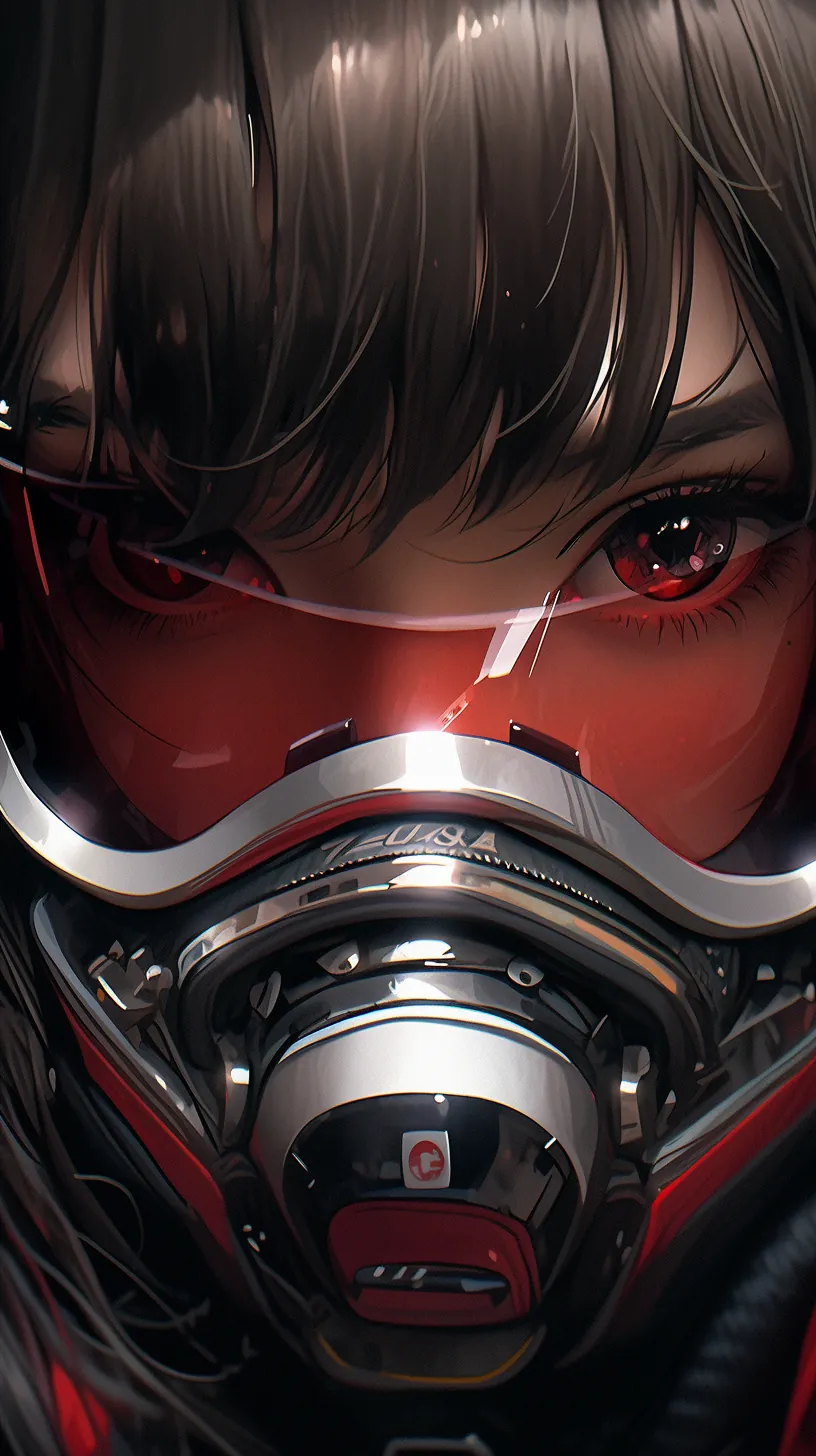
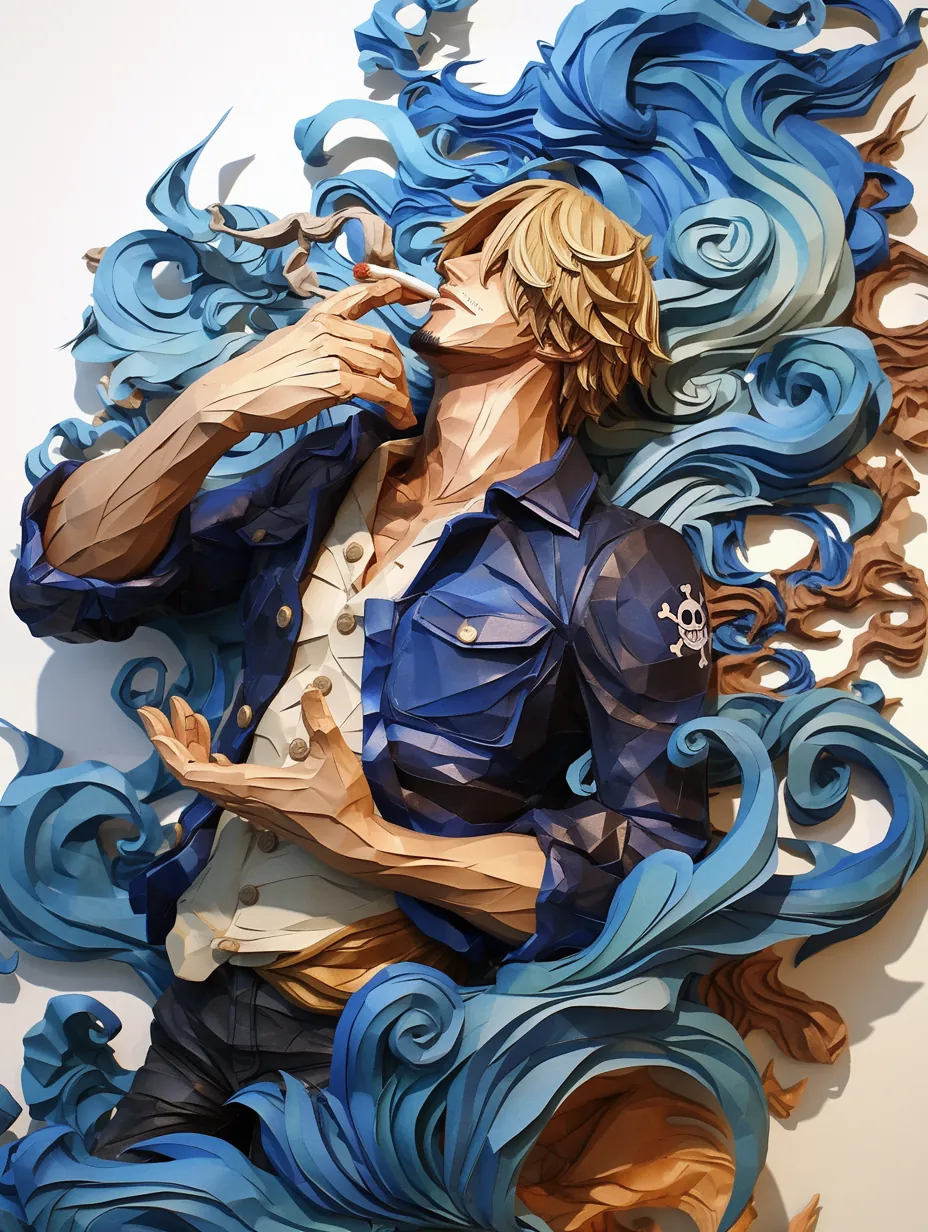
당시 Midjourney는 여전히 Discord에서 /imagine 명령어를 입력하는 방식이었습니다. 한 번에 이미지 네 장이 나오면 마음에 드는 것을 골라 확대하거나 변형했습니다. 아래 두 장은 그때 만든 이미지입니다:
펑자대학교에서 AI 그림을 가르치다
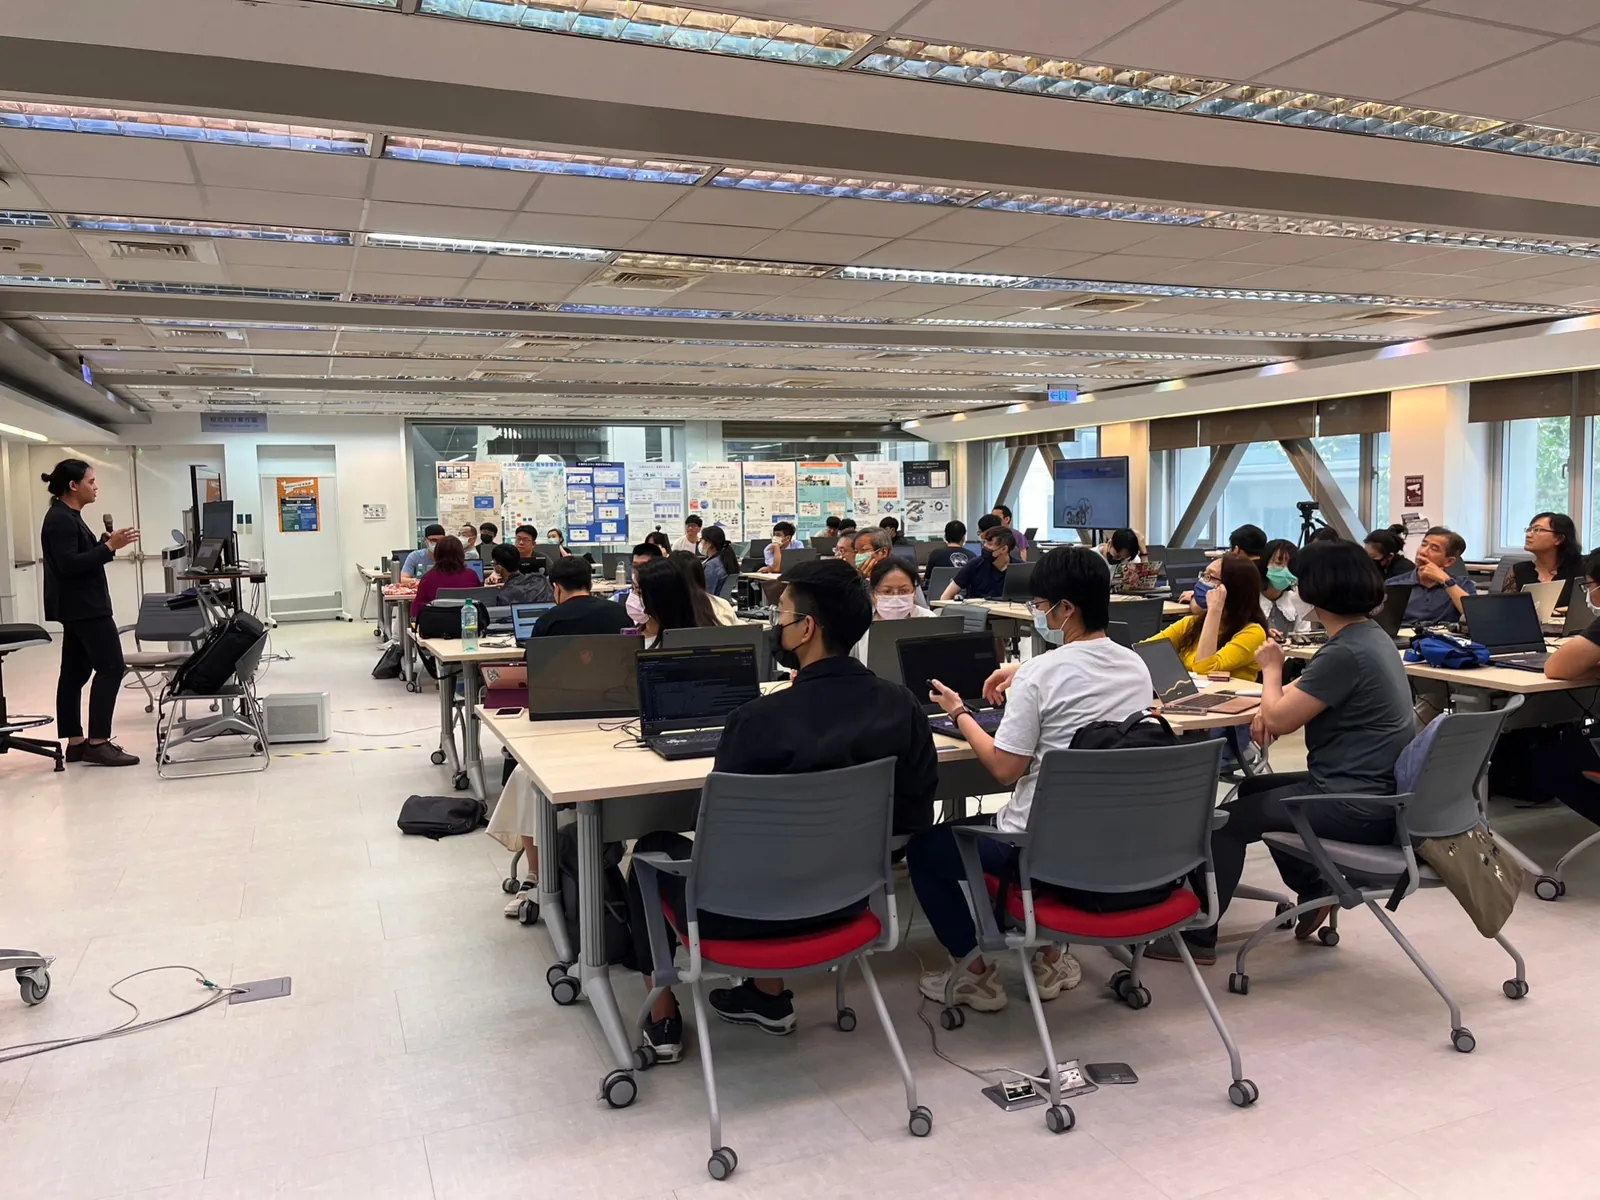
이 무렵 펑자대학교에서 AI 그림 수업을 두 번 열었습니다. 두 수업 모두 Stable Diffusion을 가르쳤습니다:
- 2023년 4월, 창능학원 AI 그림 워크숍은 5시간 동안 진행됐습니다. 수강생은 약 80명으로, 대학 전체 31개 학과와 3개 행정 부서에서 왔습니다(보도자료·발표 자료)
- 2024년 3월에는 중문학과에서 ‘Stable Diffusion 실습’을 진행했습니다. 세 차례에 걸쳐 총 6시간 동안 프롬프트, 텍스트로 이미지 생성, 이미지로 이미지 생성부터 LoRA 학습과 ControlNet까지 다뤘습니다(교재 I·II·III)
2026: 중국어 한 문장이면 충분합니다
2026년 9월, 집에 있는 RTX 3090 컴퓨터에 Qwen-Image 2.1과 Z-Image Turbo를 설치하고 제 용도로 쓸 웹 인터페이스도 만들었습니다. 문장을 입력하고 모델을 고른 뒤 생성 버튼을 누르면 됩니다. 휴대전화에서도 쓸 수 있습니다. 다시 돌아와 가장 크게 느낀 변화는 ‘이미지를 만들 수 있다’는 사실이 아니라 과정 전체가 매끄러워졌다는 점입니다. 중국어 한 문장을 입력하고 버튼을 누르면 제가 원하던 이미지가 나옵니다.
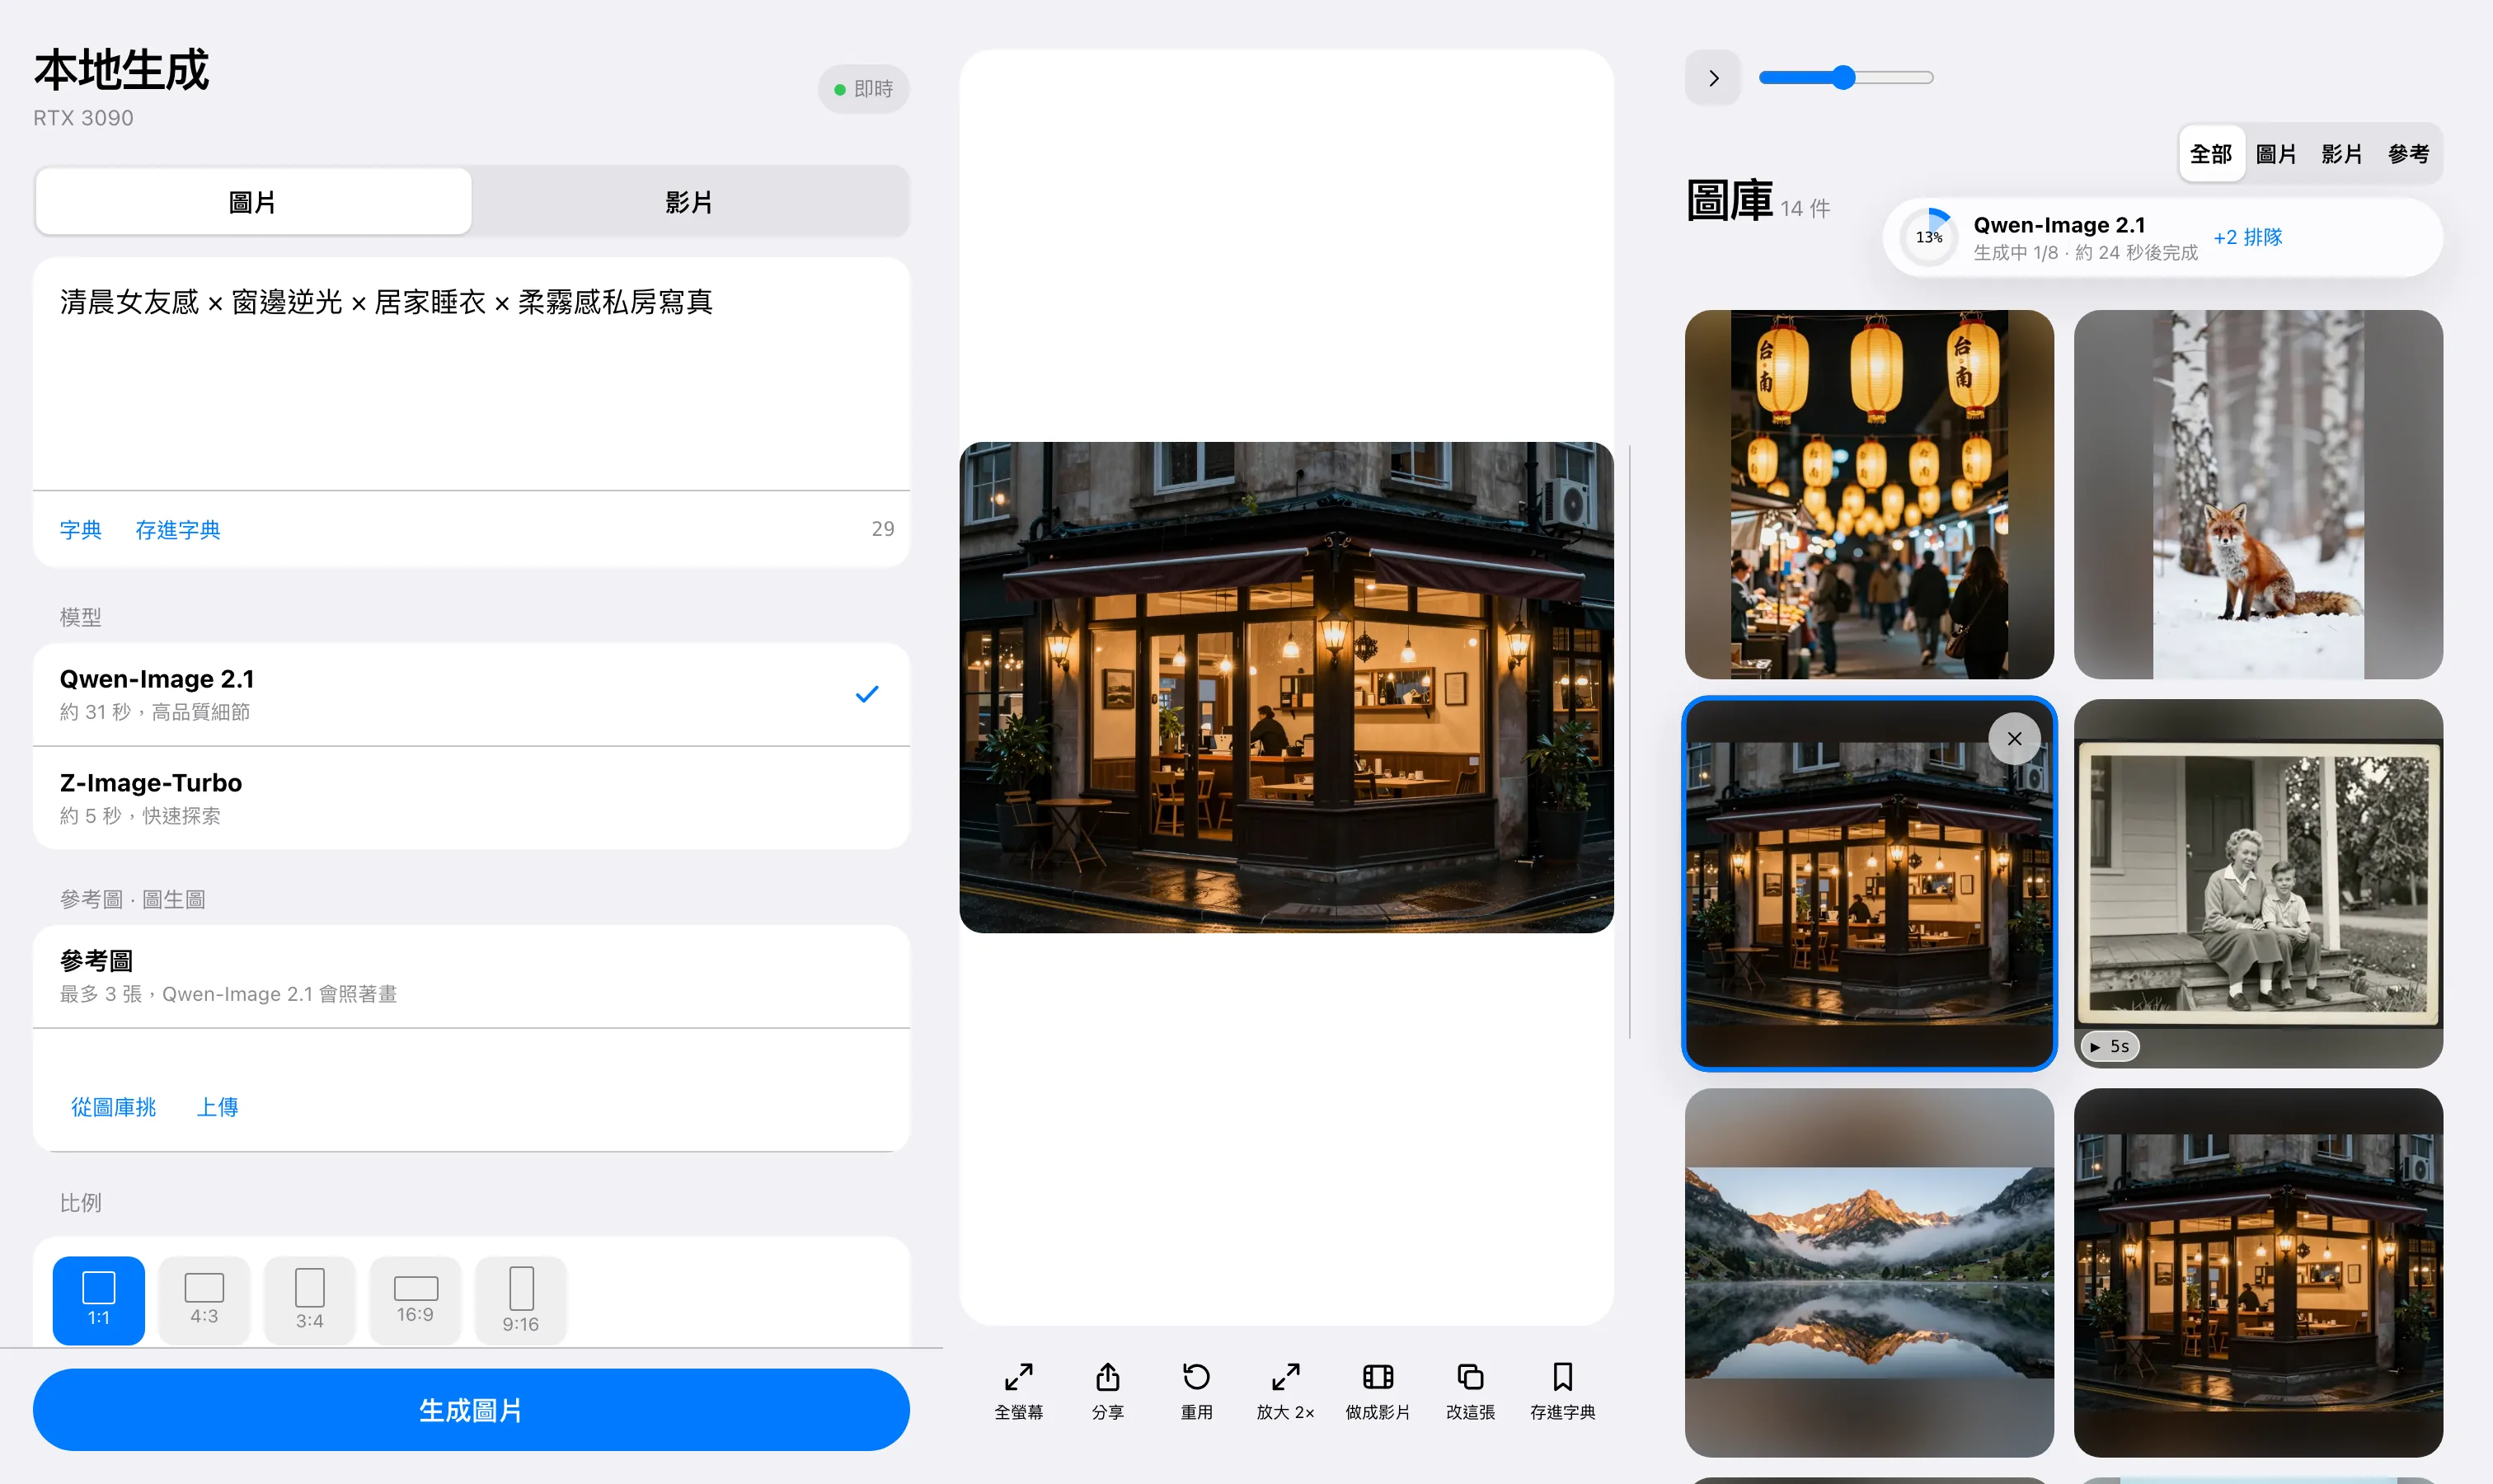
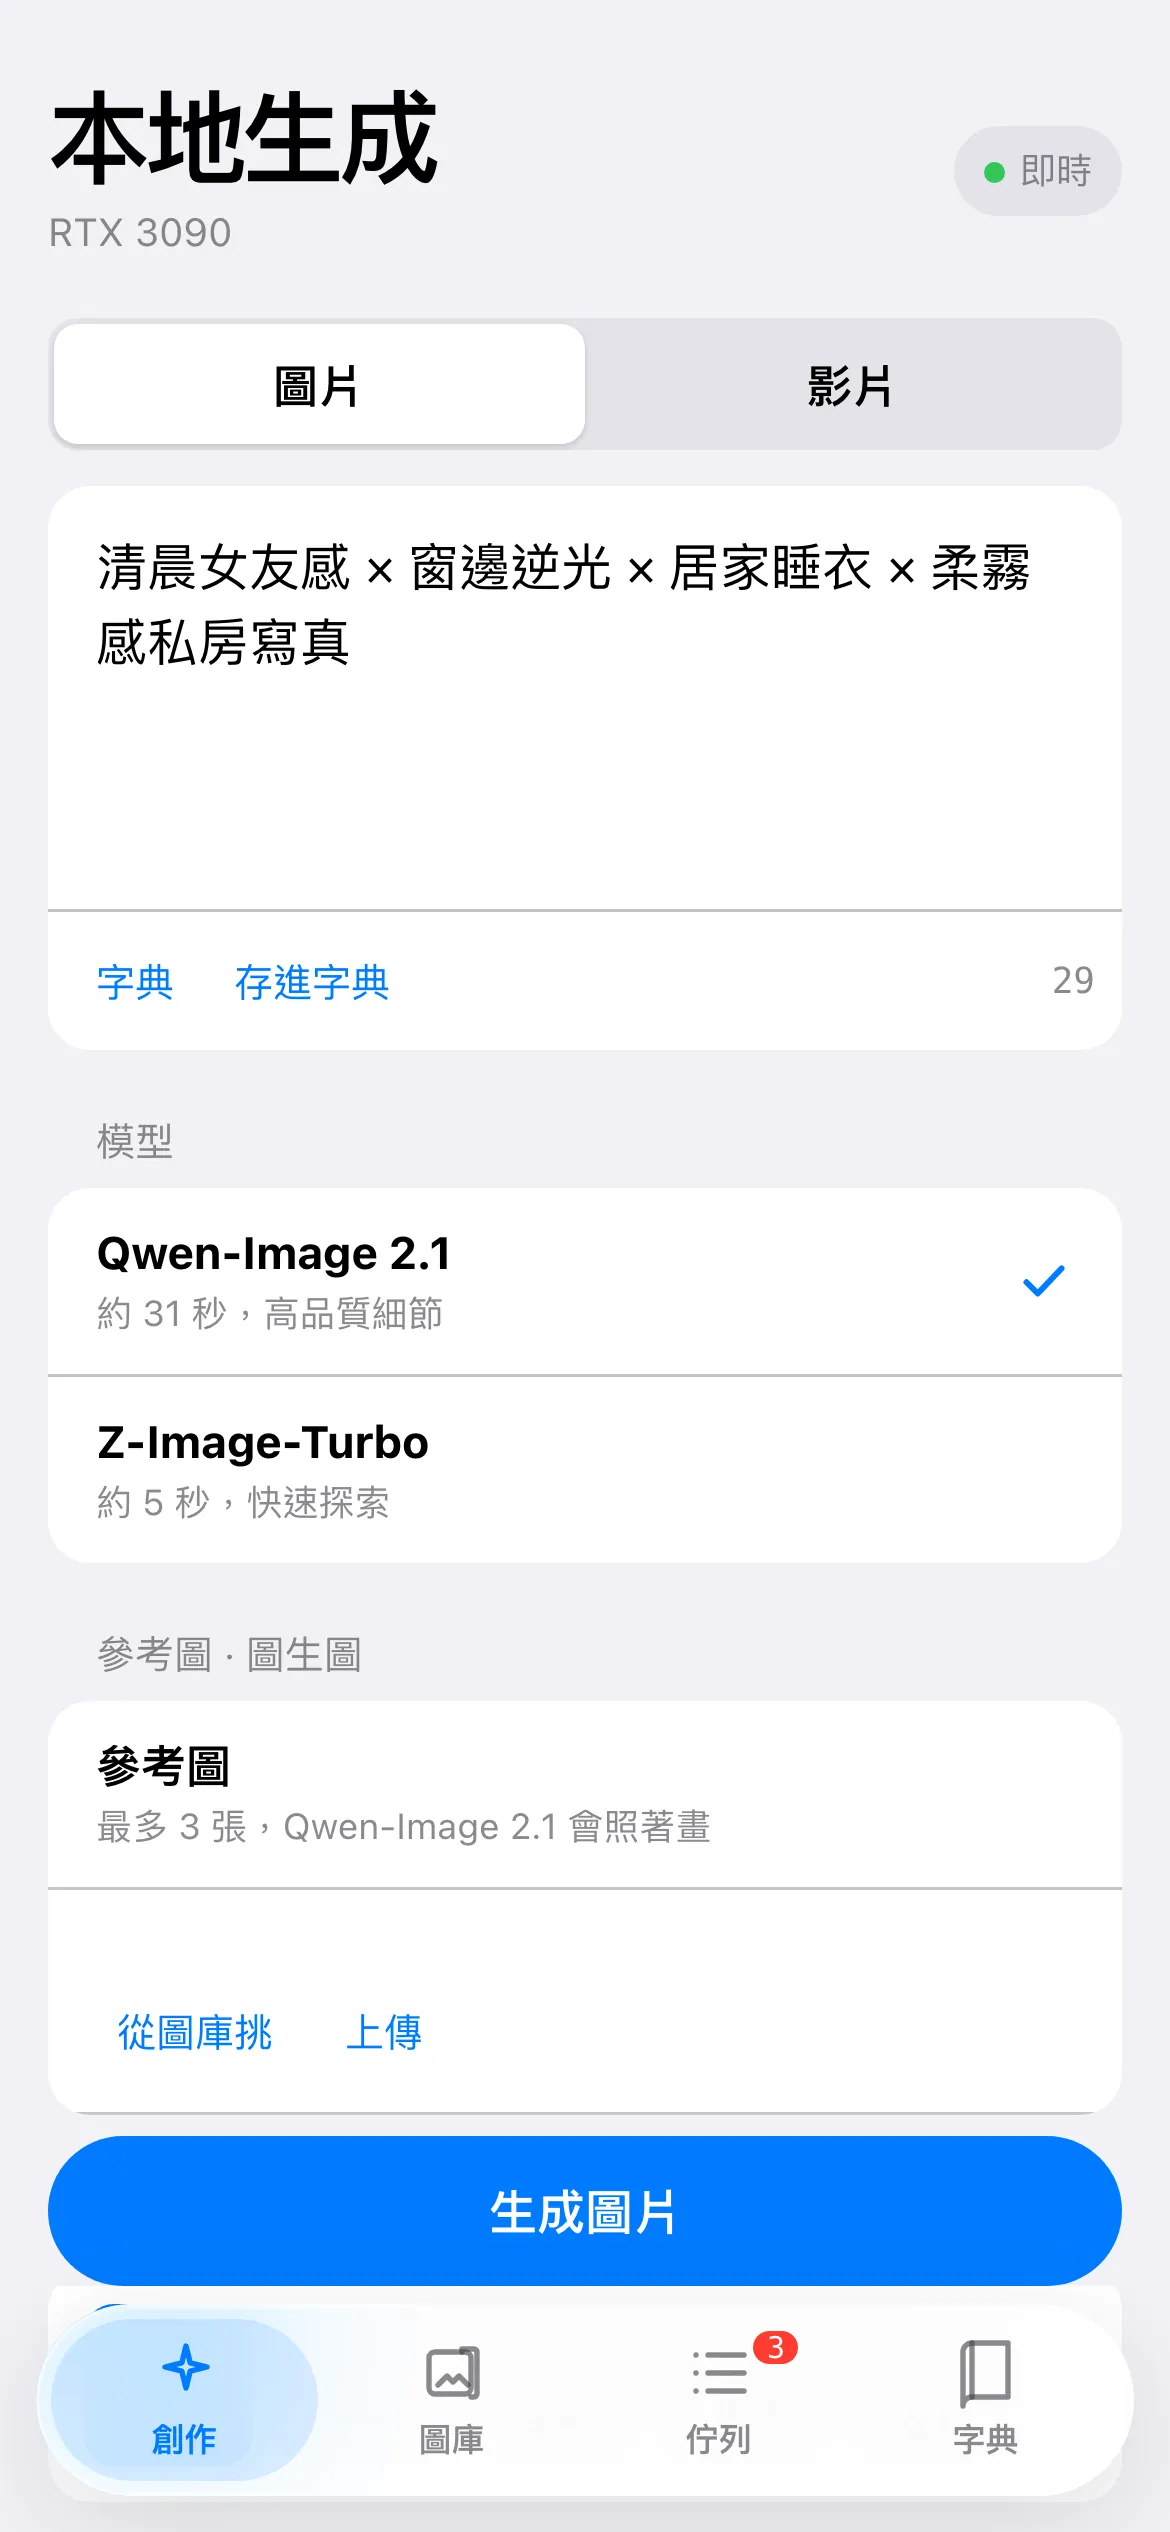
스크린샷의 입력창에 보이는 한 줄이 바로 아래 이미지에 실제로 사용한 프롬프트입니다. Qwen-Image 2.1로 만든 이 이미지에 입력한 프롬프트는 딱 한 줄입니다:
이른 아침의 여자친구 같은 느낌 × 창가의 역광 × 집에서 입는 잠옷 × 부드럽고 뿌연 느낌의 사적인 인물 사진
중국어 구절 몇 개뿐입니다. 품질 키워드도, 네거티브 프롬프트도, LoRA도 없고 설정은 전부 기본값입니다. 별도로 확대할 필요 없이 바로 768×1344로 나옵니다. 40스텝에 45.7초가 걸렸습니다.
Z-Image Turbo는 다른 방식을 택합니다. 같은 형식의 프롬프트에서 잠옷만 레이스 속옷으로 바꾸고 8스텝만 돌렸더니 한 장에 4.2초가 걸렸습니다. Qwen보다 열 배 빨랐습니다. 왼쪽이 Qwen, 오른쪽이 Z-Image입니다:
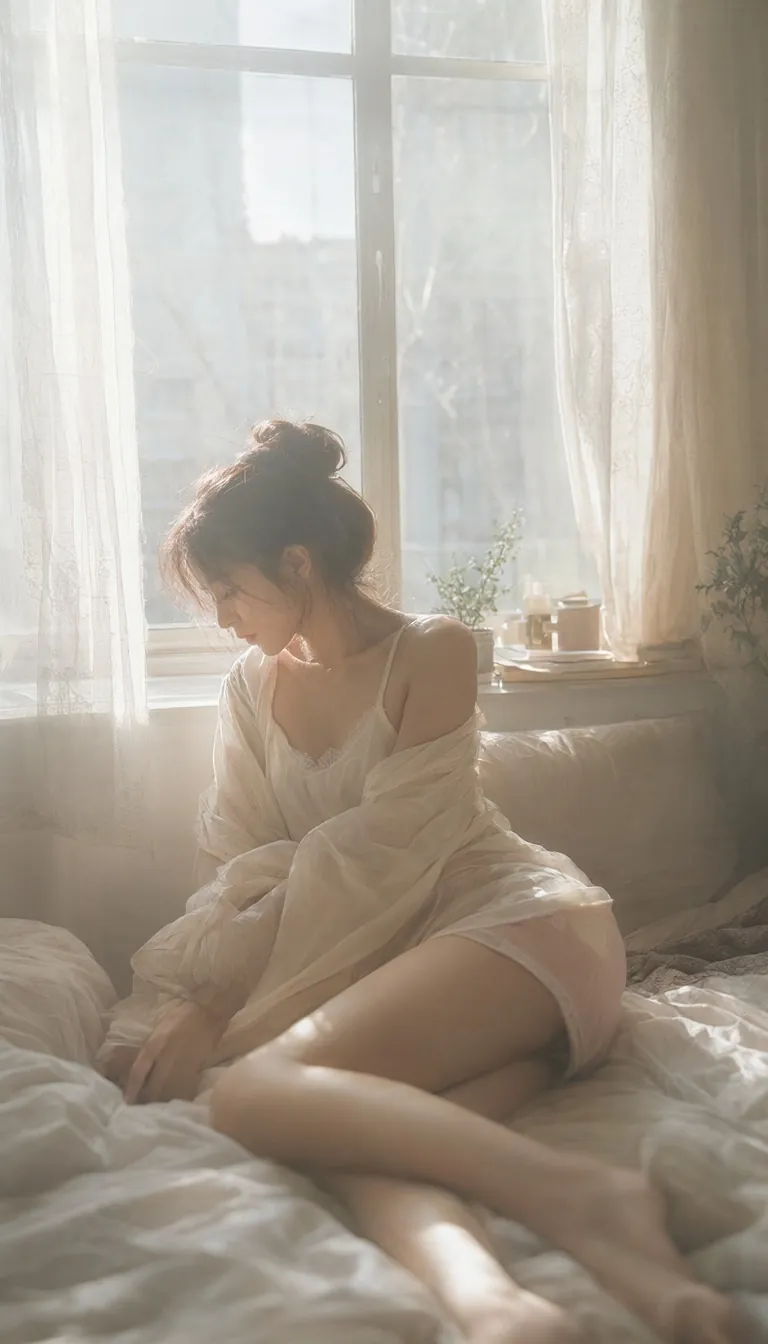
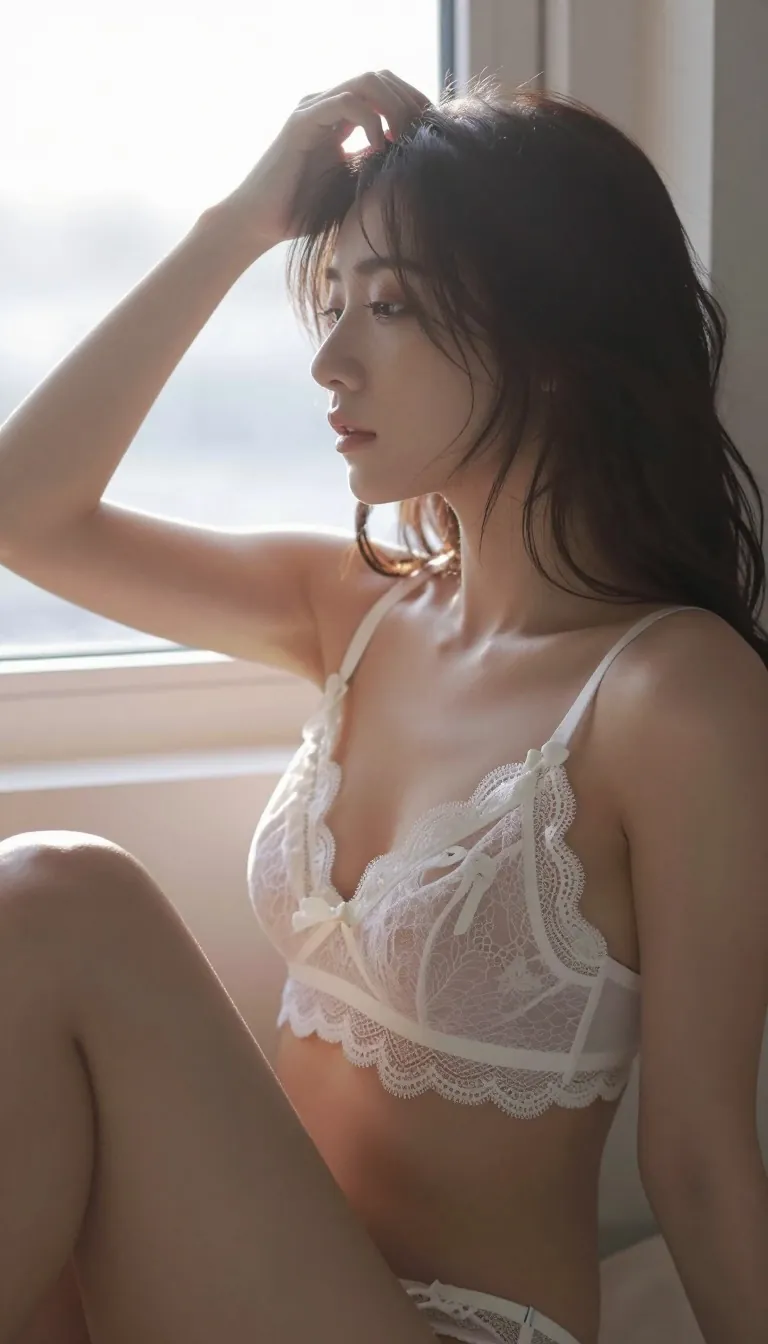
프롬프트에 적은 요소가 모두 이미지에 담겼습니다. 이른 아침의 창가, 역광, 부드럽고 뿌연 질감, 집에서 입는 잠옷입니다. 예전에는 손가락과 신체 비율이 가장 걱정이었는데, 이 두 이미지에는 그런 문제도 없었습니다.
3년 사이 달라진 것은 속도와 크기만이 아닙니다. 모델에 말을 거는 방식이 영어 키워드의 나열에서 중국어 한 문장으로 바뀌었습니다.
이미지도 움직이기 시작했습니다
같은 방식은 영상에도 쓸 수 있습니다. 생성한 이미지 한 장을 첫 프레임으로 삼고 어떻게 움직일지 중국어 한 문장으로 설명하면 같은 그래픽 카드로 5초짜리 영상을 만들 수 있습니다. 클라우드의 Seedance는 결과가 더 놀랍지만 비용도 훨씬 비쌉니다. 이런 이야기와 최근 저를 다시 한번 놀라게 한 AI가 처음부터 끝까지 영상 한 편을 완성하는 이야기까지 다음 글 〈AI로 영상 만들기: 화면은 어떻게 움직이고 비용은 얼마나 들까〉에서 다룹니다.
옛 주문을 쉬운 한 문장으로 바꾸기
3년 사이 달라진 것은 모델에 말을 거는 방식입니다. 영어 키워드의 나열이 중국어 한 문장으로 바뀌었습니다.
예전에 쓴 프롬프트가 남아 있다면 여러분의 AI에 붙여 넣고 이 글의 비교를 참고해 다시 써 달라고 해 보세요.
더 읽을거리
| 자료 | 중요한 이유 |
|---|---|
| AI로 영상 만들기: 화면은 어떻게 움직이고 비용은 얼마나 들까 | 다음 글: 한 문장으로 만드는 같은 방식을 영상에 적용하고, AI가 영상 한 편을 완성하는 방법과 그 비용을 다룹니다. |
| 펑자대학교 Stable Diffusion 실습 교재 I | 2024년 수업에서 사용한 교재입니다. 프롬프트, 텍스트로 이미지 생성, 이미지로 이미지 생성부터 설명하며 당시 주문을 어떻게 썼는지 볼 수 있습니다. |
| 교재 II | 같은 수업의 두 번째 시간입니다. |
| 교재 III | 세 번째 시간에는 LoRA 학습과 ControlNet까지 다뤘습니다. |