AI 生圖三年:
從英文咒語到一句中文
先在自己的電腦上架 Stable Diffusion WebUI,再為了精緻和省事訂 Midjourney,也在逢甲大學教過兩次 AI 繪圖。當年生一張圖要疊一長串英文關鍵字、負向提示詞和 LoRA,2026 年用一句中文白話就夠了。
一開始:在自己的電腦上念咒
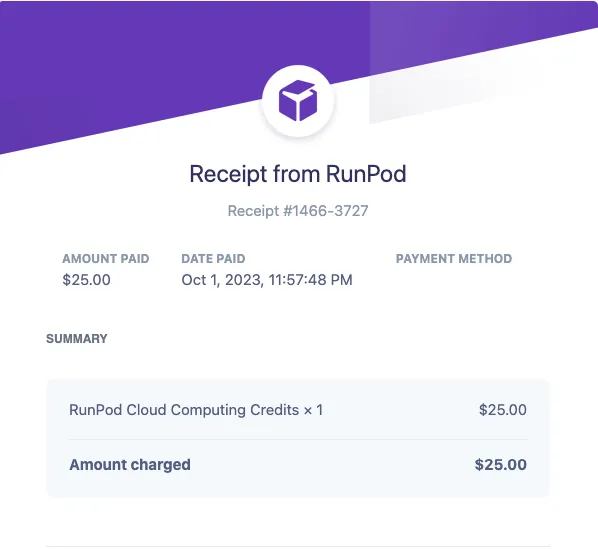
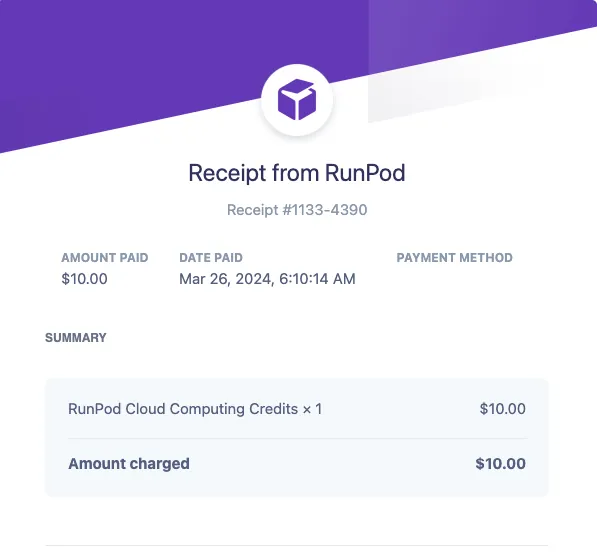
Stable Diffusion 在 2022 年 8 月開源,AUTOMATIC1111 的 Stable Diffusion WebUI 也在同一個月出現。我是 2023 年 2 月底、3 月初,在自己的電腦上架了這套 WebUI 開始玩(硬碟裡翻得到最早的出圖是 3 月 24 日),後來也用過 ComfyUI。顯示卡不夠用的時候,就去 RunPod 租雲端顯示卡,2023 年 10 月儲值 25 美元,2024 年 3 月又儲值 10 美元。
那時候要生出一張滿意的圖,提示詞比較像咒語,不像句子。模型只聽得懂英文,而且最好是短詞:人物、動作、光線、畫風,一個關鍵字一個關鍵字用逗號接起來,前面再疊一串「品質詞」;另外還要寫一串負向提示詞,把不想要的東西一條條列出來,像是多出來的手指、變形的身體、模糊、浮水印。想要特定的畫風或人物,就要另外掛 LoRA、調它的權重;取樣器、步數、CFG,每一個參數都會影響結果。那時候常見的寫法大概長這樣(示意):
正向:masterpiece, best quality, 1girl, sitting by the window, morning light,
      backlighting, soft focus, pajamas, <lora:某個風格:0.7>
負向:worst quality, low quality, lowres, bad anatomy, bad hands,
      extra fingers, deformed, blurry, watermark
Steps: 30, Sampler: DPM++ 2M Karras, CFG scale: 7, Size: 512x512
尺寸也很小。基本款就是 512×512,頂多 768×512,想要大一點的圖,得先生小圖,再用另一個模型放大。就算這樣全部寫齊了,同一組設定常常要重跑好幾輪,才挑得出一張手指數對、臉沒歪的。ComfyUI 把這些全部攤成一張節點圖,能控制的東西更多,要學、要調的東西也更多。
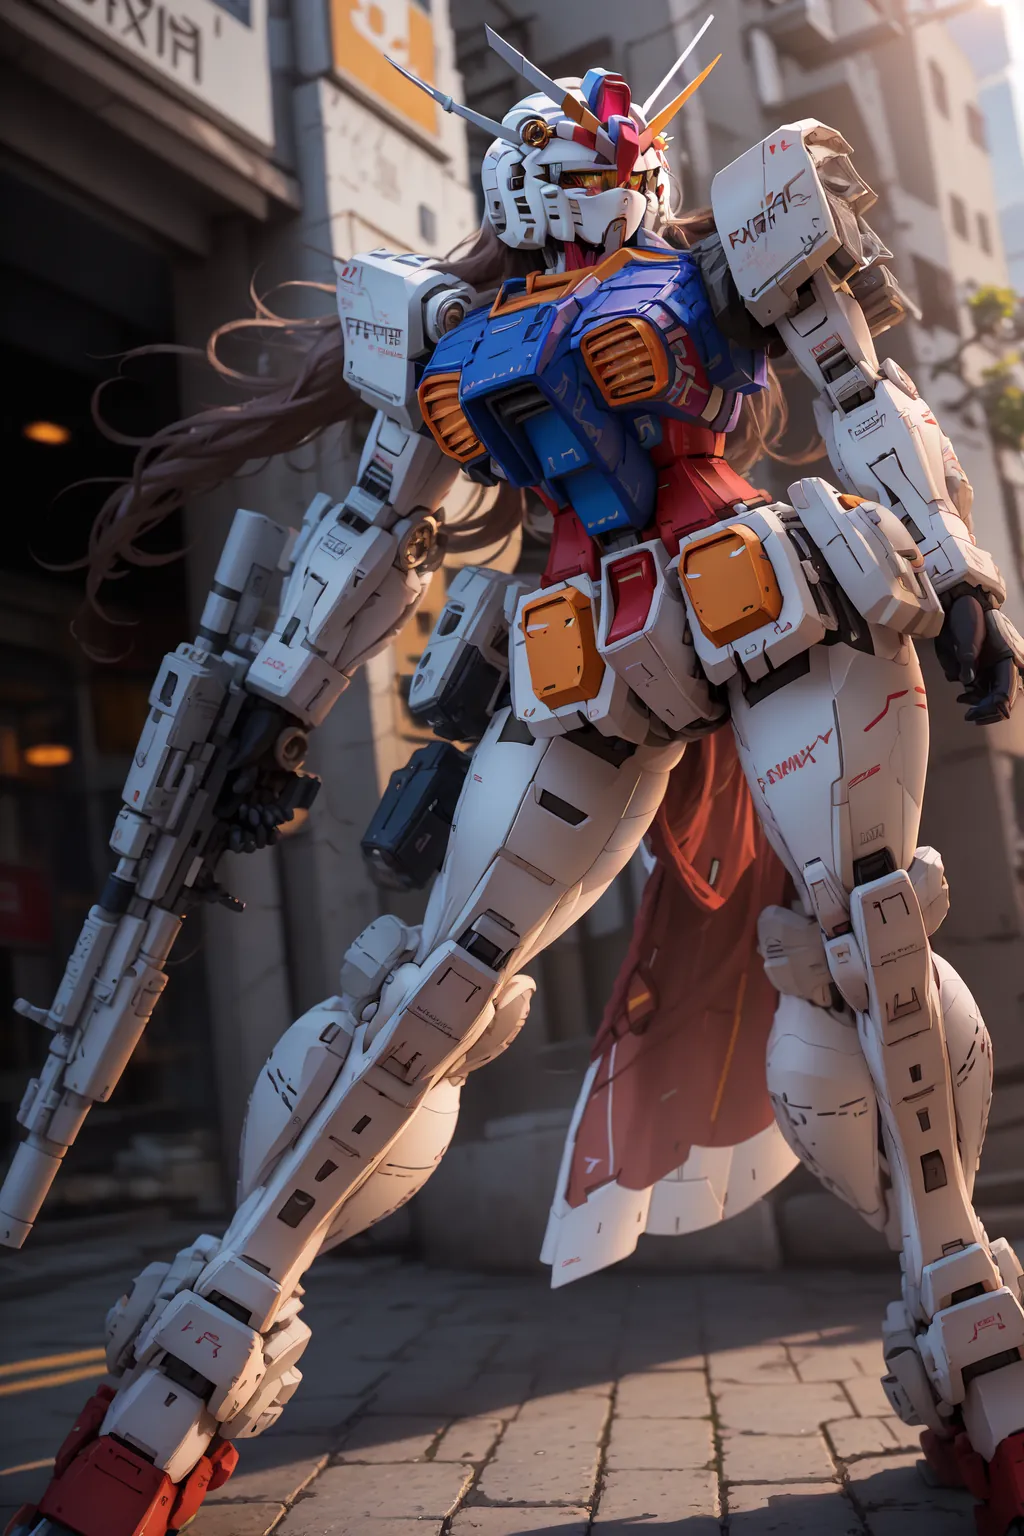
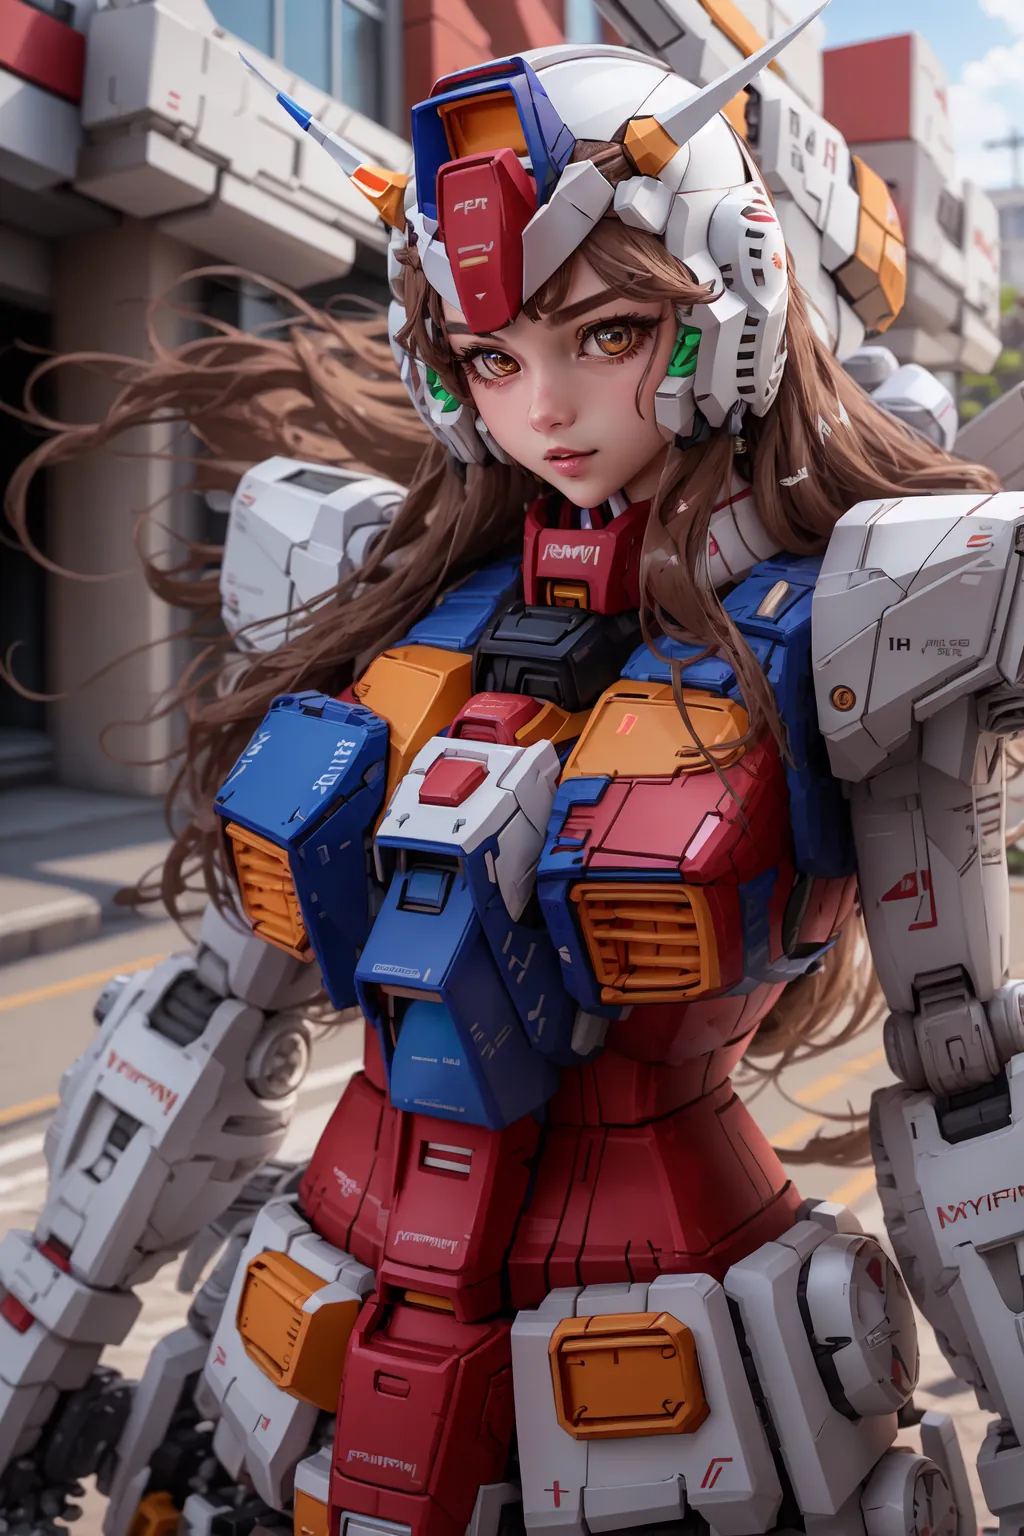
下面兩張是 2023 年 3 月 29 日在自己電腦上生的,就是這樣念出來的:正向提示詞 33 個關鍵字、掛 3 個 LoRA,負向提示詞 64 條;先生 512×768,再用 SwinIR 放大兩倍到 1024×1536,前後跑了 50+25 步。
本地模型我更多是拿來測試 NSFW 的圖。這類圖雲端服務不給畫,只能在自己的機器上跑。
2023:為了精緻和省事,訂了 Midjourney
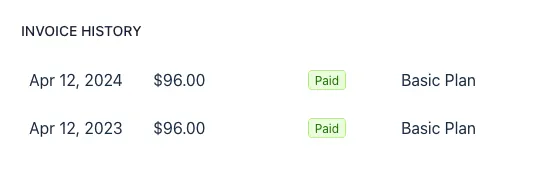
2023 年 2 月我開了 ChatGPT Plus(每月 20 美元),4 月訂了 Midjourney 的 Basic 方案,選年繳,一年 96 美元,前後續了兩期。訂它的原因很單純:跟在自己電腦上念咒、調參數比起來,Midjourney 的圖精緻漂亮,出圖穩定可靠,用起來也輕鬆。
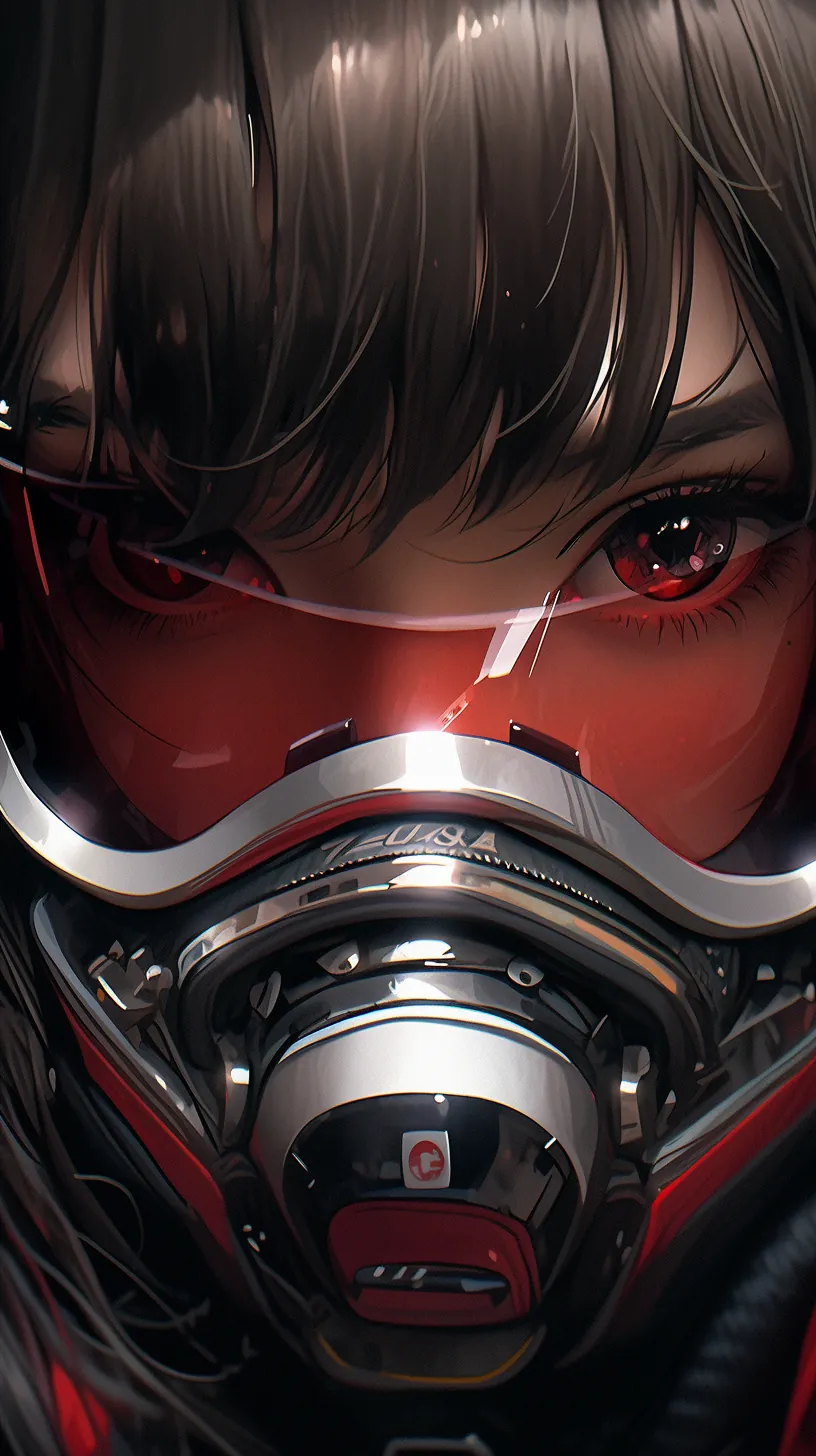
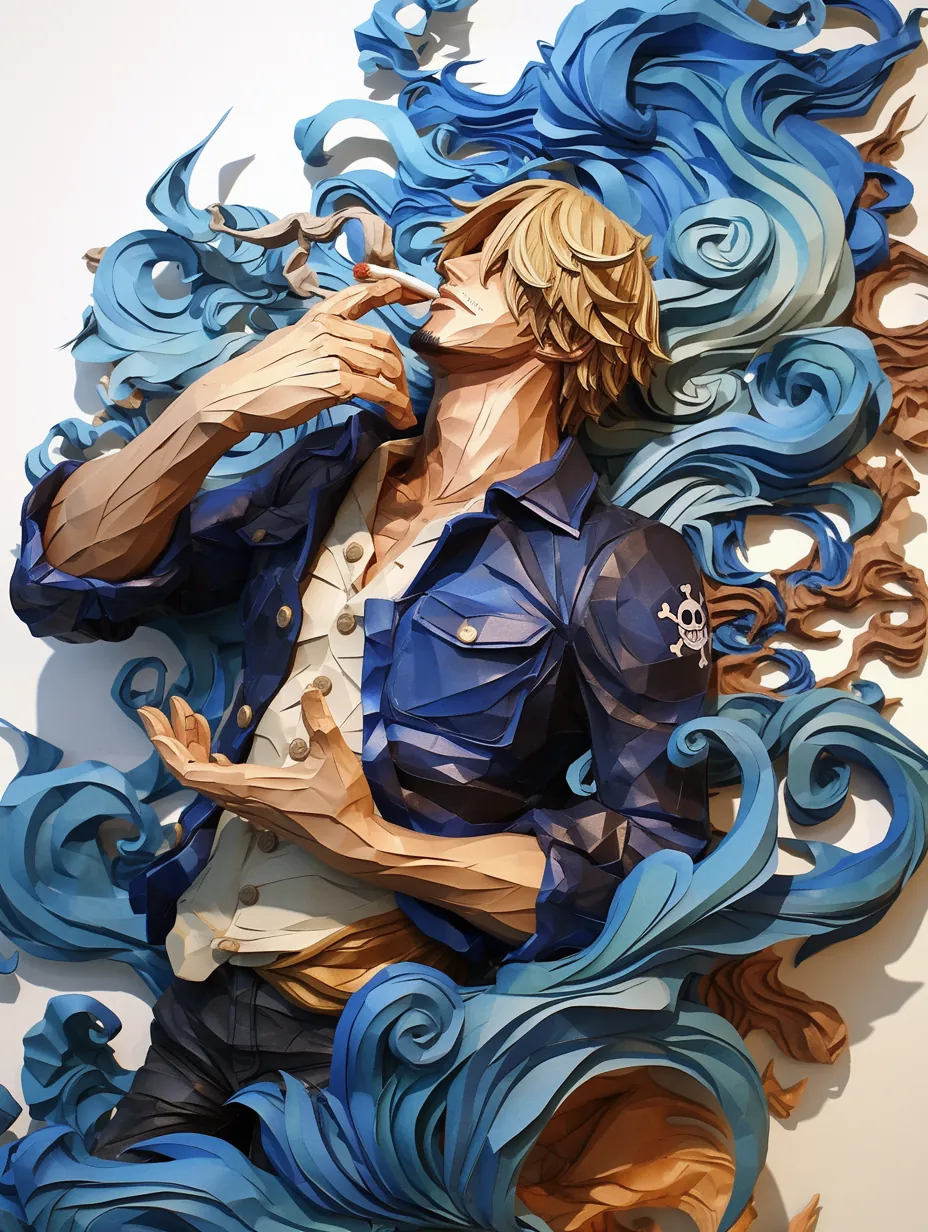
當時的 Midjourney 還是在 Discord 裡打 /imagine 下指令,一次吐四張,挑喜歡的放大或變化。下面兩張是那時候畫的:
2026:一句中文就夠了
2026 年 9 月,我在家裡那台 RTX 3090 上裝了 Qwen-Image 2.1 和 Z-Image Turbo,順手做了一個自己用的網頁介面:打一句話、選模型、按生成,手機上也能用。回來之後最大的感受不是「畫得出來」,是整個過程變得很順:打一句中文,按下去,出來的就是我要的。
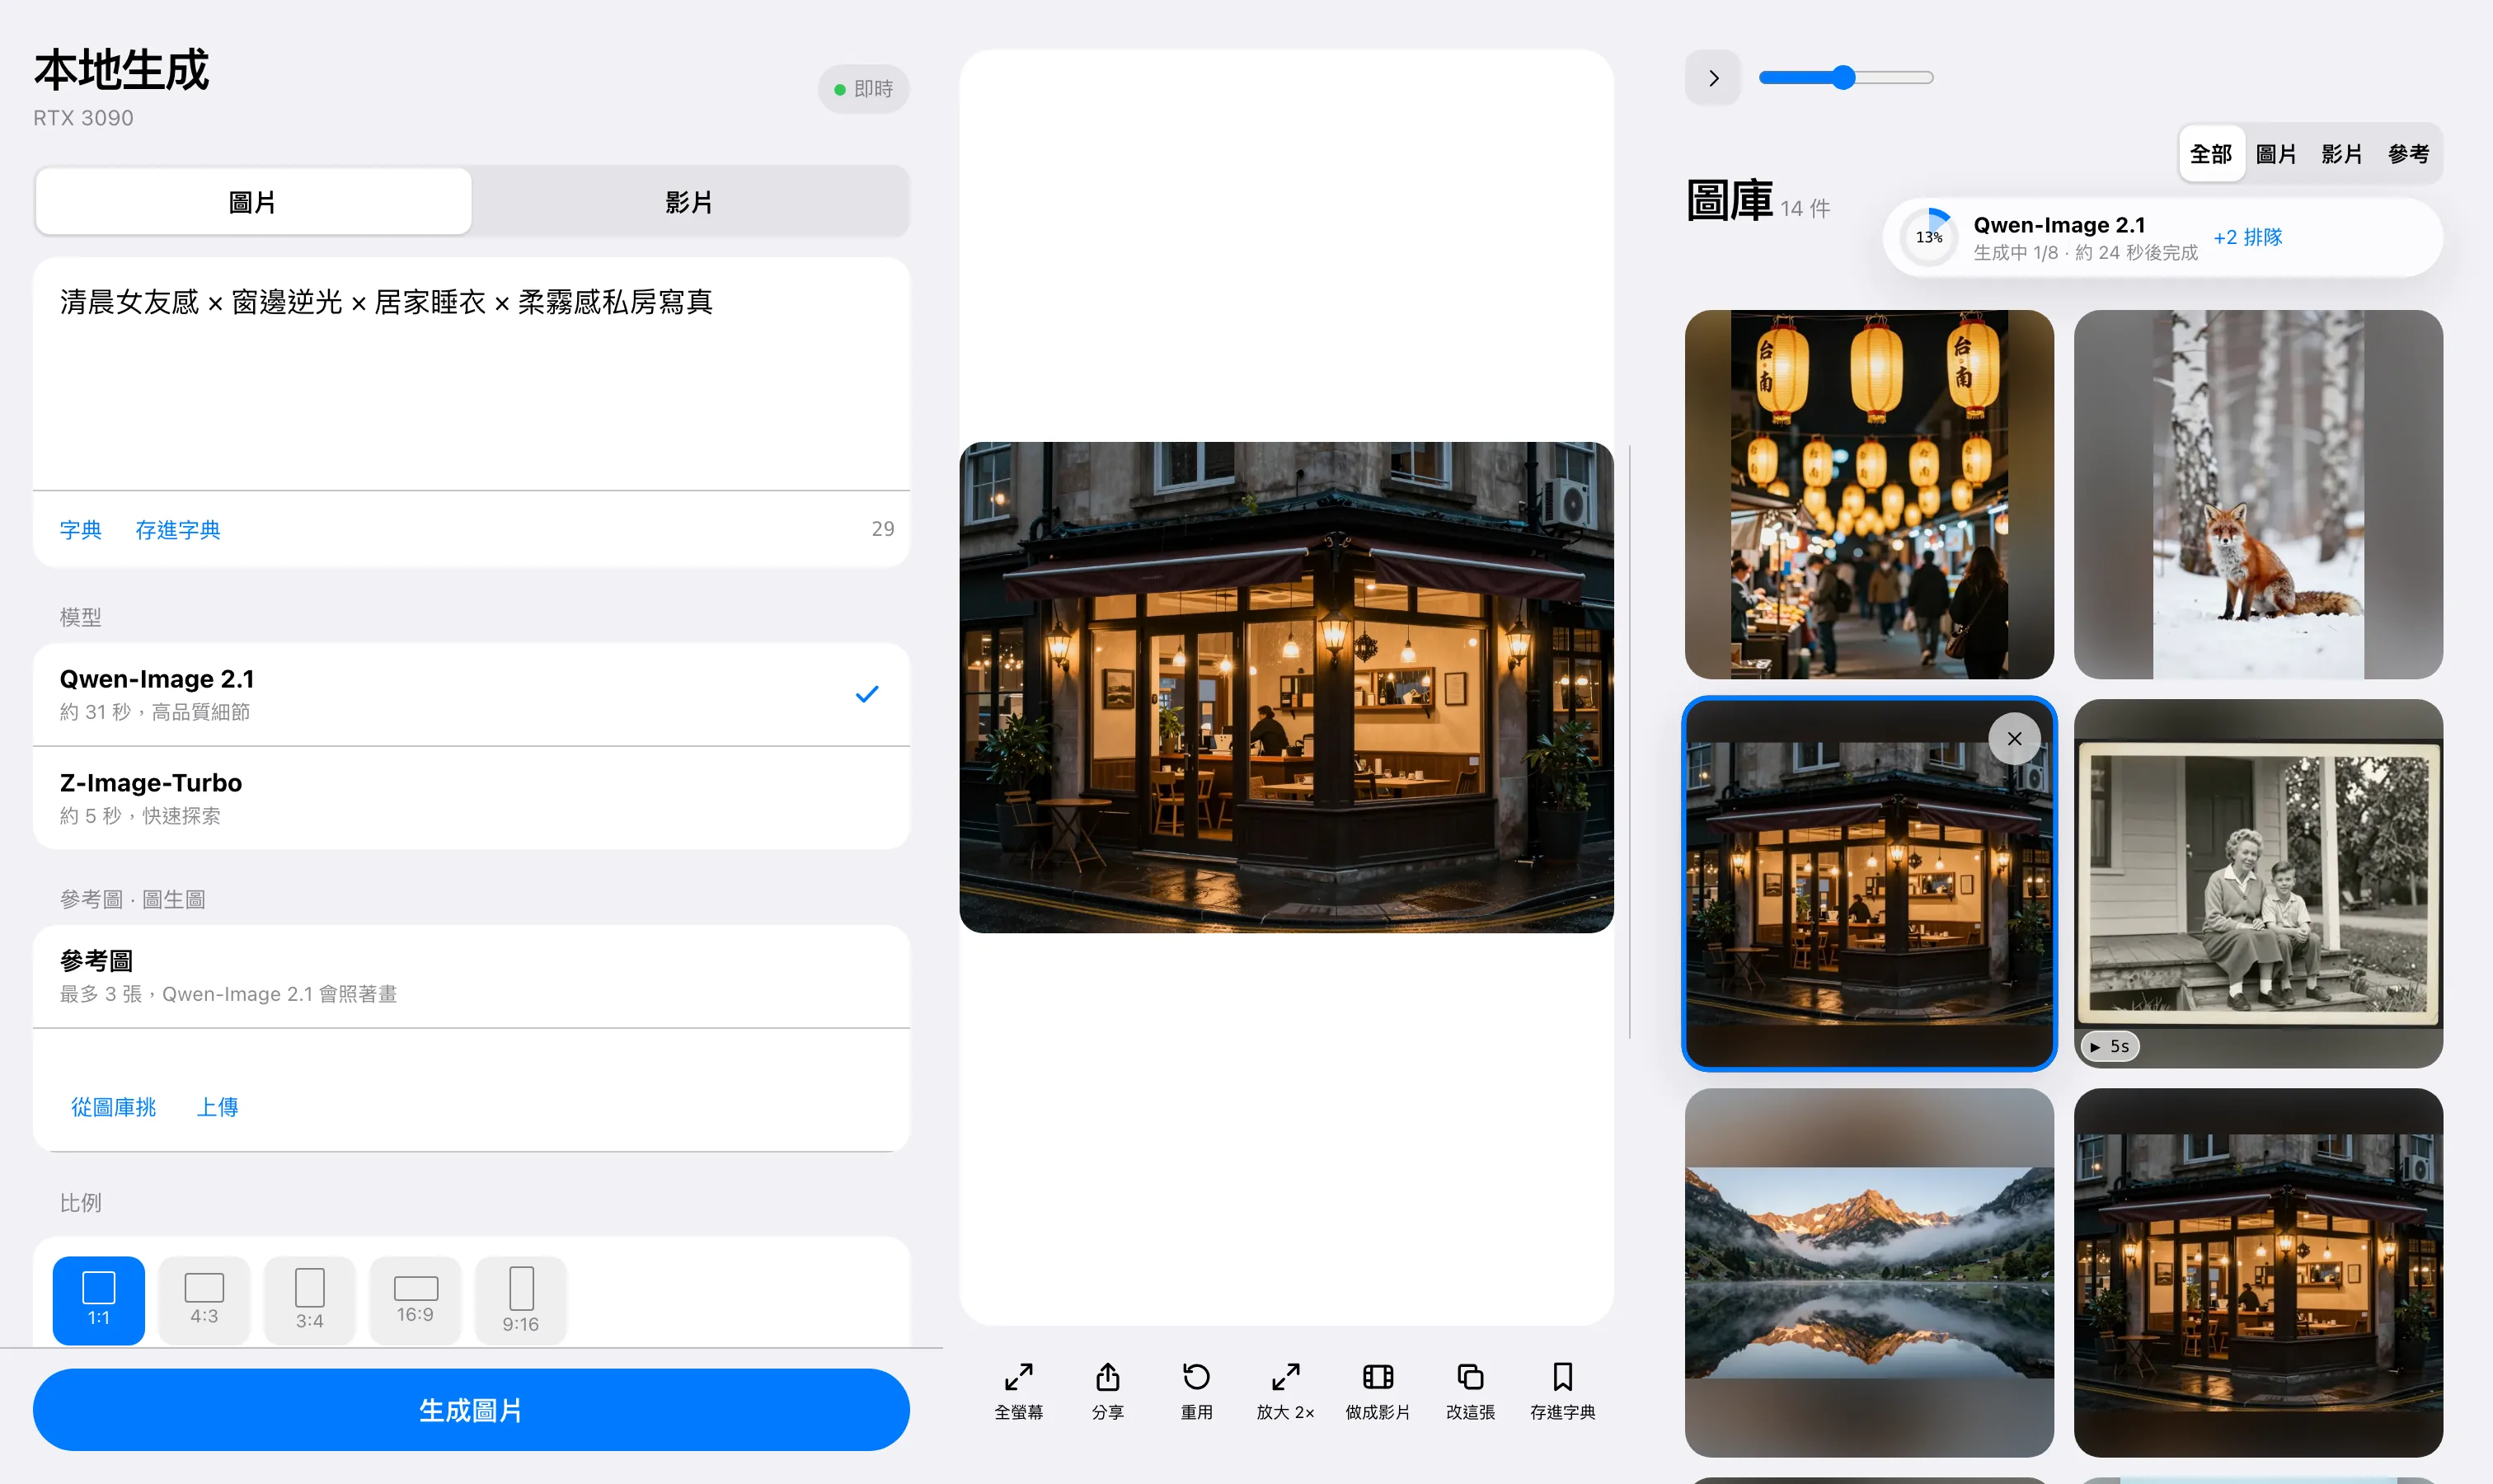
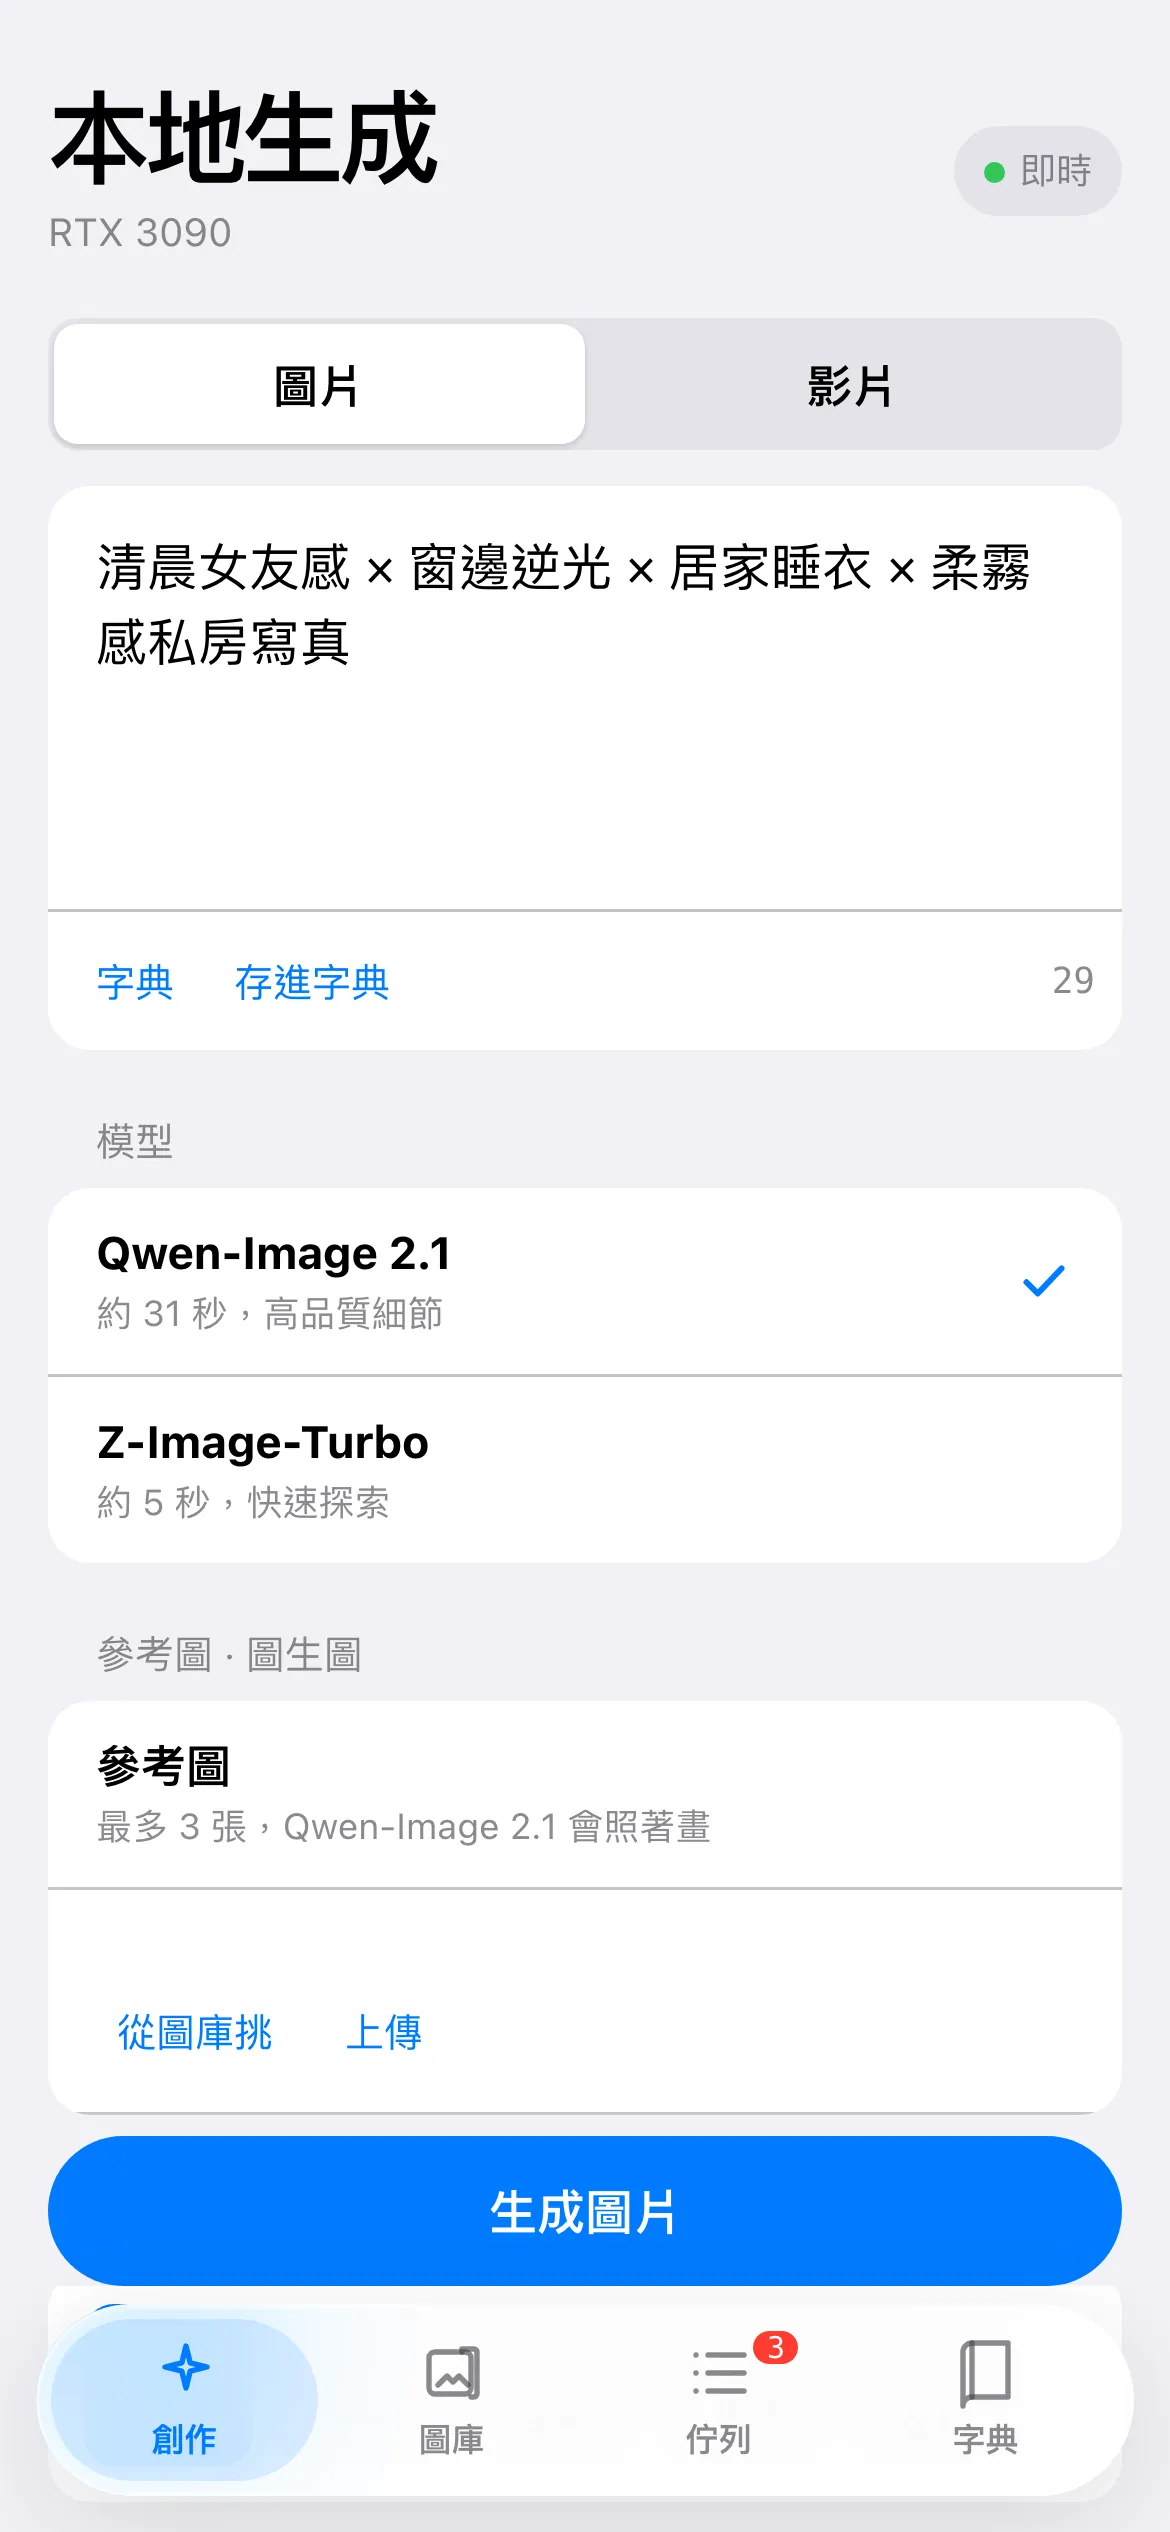
截圖裡輸入框的那一行,就是下面這張圖實際用的提示詞。這張是 Qwen-Image 2.1 畫的,我給它的提示詞只有一行:
清晨女友感 × 窗邊逆光 × 居家睡衣 × 柔霧感私房寫真
幾個中文片語,沒有品質詞,沒有負向提示詞,沒有 LoRA,參數全用預設。直接出 768×1344,不用再另外放大;40 步,45.7 秒。
Z-Image Turbo 走的是另一條路,同樣的寫法把睡衣換成蕾絲內衣,只跑 8 步,一張 4.2 秒,比 Qwen 快了十倍。左邊是 Qwen,右邊是 Z-Image:
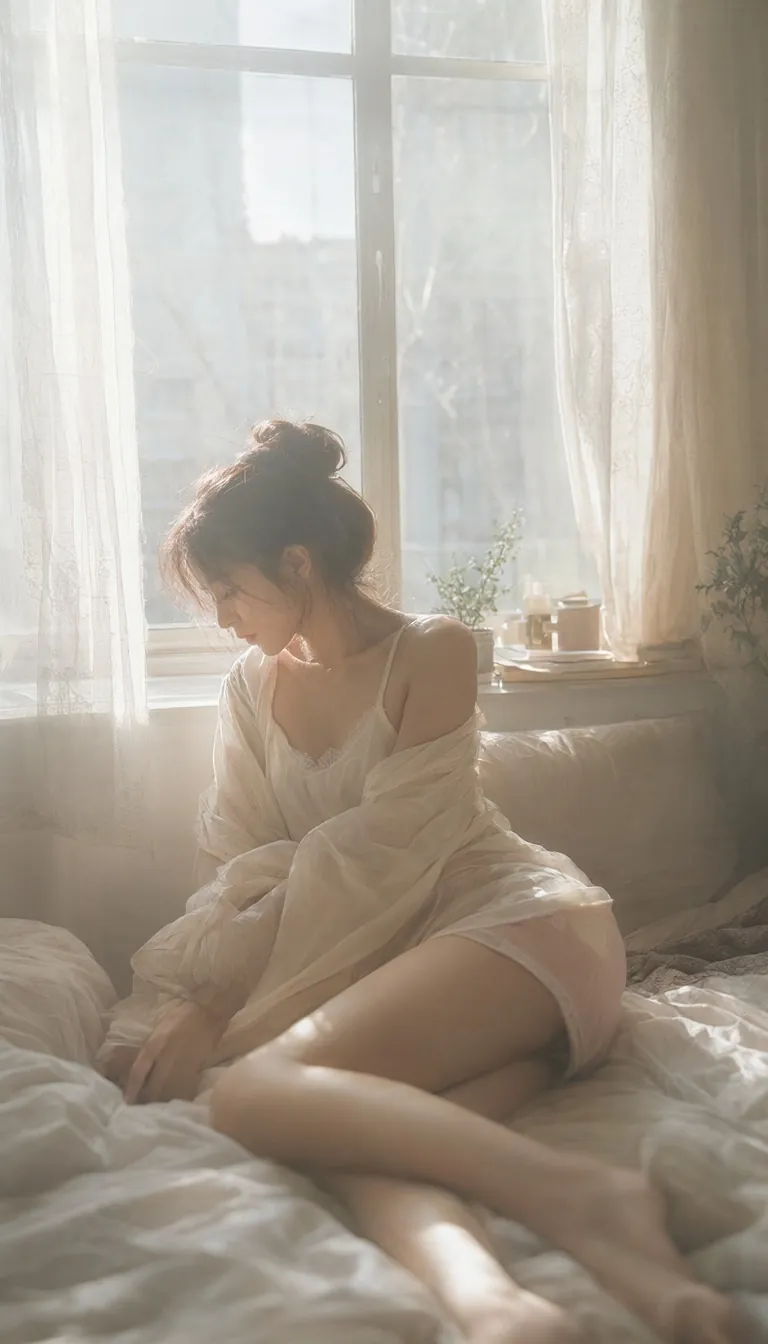
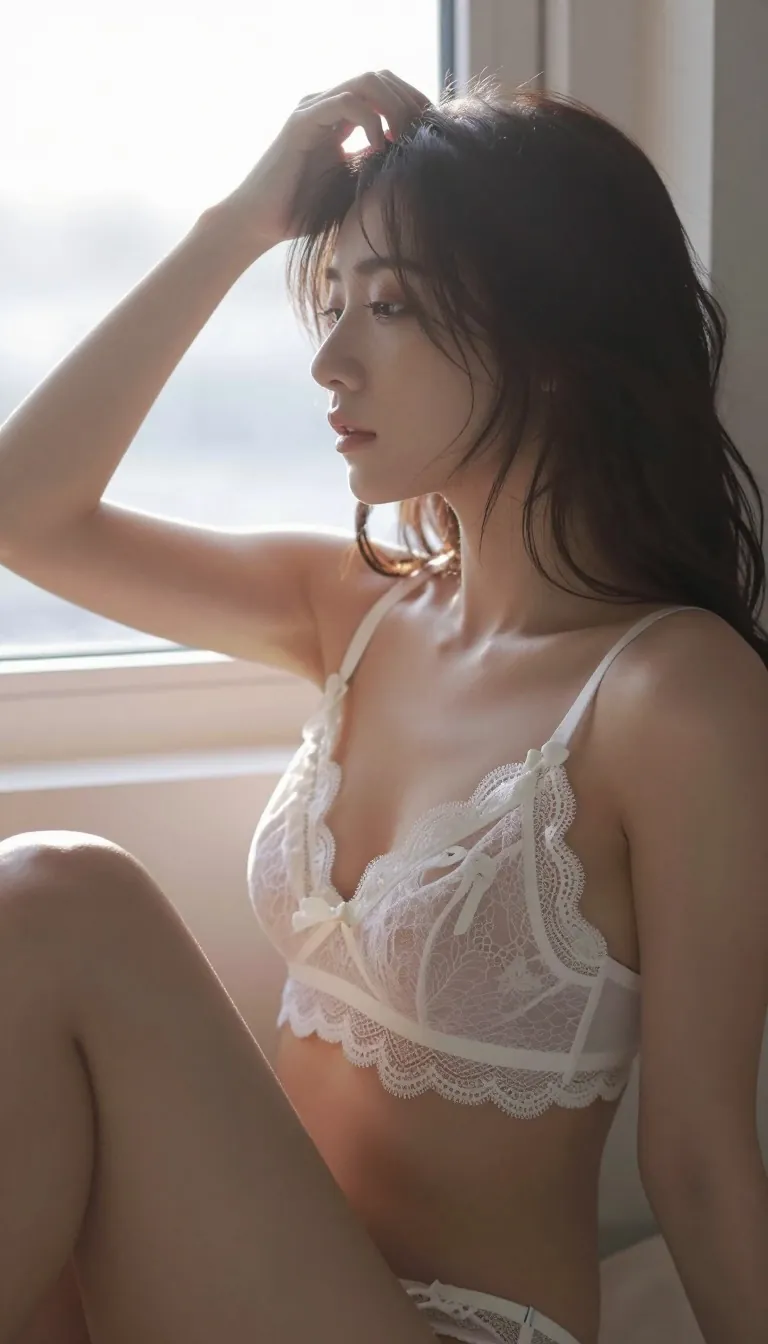
提示詞裡寫的東西都在畫面上:清晨的窗邊、逆光、柔霧的質感、居家睡衣。以前最怕的手指和身體比例,這兩張也沒有出問題。
三年下來,變的不只是速度和尺寸,是跟模型說話的方式:從一串英文關鍵字,變成一句中文。
圖也會動了
同一套寫法也能用在影片上:拿一張生好的圖當第一格,再用一句中文說它要怎麼動,同一張顯示卡就能生成 5 秒的影片;雲端的 Seedance 效果更驚人,也貴得多。這些,還有最近讓我再驚豔一次的——AI 從頭做完一整支影片,都寫在下一篇〈AI 做影片:畫面怎麼動、花多少〉。
把舊咒語翻成一句白話
三年下來變的是跟模型說話的方式:從一串英文關鍵字,變成一句中文。
手上還留著以前的提示詞,可以貼給你的 AI,讓它照這篇的對照幫你改寫。
延伸閱讀
| 資源 | 為什麼重要 |
|---|---|
| AI 做影片:畫面怎麼動、花多少 | 下一篇:同一套一句話的寫法用在影片上,還有 AI 把整支片做完的做法和代價。 |
| 逢甲大學 Stable Diffusion 實作教材 I | 2024 年上課用的教材,從提示詞、文生圖、圖生圖講起,看得到當年咒語怎麼寫。 |
| 教材 II | 同一門課的第二堂。 |
| 教材 III | 第三堂,一路做到 LoRA 訓練和 ControlNet。 |