AI로 만들어 본
요즘 가장 인기 있는 RAP 영상
AI로 스토리가 있는 MV를 만드는 일곱 단계입니다. 주제 선정부터 화질 향상까지 다루고, 겪은 문제는 마지막에 모았습니다.
과정과 사용한 모델
아래 두 편의 rap MV는 같은 과정으로 만들었습니다. 과정과 각 단계에서 사용한 모델은 다음과 같습니다.
| 단계 | 하는 일 | 모델 | 대안 제품(미실측) |
|---|---|---|---|
| 1 | 참고 영상의 리듬 측정 | Claude Code | Codex, Gemini CLI |
| 2 | 가사 쓰기 | Claude Code | ChatGPT |
| 2 | 노래 만들기 | Suno | Udio |
| 2、4 | 캐릭터, 기준 이미지, 관객과 DJ의 이미지 생성 | z-image | ChatGPT 이미지 생성, Nano Banana |
| 2 | 보컬 분리, 노래하지 않는 샷에는 반주만 입력 | Demucs | UVR |
| 2 | 가사 각 줄의 시간 맞추기 | Whisper | WhisperX |
| 3、5 | 참고 이미지와 소리에 맞춰 샷 생성 | MiniMax H3 | Wan 2.2, Seedance |
| 4 | 스토리보드 회의(다섯 역할) | Codex | Claude Code |
| 6 | 초벌 영상을 보고 검사 스크립트 작성 | Claude Code | Codex |
| 6 | 입이 얼마나 벌어지는지 측정 | MediaPipe | dlib |
| 6、7 | 검사 스크립트 검토 | Codex | Claude Code |
| 7 | 1080p로 업스케일링 | SeedVR2 | Topaz Video AI |
| 완성본 | 편집, 자막 넣기 | Claude Code(ffmpeg 스크립트 작성) | CapCut |
실험 기간은 2026-10-01~10-12이며, 생성 작업은 모두 RTX 3090 한 장에서 실행했습니다. 그림에 나온 이 모델 조합에서만 검증했으므로 모델을 바꾼다면 먼저 시험 생성(3단계)을 해야 합니다.


일곱 단계
1. 주제를 정하고 참고 영상 한 편 찾기
가사에 쓸 소재가 있으려면 주제에 이미 갈등이 있어야 합니다. 아테나와 포세이돈은 신화에서 실제로 아테네의 주도권을 두고 다퉜습니다. 참고 영상은 리듬을 측정하는 데 썼습니다. 〈누구의 도시〉은 삼국지 rap battle 영상 한 편을 기준으로 측정했습니다. 샷마다 2~3초이고 박자에 맞춰 컷을 바꾸며, 노래하지 않는 인물이 나오는 샷이 약 4분의 1입니다.
2. 캐릭터와 노래를 함께 만들며 서로 수정하기
가사에 캐릭터에게 없는 것이 나오면 캐릭터를 다시 생성합니다. 캐릭터가 예상보다 잘 나오면 곡의 스타일이나 가사를 다시 조정합니다. 노래가 나오면 실제로 무엇을 불렀는지 먼저 확인합니다. Suno가 곡의 구성을 바꾸기도 합니다.
캐릭터 작업 순서는 이렇습니다. 먼저 외형의 근거를 조사하고, 그다음 네 방향의 설정화를 그린 뒤, 마지막으로 모든 캐릭터가 함께 있는 기준 이미지 한 장을 생성합니다. 각 샷의 참고 이미지는 모두 그 기준 이미지에서 잘라 쓰면 인물이 달라지지 않습니다.
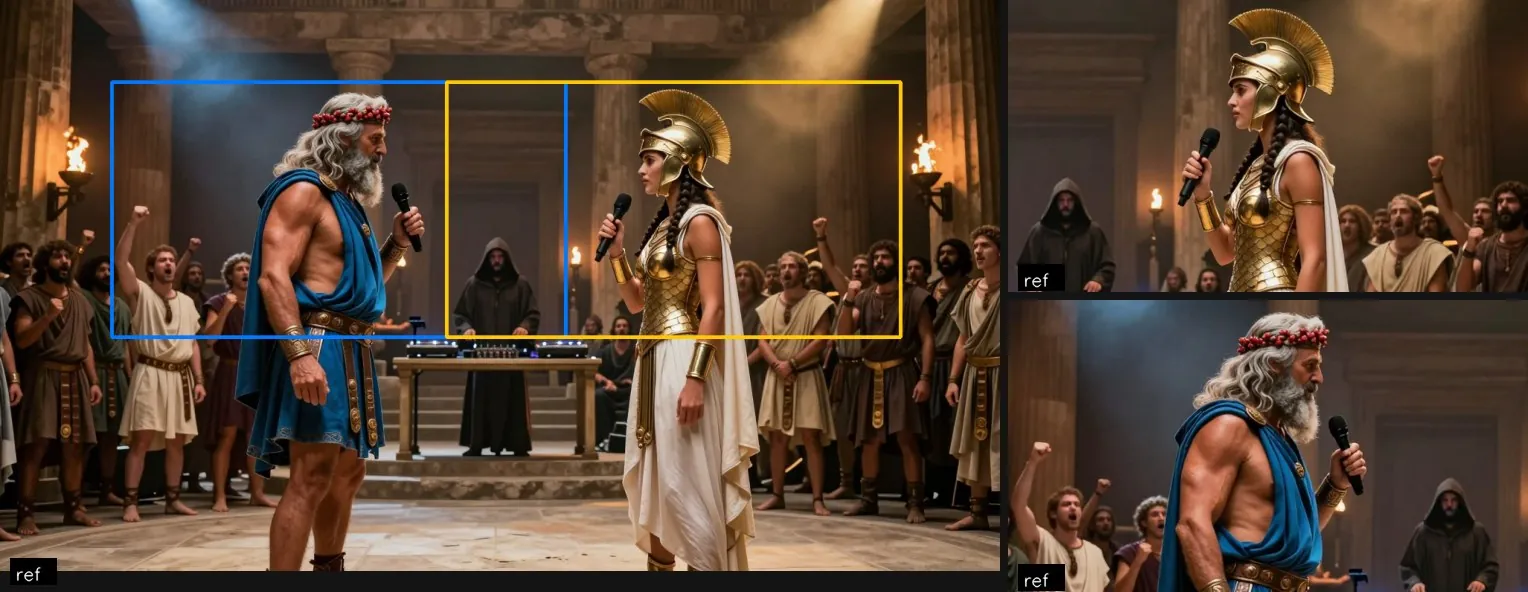
이 두 편은 모두 앞의 두 단계를 건너뛰었기 때문에, 〈누구의 도시〉에서 인물의 정면과 측면 샷은 모델이 스스로 채워 넣어야 했습니다.
3. 화질은 신경 쓰지 말고 먼저 시험 생성하기
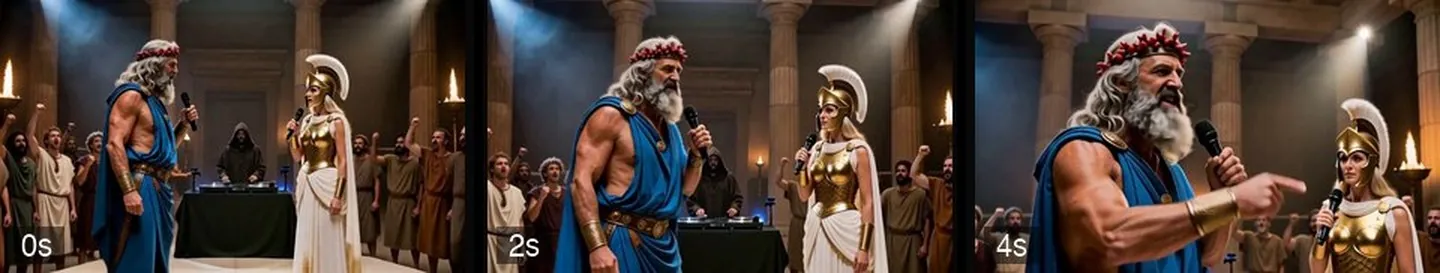
한 번에 한 가지만 바꿔 보면서 어떤 표현에서 오류가 나는지, 모델이 무엇을 못 하는지 확인합니다. H3로 시험해서 알아낸 점은 다음과 같습니다.
- 모델은 참고 이미지의 영향을 가장 많이 받고, 그다음은 소리, 마지막이 텍스트입니다
- 각 샷의 처음 몇 초 동안은 참고 이미지에서 영상으로 변해 갑니다
- 입 모양은 노래와 맞지 않고 카메라 각도도 지정할 수 없습니다
- 한 번에 3, 5, 10, 15초 중 하나로만 생성할 수 있습니다
〈누구의 도시〉은 본격적으로 만들기 전에 11샷을 시험 생성해, 전체 53샷에 퍼질 수 있는 오류 두 가지를 잡았습니다.
4. 샷마다 이미지 한 장씩 스토리보드 그리기
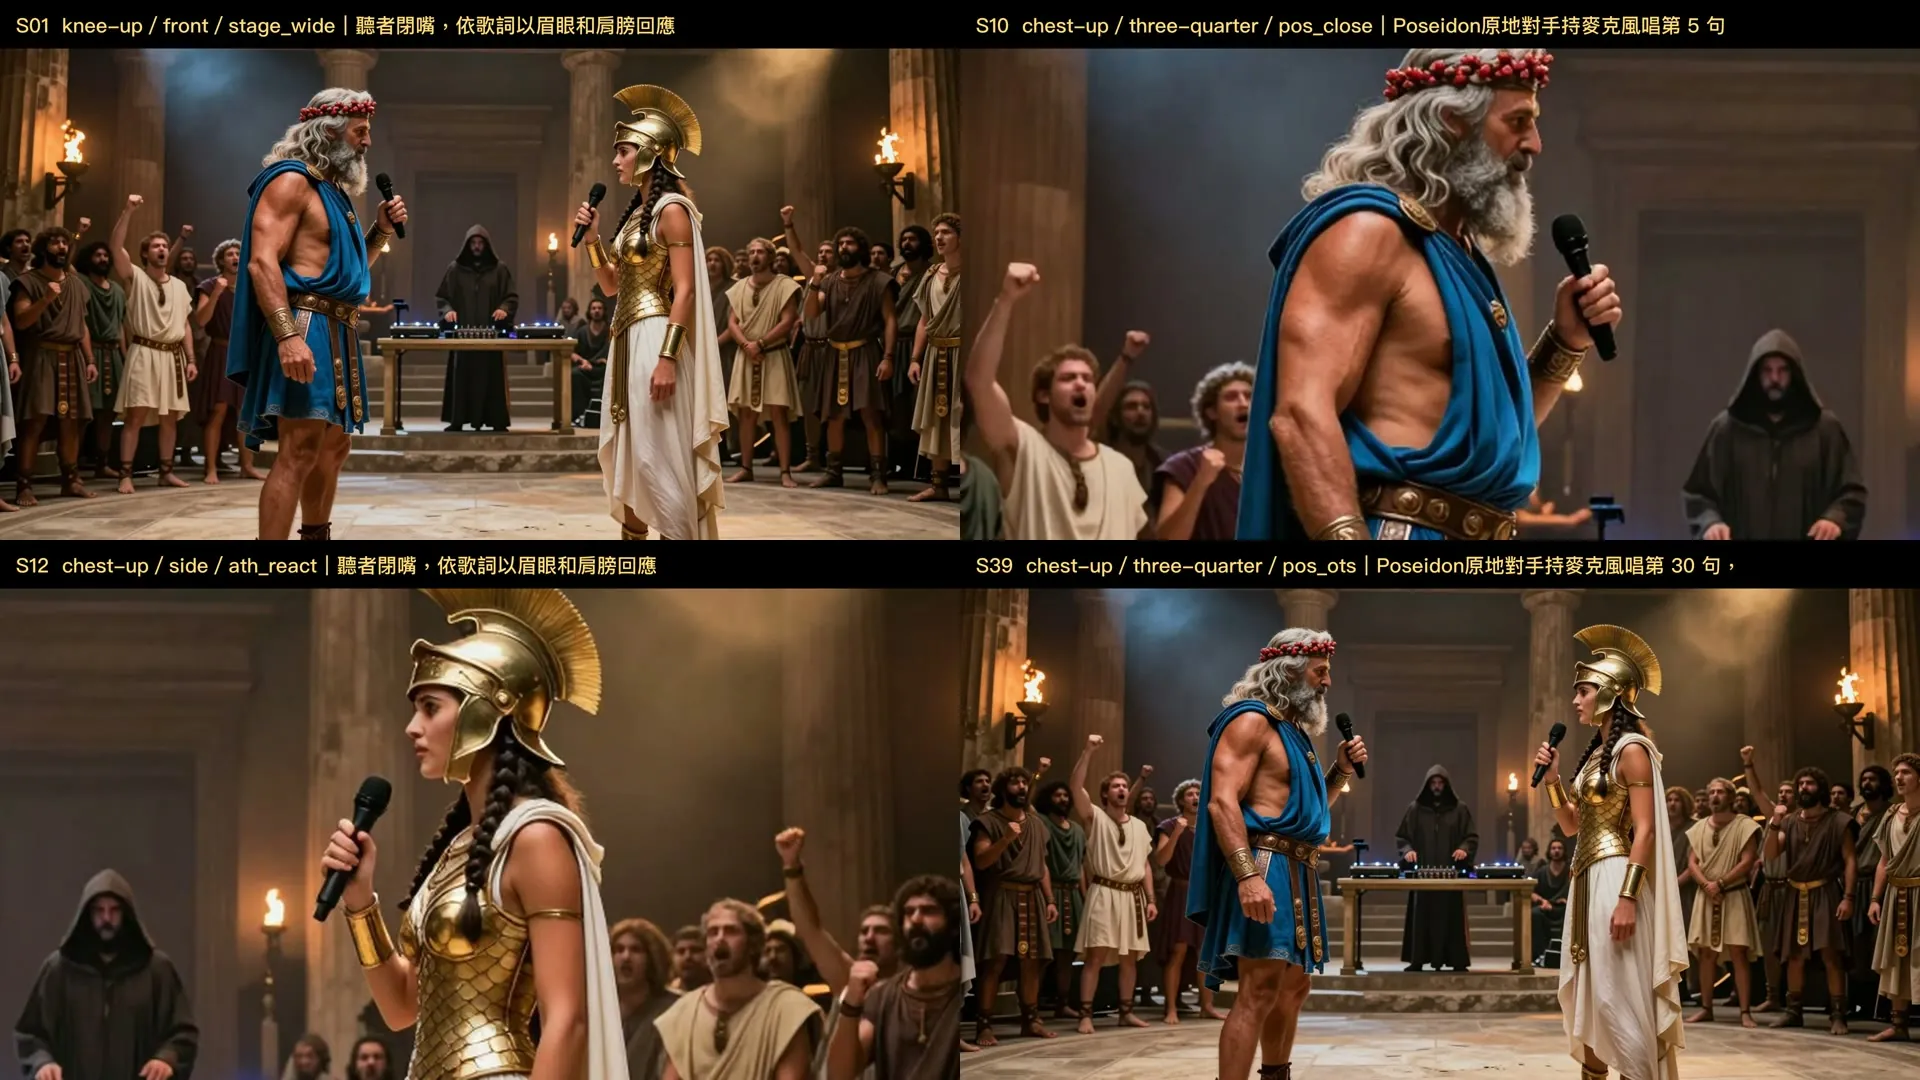
각 샷에 화면 크기, 카메라 움직임, 전달할 내용, 노래하는 사람을 적고 이미지 한 장을 붙입니다. 노래에 맞춰 애니매틱으로 배열해 먼저 리듬을 봅니다. 3단계에서 확인한 제약에 맞춰 다음처럼 작성합니다.
- 참고 이미지를 먼저 해당 샷의 구도에 맞게 자릅니다
- 입이 선명하게 보이는 샷은 각각 2초를 넘기지 않습니다
- 서로 이웃한 두 샷은 구도가 크게 달라야 합니다
- 반복해서 등장할 물건은 색깔까지 표 한 장에 적습니다
5. 스토리보드에 따라 샷별로 생성하기
각 샷을 2.5초 더 길게 생성해 앞부분을 잘라낼 여유를 둡니다. 샷마다 별도의 시드를 줍니다. 시드는 화면이 어떻게 생길지를 결정하는 숫자입니다. 몸을 돌리는 것처럼 이어지는 동작은 이전 샷의 마지막 프레임에서 계속 생성합니다.
프롬프트는 아래 세 가지 원칙에 따라 씁니다. 모델은 참고 이미지를 가장 중시하고, 그다음은 소리, 마지막이 텍스트이므로(3단계) 세 가지가 같은 내용을 가리켜야 합니다.
첫째, 원하는 것을 분명히 씁니다. ‘입을 다문다’라고만 쓰면 입이 그대로 벌어졌다 닫힙니다. rap을 하지 않고 마이크를 허리 옆에 둔 채 입술을 꾹 다물고 서로 노려본다고 쓰니 그제야 입이 닫혔습니다. 구도도 마찬가지입니다. 전신 사진을 주고 ‘가슴 위쪽’을 묘사하면 모델은 전신에서 시작해 점점 다가갑니다. 참고 이미지를 먼저 상반신으로 잘라 생성했더니 더 다가가지 않았습니다(그때는 묘사와 시드도 함께 바꿨습니다).
둘째, 불필요한 것은 쓰지 않습니다. 프롬프트에서 언급한 것은 모델이 모두 그릴 수 있습니다.
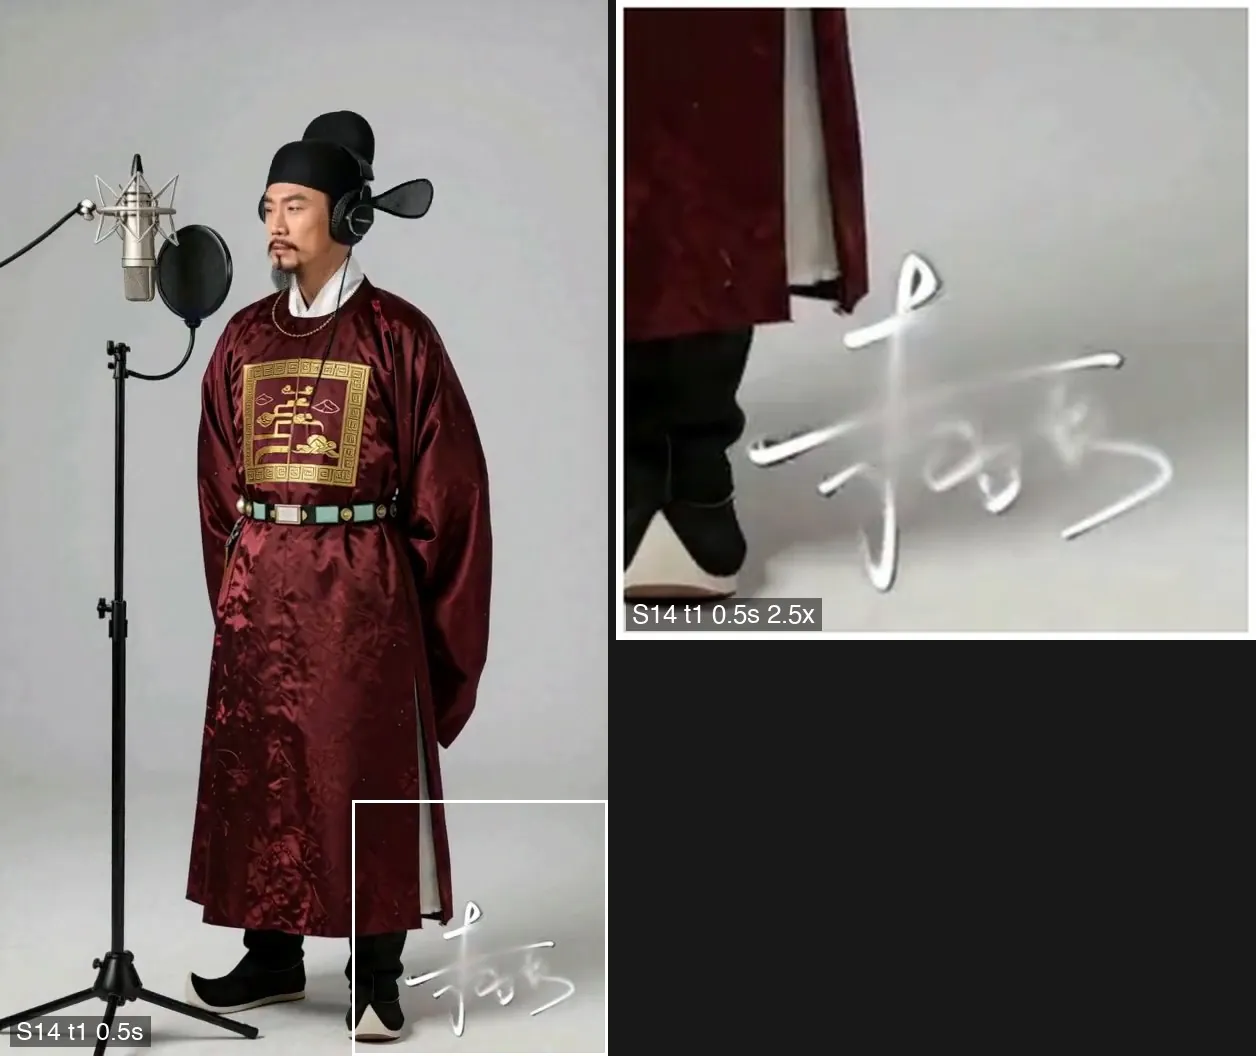
- ‘오른쪽 아래에 자리를 비워 두고 후반 작업에서 서명을 넣는다’고 썼더니 오른쪽 아래에 가짜 붓글씨가 한 줄 더 생겼습니다
- 한 사람만 나오는 샷의 묘사에 다른 사람의 옷차림을 쓰면, 그가 화면 밖에 있다고 명시해도 화면 안에 들어왔습니다
- 모든 샷에 공통으로 넣은 문장에 무대 전체의 위치 배치를 쓰자 클로즈업도 처음에는 전경으로 나왔습니다(3단계의 이미지)
- 표정 묘사에 턱에 힘을 준다고 쓰면 입이 움직이기 쉽습니다
후반 작업에서 넣을 글자는 묘사에 쓰지 말고, 그 자리를 깨끗한 벽으로 묘사합니다. 공통 문장에는 조명과 의상만 쓰고, 한 사람만 나오는 샷에는 그 사람만 씁니다.
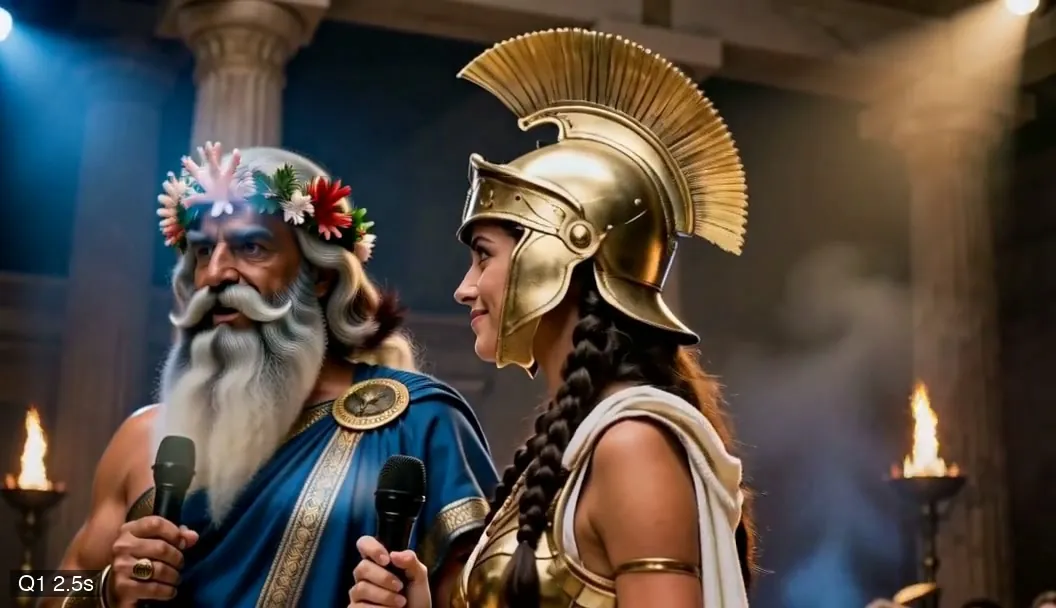
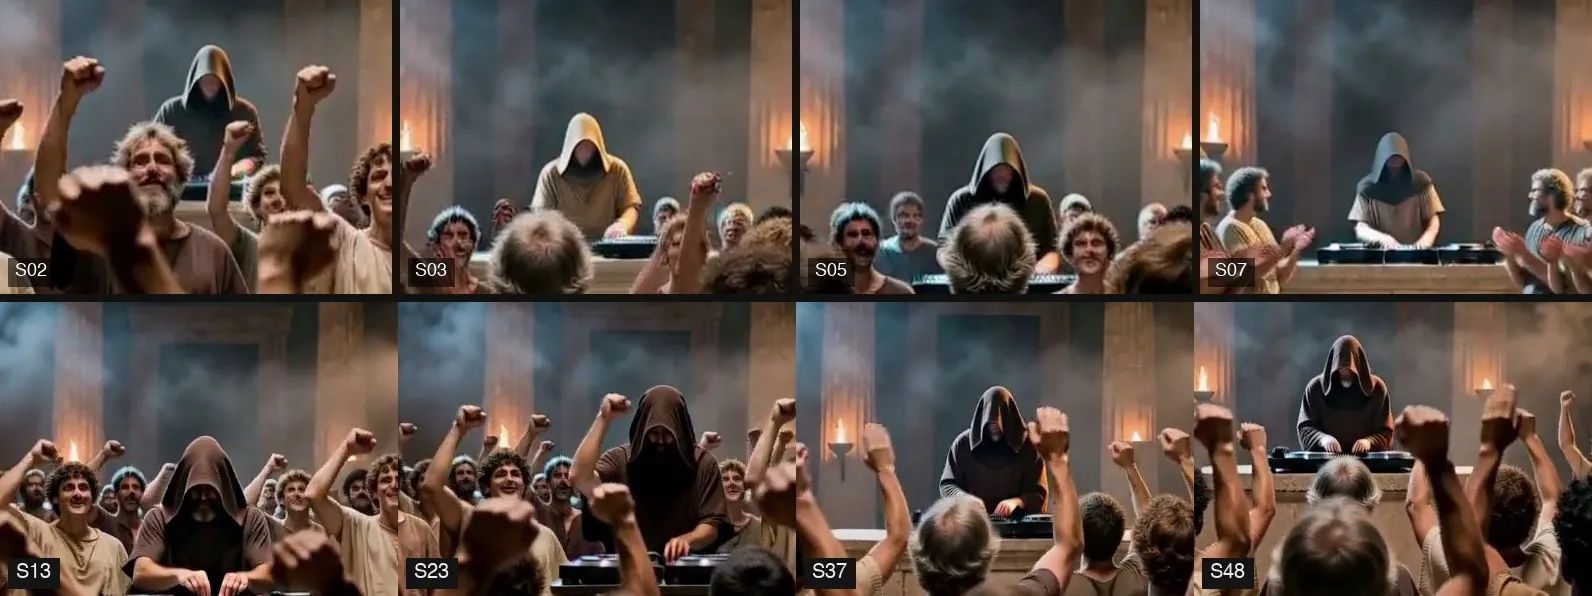
셋째, 고정해야 할 것은 명확히 씁니다. ‘후드를 썼다’라고만 쓰면 샷마다 후드 색이 달랐습니다. ‘진한 갈색 후드를 쓰고 얼굴은 그늘에 가려져 있다’로 바꾸자 이후에 생성한 샷은 모두 진한 갈색이었습니다. 수정 전에 이미 생성한 몇 샷은 DJ가 화면에서 아주 작게 나와 다시 생성하지 않았습니다.
6. 샷마다 점검하고 발견한 문제를 자동 검사로 만들기
영상을 보기 전에 먼저 점검 목록을 만듭니다. 장면의 연속성, 좌우 방향, 물체의 관통이나 떠 있음, 시간의 흐름, 입을 확인합니다. 통과하지 못하면 다시 생성합니다. 같은 문제가 두 번째 나타나면 자동 검사로 만들고, 먼저 실제 오류가 있는 샘플에 시험합니다.
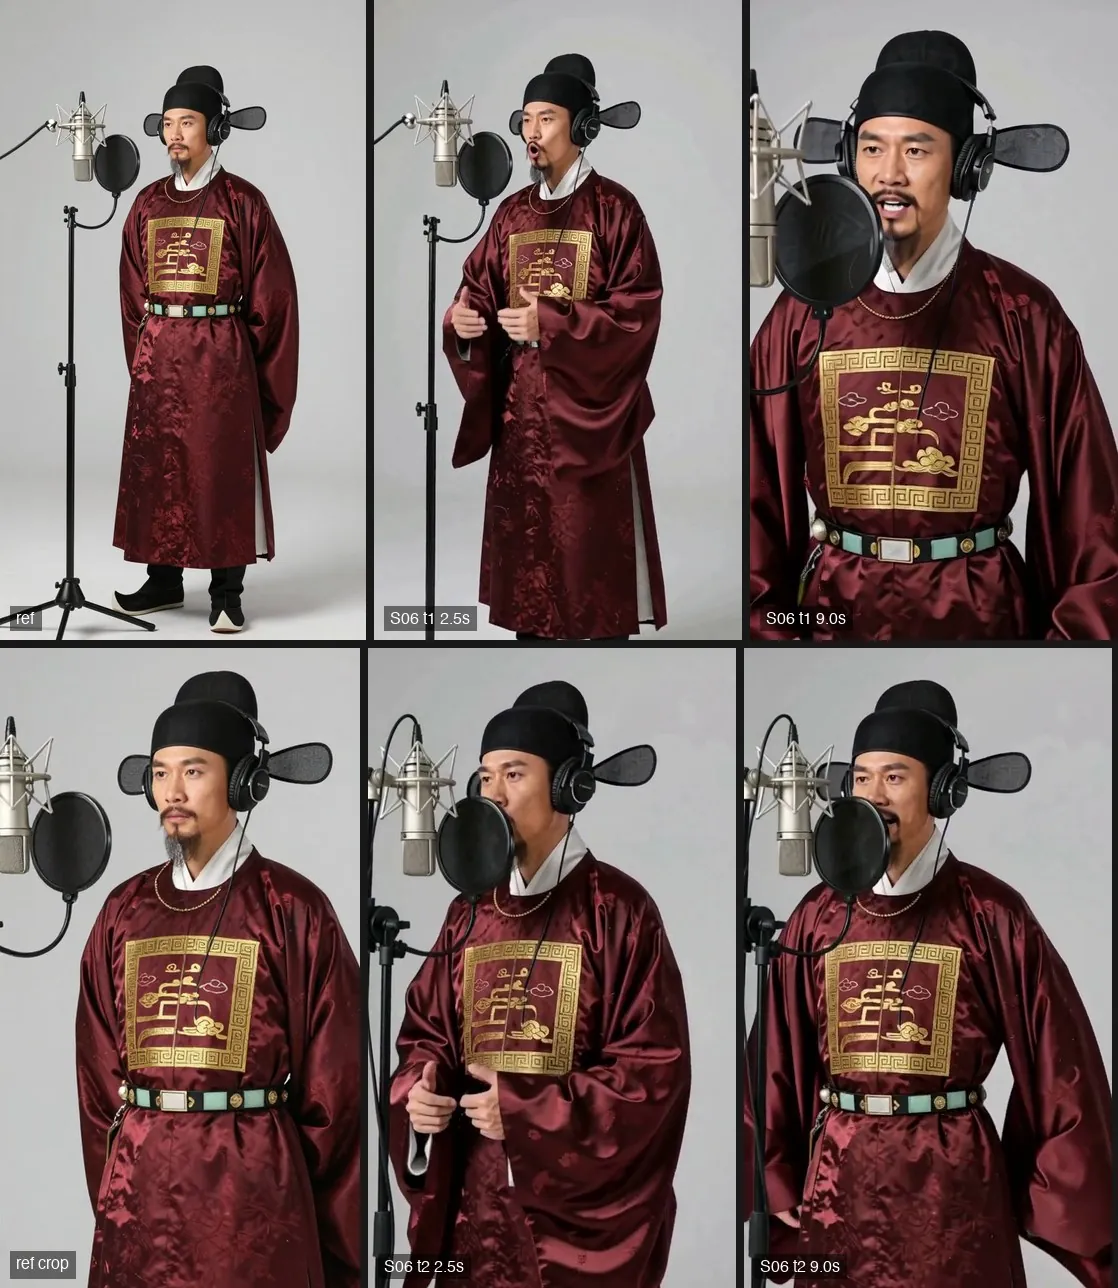
문제는 화면에서 무엇이 보이는지, 몇 초에 나타나는지 기록해야 합니다. 〈국성야의 퇴장〉의 결말을 ‘보컬이 멈췄는데도 계속 말한다’로 적었더니 오디오 트랙만 고쳐지고 문제는 남았습니다. ‘화면 속 인물의 입이 여전히 움직인다’로 바꾸어 적고서야 고칠 수 있었습니다.
이 항목을 나중에 〈누구의 도시〉의 점검 목록에 넣었고, 영상을 볼 때 같은 문제를 잡아냈습니다.
7. 영상을 확정한 다음 화질 높이기
H3가 생성한 화면은 1056×608에 불과합니다. 업스케일링을 한 번 하는 데 시간이 오래 걸리므로 모든 샷을 확정한 뒤에 처리합니다. 이후 다시 생성한 샷은 다시 업스케일링해야 합니다.
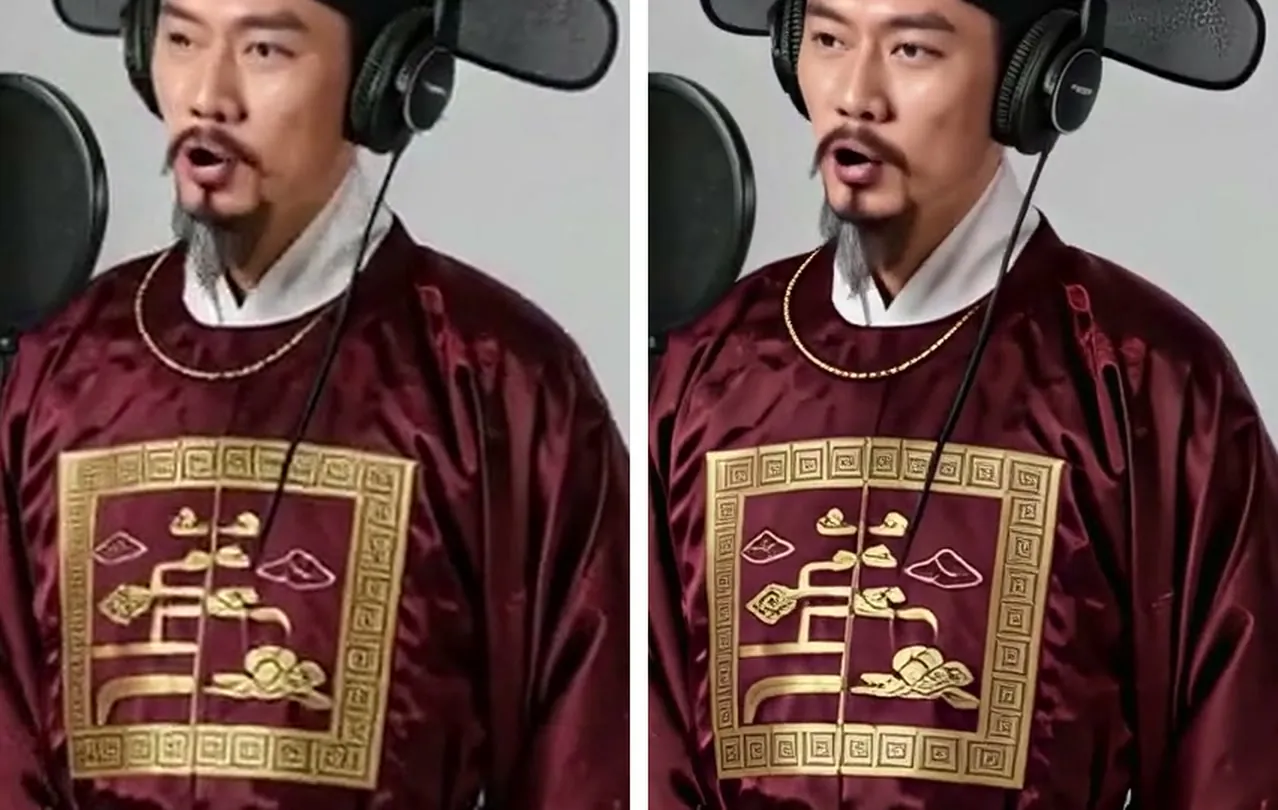
업스케일링에서도 오류가 납니다. 카메라가 다가가는 샷은 그래픽 카드 메모리가 부족해 짧은 구간으로 나눠 다시 처리해야 했습니다. ‘이미 업스케일링한 샷 건너뛰기’ 기능은 영상 길이만 비교해서, 다시 생성한 샷을 업스케일링하지 않았습니다. 처리 후에는 프레임 수, 컷 지점, 멈춘 프레임을 다시 확인합니다. 4K는 1080p보다 약 10배의 시간이 걸려 이 두 편은 1080p까지만 만들었습니다.
자주 묻는 질문
각 샷의 시작 부분은 왜 정지 화면처럼 보이나요?
참고 이미지 모드의 첫 프레임은 거의 참고 이미지 그 자체입니다. 영상을 조금 더 길게 생성해 시작 부분을 잘라냅니다.
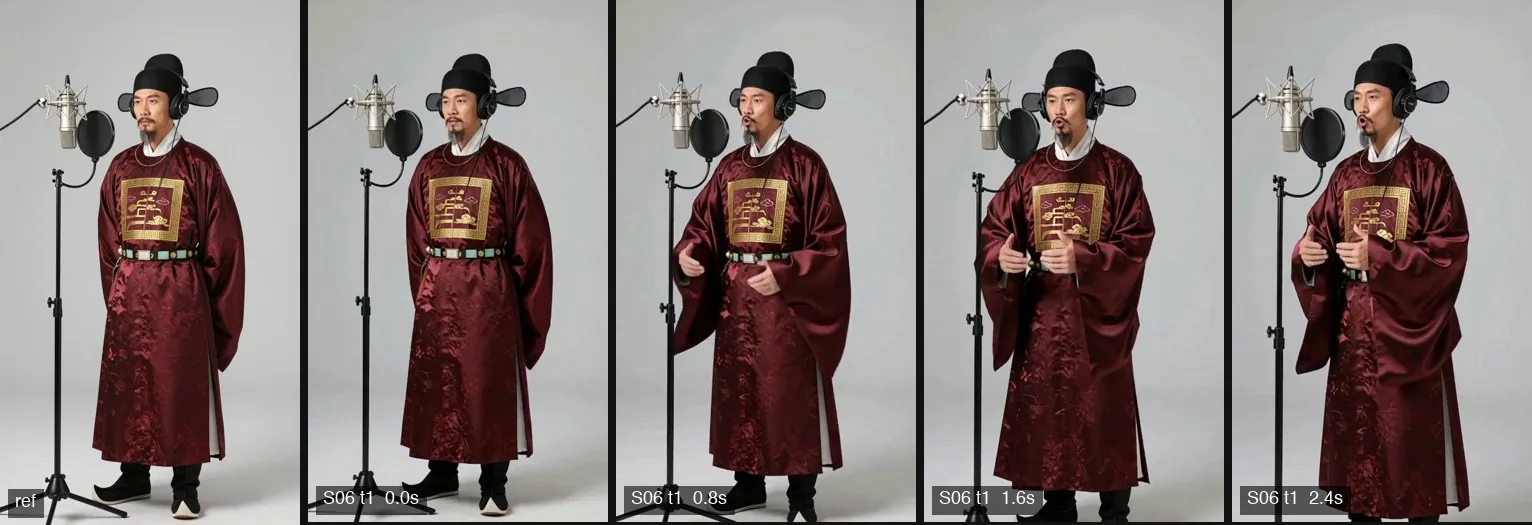
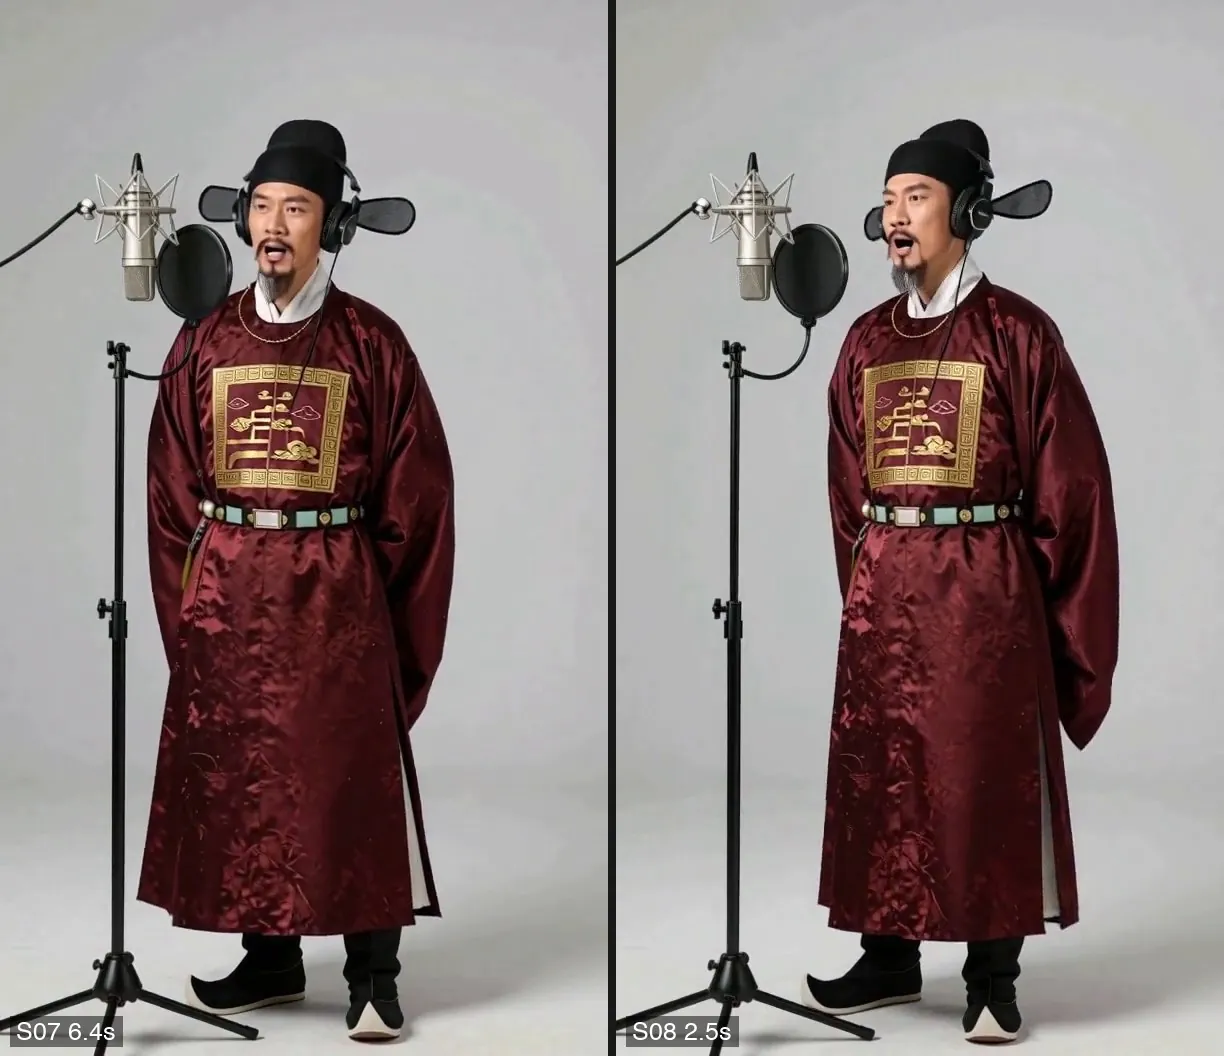
두 샷이 같은 장면을 반복 재생한 것처럼 보이나요?
묘사도 같고 시드도 같으면 거의 같은 화면이 생성됩니다. 샷마다 별도의 시드를 줍니다.
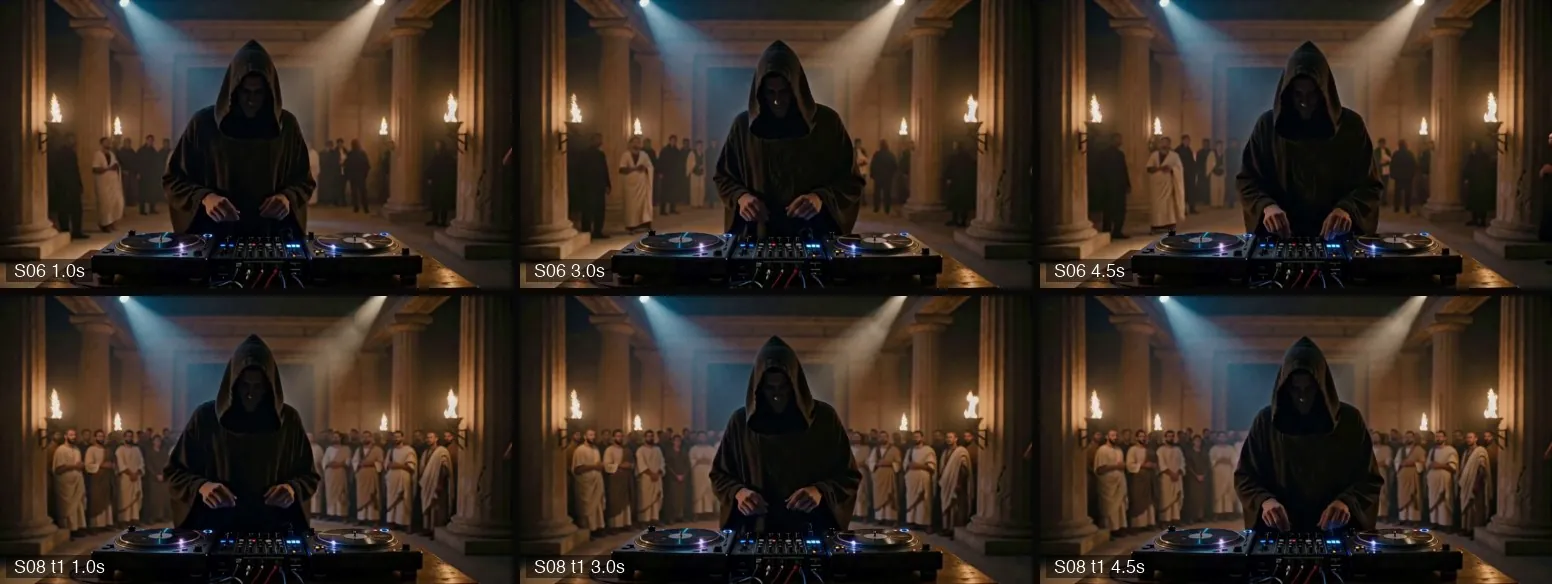
여러 번 다시 생성해도 계속 틀리나요?
같은 문제가 두 번 다시 생성해도 남아 있다면 시드만 계속 바꾸지 말고 샷 설계를 바꾸거나 다른 샷의 영상을 사용합니다. 한 샷은 표현과 시드를 바꾸고 소리도 제거했지만 네 번 연속 생성해도 계속 말을 했습니다. 결국 쓰지 않은 다른 샷의 영상으로 교체했습니다.
두 샷을 이어 붙였을 때 화면이 순간적으로 흔들린 것처럼 보이나요?
이것을 점프 컷이라고 합니다. 두 샷의 구도가 거의 같고 사람은 몇 픽셀만 움직였습니다. 스토리보드에는 낮은 앵글이라고 썼는데 결과가 눈높이 앵글이면 앞 샷과 구도가 겹치기 쉽습니다. 앞 샷에 후반 작업으로 천천히 다가가는 효과를 주자 컷 지점에서 구도가 달라졌습니다.
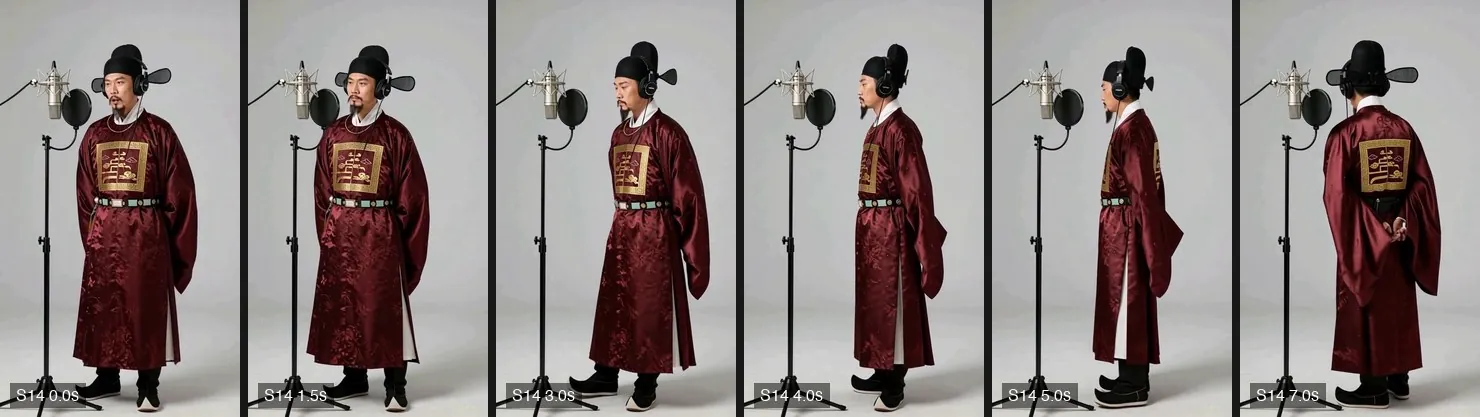
몸을 돌리는 장면이 어색하고 갑자기 뒷모습으로 바뀐 것처럼 보이나요?
모델이 생성한 회전 장면에서는 머리만 돌고 몸은 돌아가지 않았습니다. 편집에서 그 구간까지 건너뛰어 정면에서 뒷모습으로 갑자기 전환됐습니다. 이전 샷의 마지막 프레임부터 이어서 생성하자 몸과 발이 함께 돌아갔습니다.
샷마다 너무 길어서 리듬이 느린가요?
〈누구의 도시〉의 첫 스토리보드는 영상 길이를 기준으로 예산을 정해 긴 샷이 많았습니다. 대부분 한 샷이 6~7초였지만 참고 영상은 2~3초였습니다. 예산 기준을 그래픽 카드 사용 시간으로 바꾸고 참고 영상과 리듬을 비교했습니다.
자동 검사가 올바른 자막 카드를 오류로 판단하나요?
고정된 임곗값은 평평한 회색 벽에는 충분했지만, 배경이 연기와 불빛으로 바뀌자 오탐이 났습니다. 같은 프레임에서 자막 카드가 없는 이미지와 비교하도록 바꿨습니다.
입 모양을 노래에 맞출 수 있나요?
2026년 10월까지는 불가능했습니다. 두 번 측정해 보니 입이 얼마나 벌어지는지와 보컬 음량 사이의 관계가 일부러 시간을 어긋나게 한 대조군과 구별되지 않았습니다. 4단계처럼 샷 설계로 피할 수밖에 없습니다.
여러분의 AI Agent에 복사하세요
아래 내용을 여러분의 AI에 붙여 넣고, 가지고 있는 노래, 캐릭터 이미지, 스토리보드, 영상 클립과 대조하게 하세요.
더 읽을거리
| 자료 | 중요한 이유 |
|---|---|
| 〈AI로 영상 만들기: 화면은 어떻게 움직이고 비용은 얼마나 드는가〉 | AI 영상 제작 방식 여섯 가지와 비용을 다룬 글입니다. 이 글은 거기서 다루지 않은 여러 샷의 제어 방법을 이어 설명합니다. |
| 〈曹操 VS 刘备 Freestyle 说唱 Battle〉(Boundary into culture, @jieruwenhua) | 〈누구의 도시〉은 이 영상의 구성과 샷 유형을 기준으로 측정했지만 화면과 가사는 사용하지 않았습니다. |