用 AI 試做
當下最流行的 RAP 影片
用 AI 做一支劇情 MV 的七個步驟,從選題到提升畫質;踩過的問題集中在最後。
流程和用到的模型
下面兩支 rap MV 照同一套流程做,流程和每一步用到的模型如下。
| 步驟 | 做什麼 | 模型 | 競品(未實測) |
|---|---|---|---|
| 1 | 量參考片的節奏 | Claude Code | Codex、Gemini CLI |
| 2 | 寫詞 | Claude Code | ChatGPT |
| 2 | 做歌 | Suno | Udio |
| 2、4 | 生角色、母圖、觀眾和 DJ 的圖 | z-image | ChatGPT 生圖、Nano Banana |
| 2 | 分離人聲,不唱的鏡頭改餵伴奏 | Demucs | UVR |
| 2 | 對出每句歌詞的時間 | Whisper | WhisperX |
| 3、5 | 照參考圖和聲音生成鏡頭 | MiniMax H3 | Wan 2.2、Seedance |
| 4 | 分鏡會議(五個角色) | Codex | Claude Code |
| 6 | 看毛片、寫檢查腳本 | Claude Code | Codex |
| 6 | 量嘴張多大 | MediaPipe | dlib |
| 6、7 | 審查腳本 | Codex | Claude Code |
| 7 | 放大到 1080p | SeedVR2 | Topaz Video AI |
| 成片 | 剪接、上字幕 | Claude Code(寫 ffmpeg 腳本) | CapCut |
實驗期間 2026-10-01~10-12,生成都在一張 RTX 3090 上跑。只在圖中這套模型上驗過,換模型先試生成(第 3 步)。


七個步驟
1. 選題,找一支參考片
題目要有現成的衝突,歌詞才有梗:雅典娜和波賽頓在神話裡真的搶過雅典城。參考片拿來量節奏。〈誰的城〉照一支三國 rap battle 量,每顆鏡頭 2~3 秒、切在拍子上,約四分之一是不唱的人。
2. 角色和歌一起做,互相修
歌詞提到角色身上沒有的東西,就重生角色;角色比預期好,就回頭調曲風或歌詞。歌回來先量實際唱了什麼,Suno 會改段落。
角色的順序是:先查外觀依據,再畫四視圖設定稿,最後生一張所有角色同框的母圖。每一鏡的參考圖都從母圖裁,人就不會變。
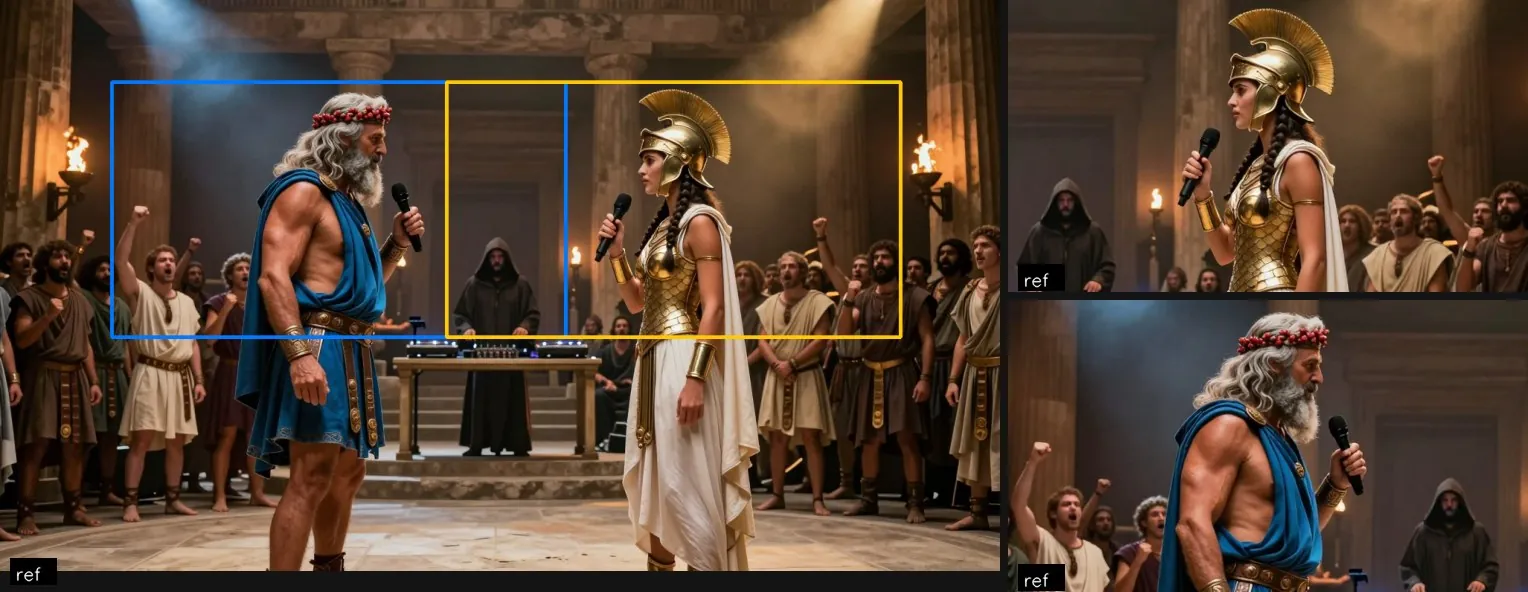
這兩支都跳過了前兩步,〈誰的城〉的正側面鏡頭只能靠模型自己補。
3. 先試生成,不管畫質
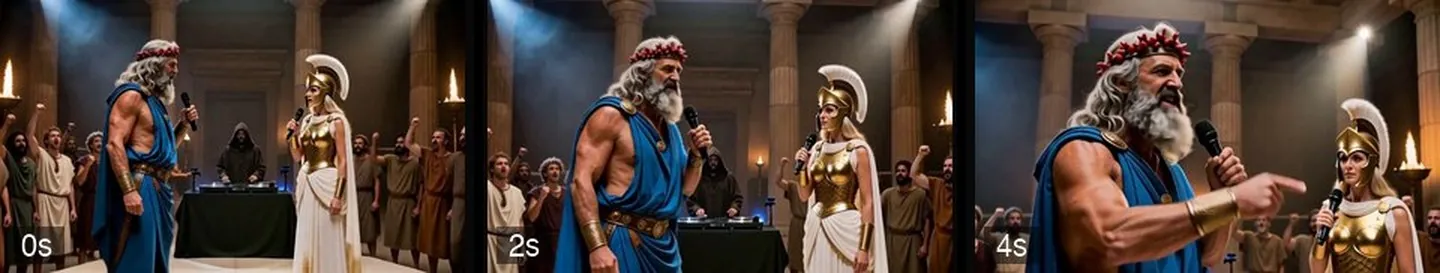
一次只換一樣東西,看哪些寫法會出錯、模型做不到什麼。H3 上試出來的:
- 模型最聽參考圖,其次是聲音,文字排最後
- 每鏡開頭幾秒是從參考圖變過來的
- 嘴型對不上歌,鏡頭角度也指定不了
- 一顆只能生 3、5、10 或 15 秒
〈誰的城〉開拍前試了 11 顆,抓到兩個會複製到全部 53 鏡的錯。
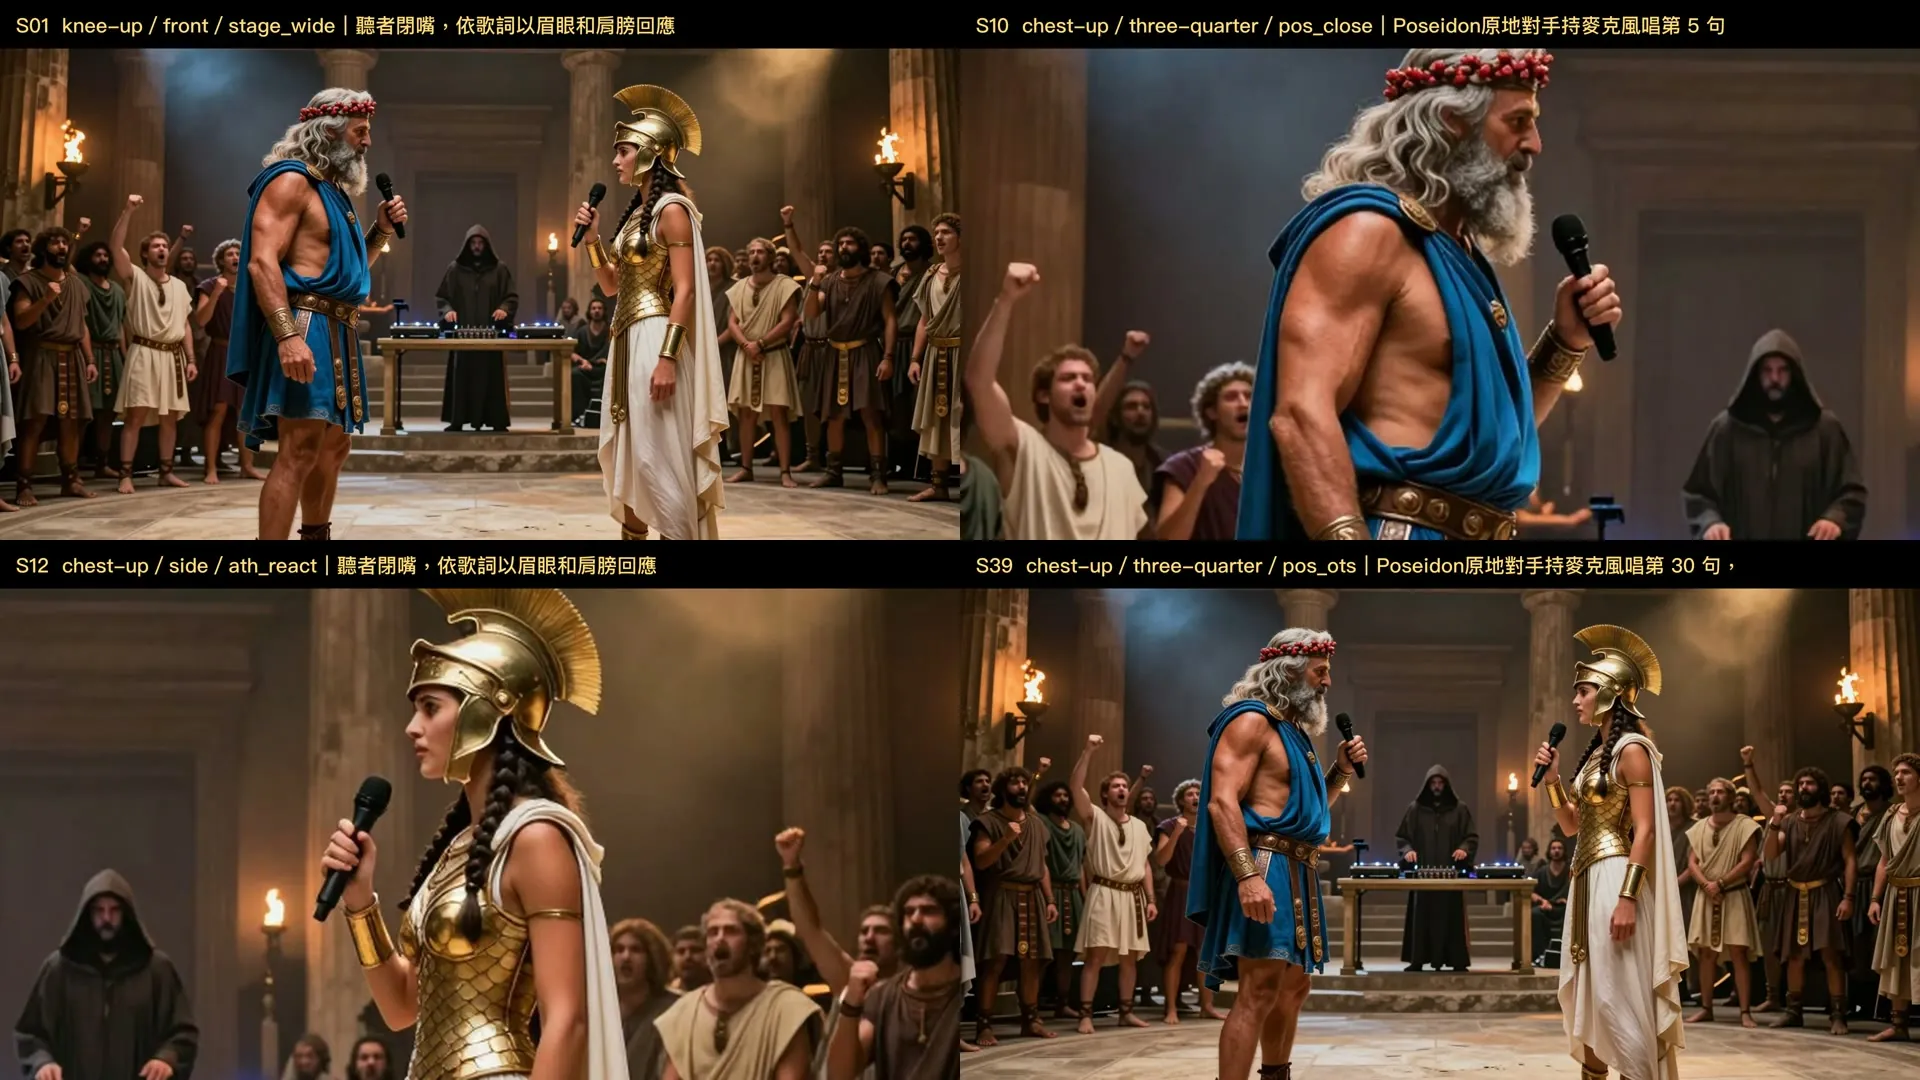
4. 畫分鏡稿,每一鏡一張圖
每一鏡寫景別、運鏡、要傳達什麼、誰在唱,配一張圖,照歌排成動態分鏡先看節奏。照第 3 步的限制寫:
- 參考圖先裁成這一鏡的取景
- 嘴看得清楚的鏡頭,每顆不超過 2 秒
- 相鄰兩鏡的構圖要差很多
- 會重複出現的東西,連顏色寫進一張表
5. 照分鏡稿逐顆生成
每鏡多生 2.5 秒,留給開頭剪掉。每鏡給自己的種子,種子是決定畫面長相的一個數字。轉身這種連續動作,從上一鏡的最後一格接著生。
提示詞照下面三條寫。模型最聽參考圖,其次是聲音,文字排最後(第 3 步),所以三樣要講同一件事。
一、寫明要什麼。 只寫「嘴閉著」,嘴照樣開合;寫成沒在 rap、麥克風放在腰邊、抿著嘴對瞪,嘴才閉上。取景也一樣:給全身照配「胸上」的描述,模型會從全身一路推近;參考圖先裁到半身再生,就沒再推近(那次描述和種子也一起改了)。
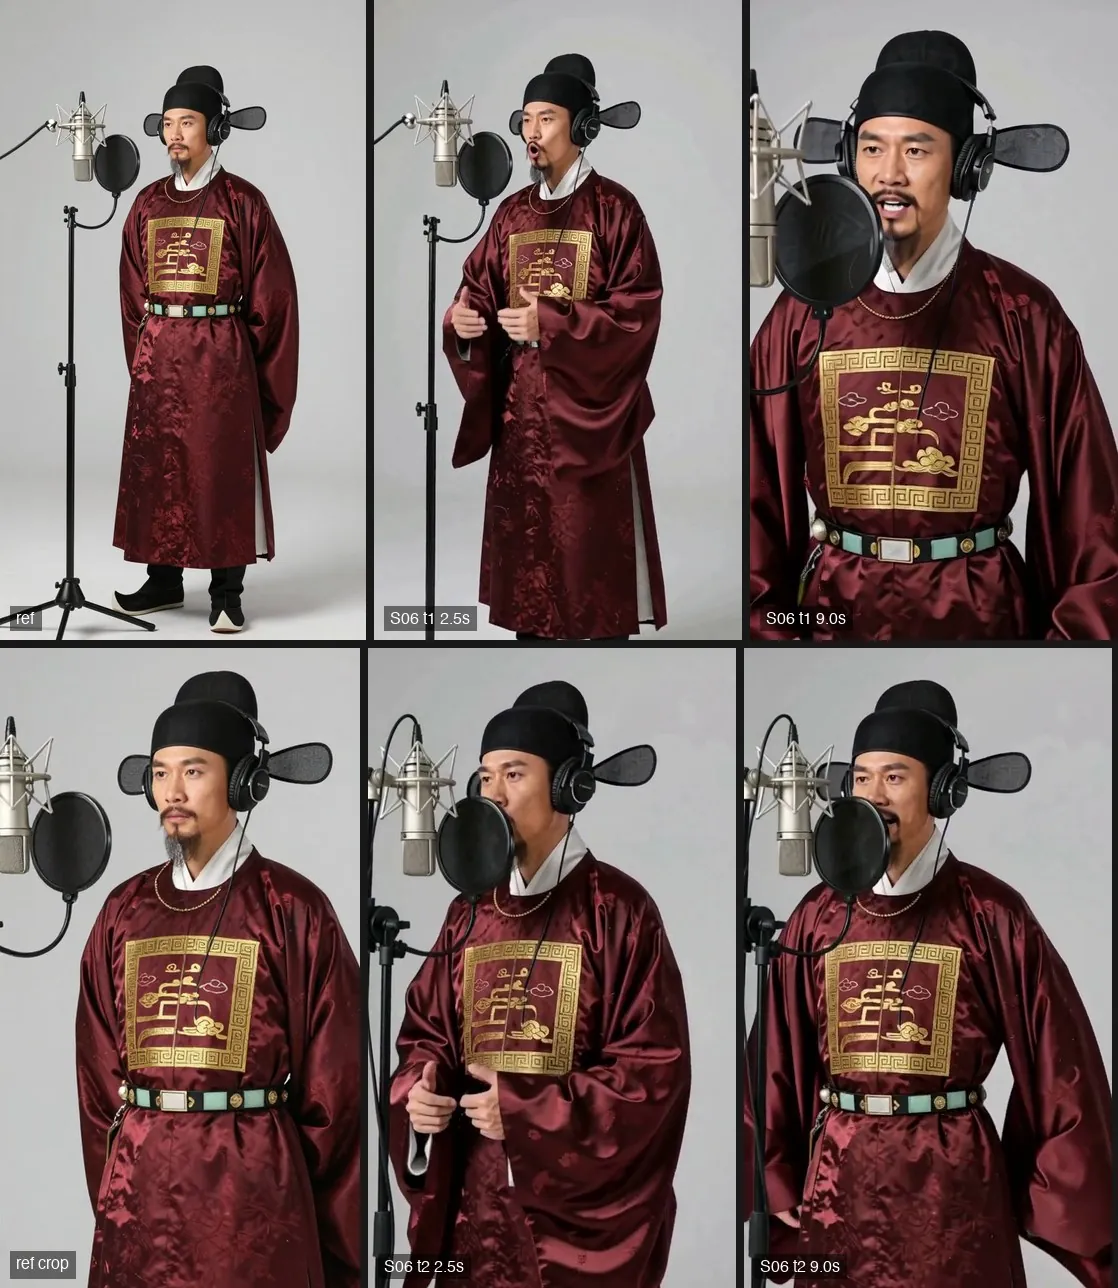
二、不寫多餘的。 提到的東西,模型都可能畫出來:
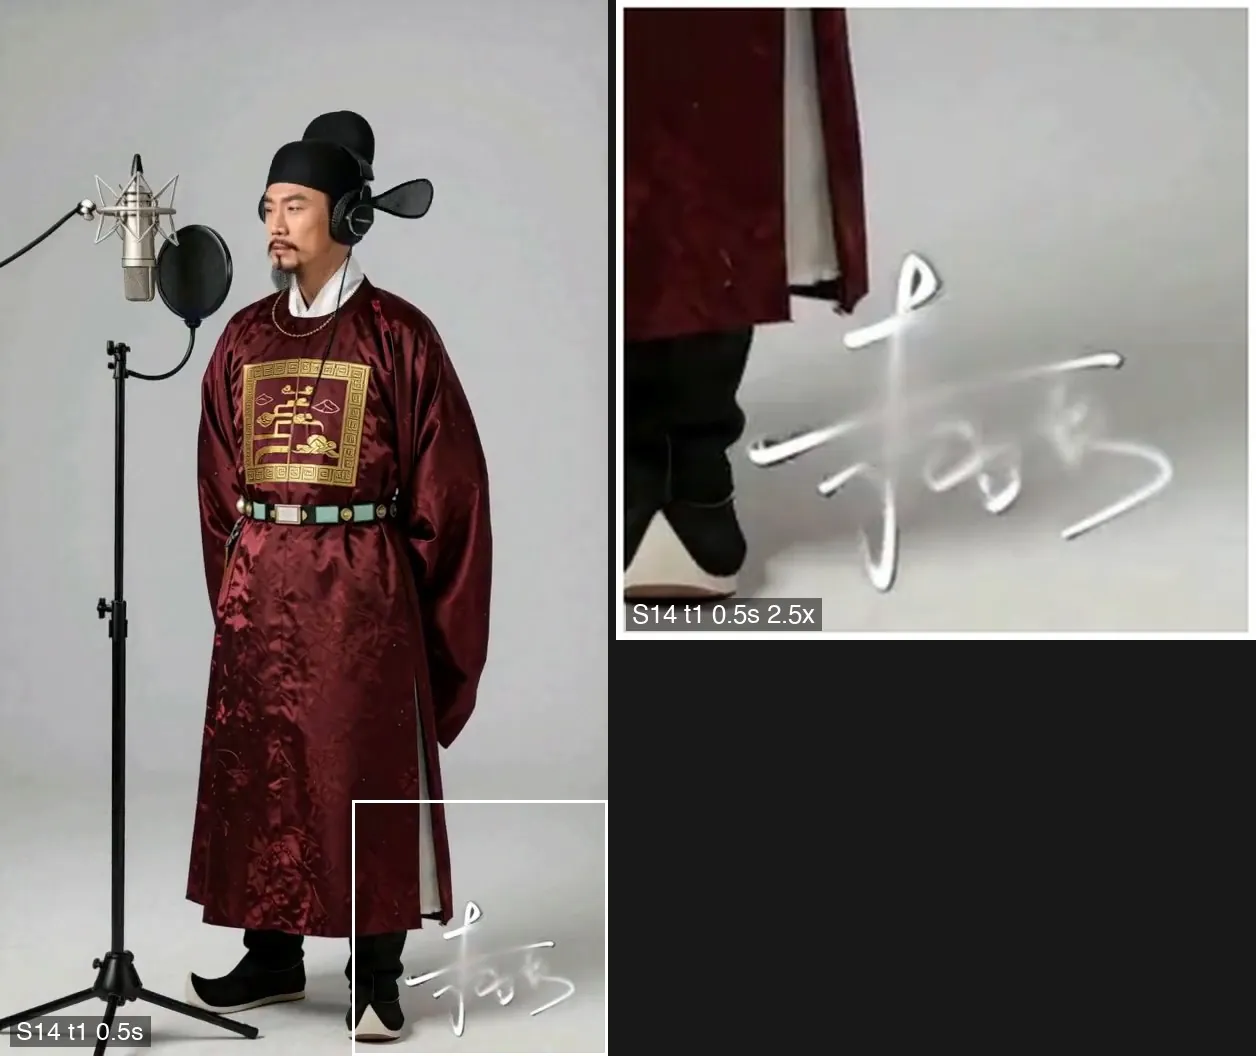
- 寫「右下角留位置,後製要放署名」,右下角就多一串假書法
- 單人鏡的描述寫了另一個人的服裝,就算寫明他在畫面外,他還是被塞進來
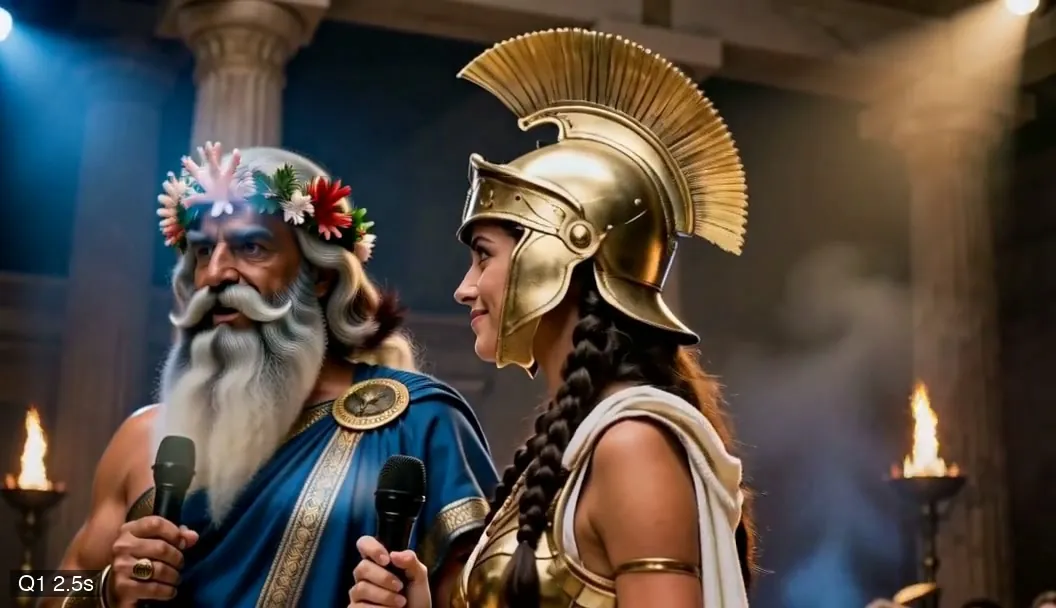
- 所有鏡頭共用的那句寫了全場站位,特寫開頭就先出全景(第 3 步那張圖)
- 表情寫了下巴繃緊,嘴就容易動
後製要加的字別寫進描述,那一塊寫成乾淨的牆。共用句只寫光和服裝,單人鏡只寫那一個人。
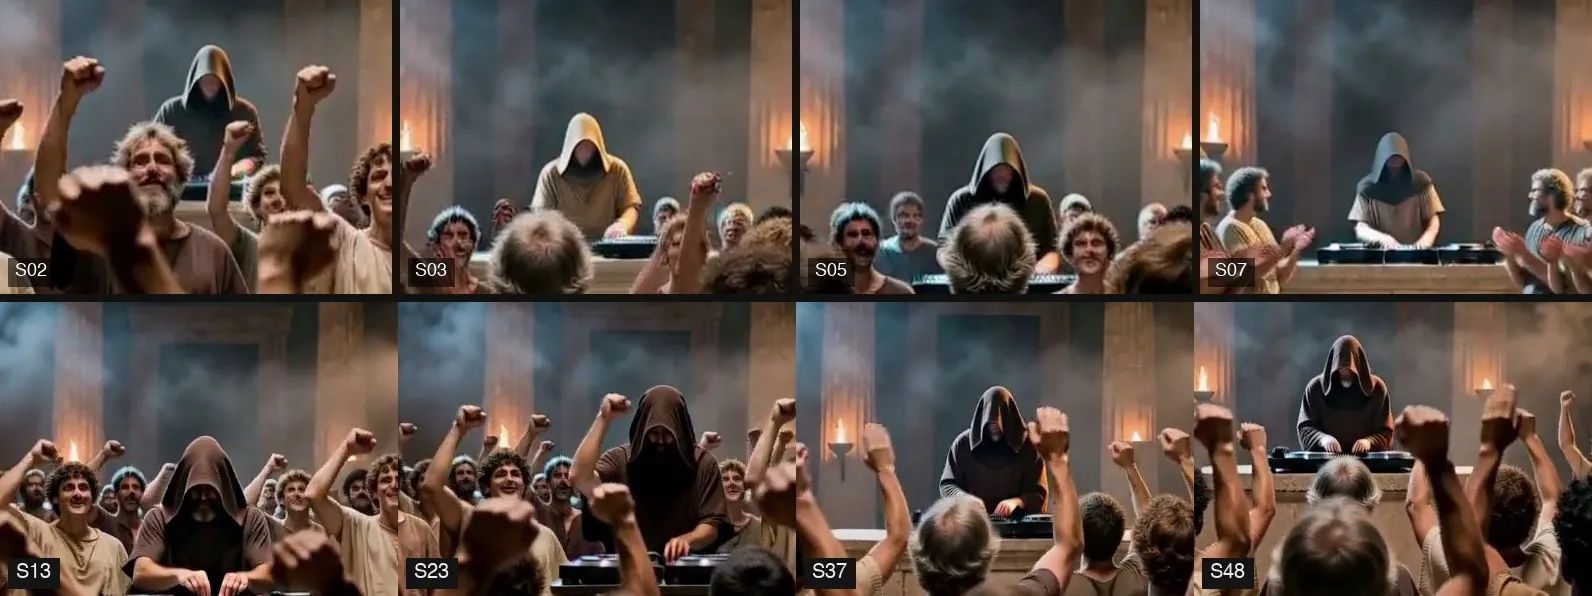
三、要固定的寫清楚。 只寫「戴兜帽」,兜帽顏色每顆不一樣。改寫成「深褐色兜帽、臉藏在陰影裡」,之後生的都是深褐。改之前生好的那幾顆,DJ 在整個畫面裡很小,就沒有重生。
6. 逐顆檢查,漏洞寫成自動檢查
看片前先寫好清單:連戲、左右方向、穿透或漂浮、時間流速、嘴。不過就重生,同一種漏洞出現第二次,就寫成自動檢查,並先拿做錯的樣本試過。
漏洞要記畫面上看到什麼、在第幾秒。〈國姓爺退場〉的結尾記成「人聲已停還在說話」,修的是音軌,沒修到;改記「畫面中人物嘴巴仍在動」才修到。
這條後來寫進〈誰的城〉的清單,同一個毛病在看片時就抓到了。
7. 影片定稿,再提升畫質
H3 生成的畫面只有 1056×608。放大一次要跑很久,所以每一鏡都定了才放,之後重生的鏡頭要重放。
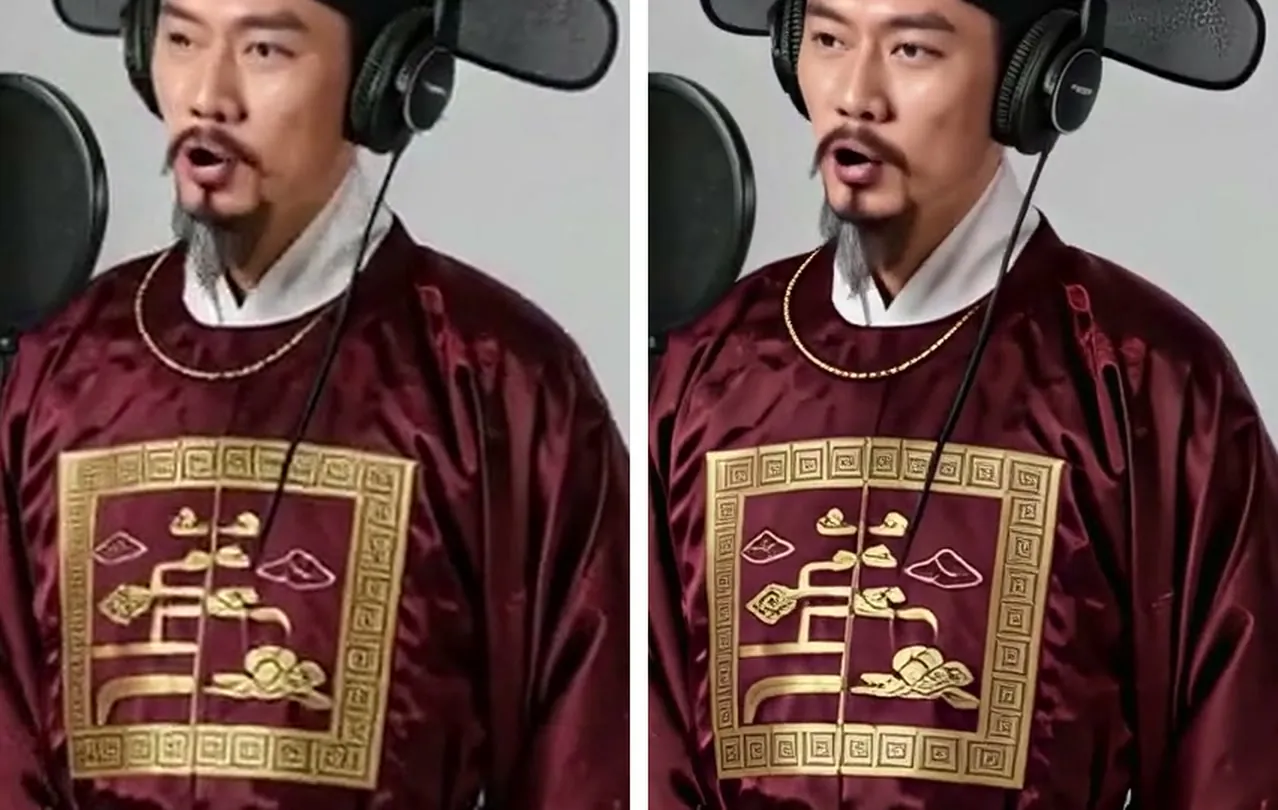
放大也會出錯。有推近的鏡頭撐爆顯示卡記憶體,只好切小段重放;「跳過已放大的鏡頭」只比長度,重生過的鏡頭就沒被重放。放完再檢查格數、切點和凍住的格。4K 約要 1080p 的 10 倍時間,這兩支只做到 1080p。
常見問題
每一鏡的開頭,為什麼像定格?
參考圖模式的第一格幾乎就是參考圖本身。多生一段,把開頭剪掉。
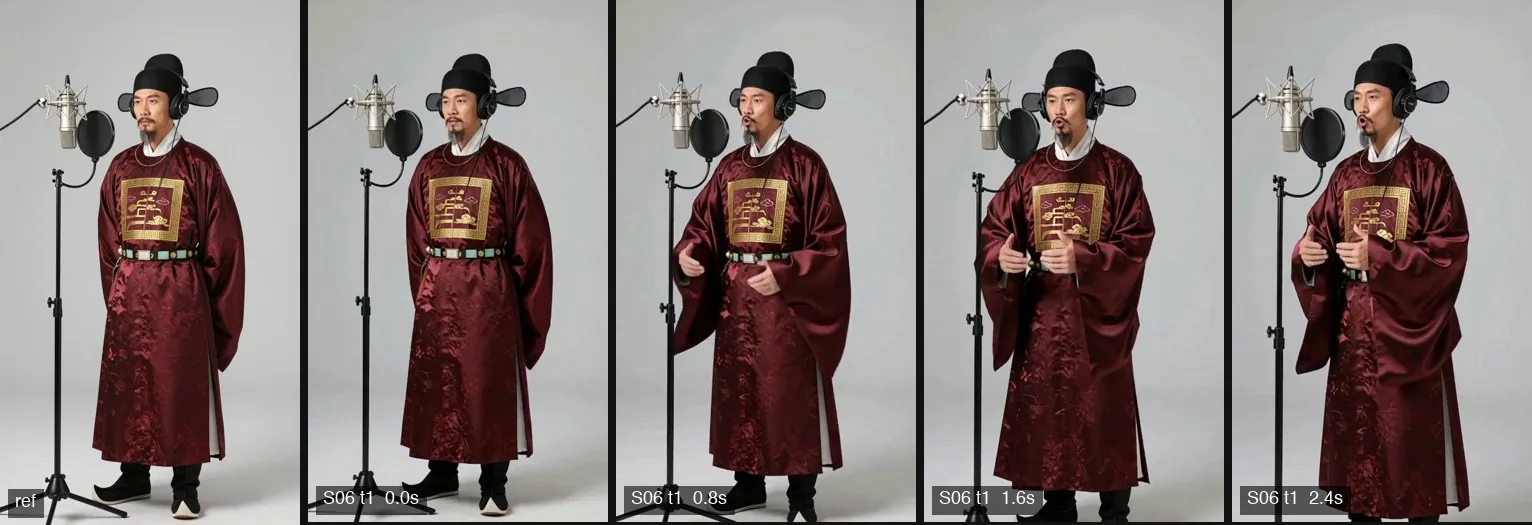
兩顆鏡頭長得像重播?
描述一樣、種子也一樣,就會生出幾乎一樣的畫面。每鏡給自己的種子。
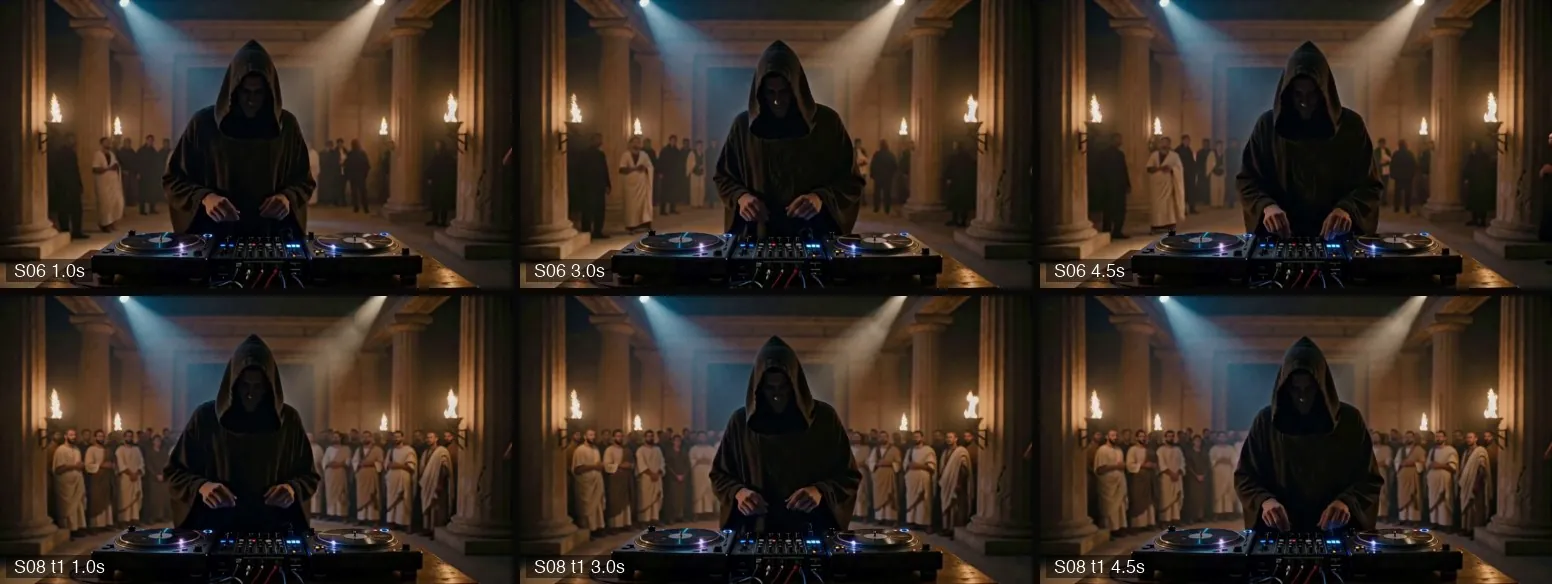
重生好幾次還是錯?
同一種毛病重生兩次還在,就別再換種子,改鏡頭設計或換用別顆的素材。有一顆換寫法、換種子、拿掉聲音,連生四次都在講話,最後換成另一顆沒用到的片段。
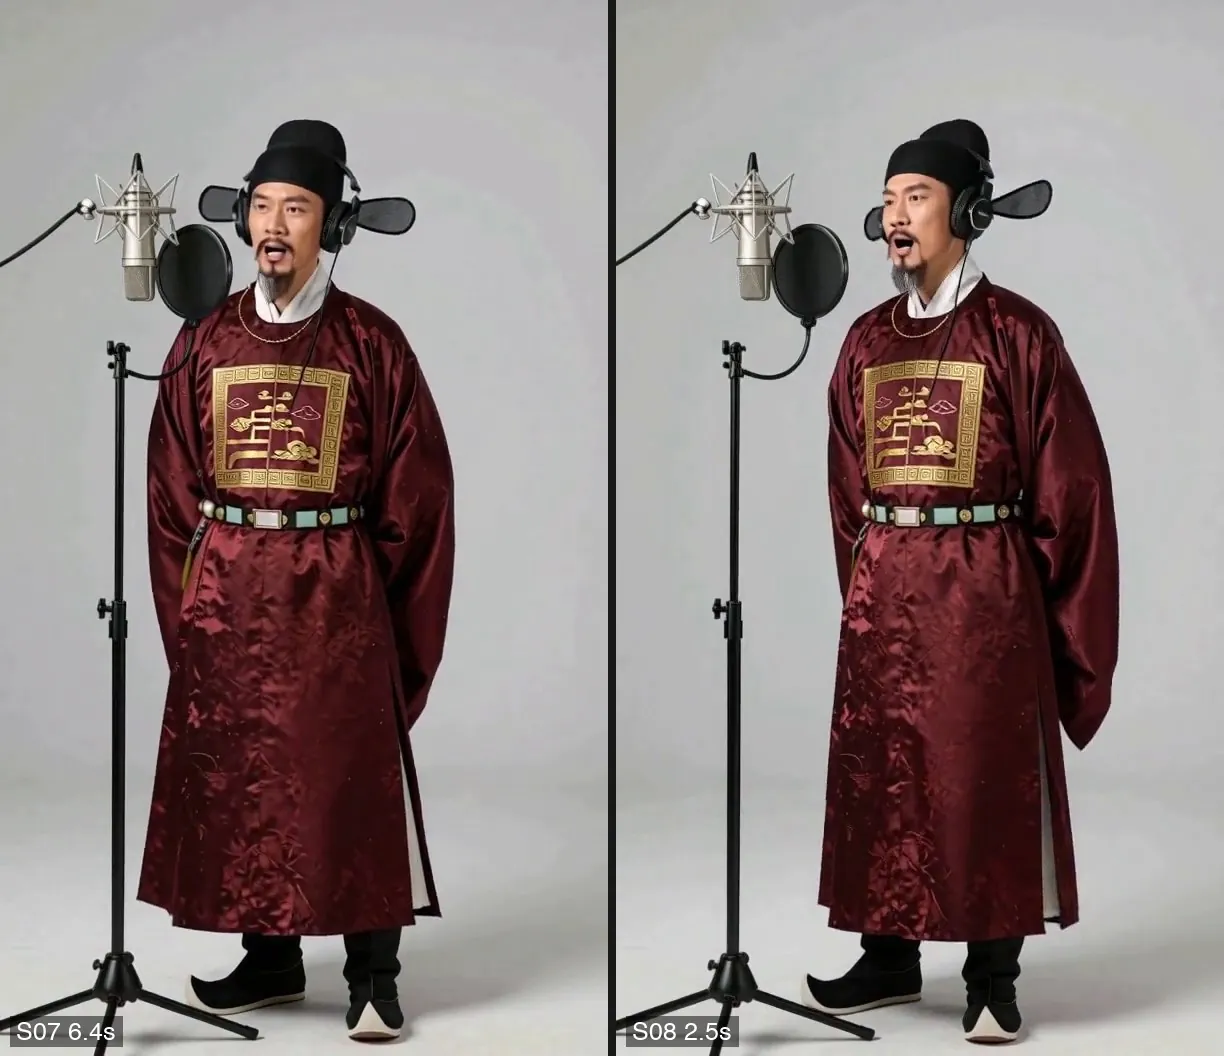
兩鏡接起來,像畫面抖了一下?
這叫跳接:兩鏡構圖幾乎一樣,人只動了幾個像素。分鏡寫低角度、生出來卻是平視,就容易撞上前一鏡。前一鏡在後製慢慢推近,接點就變成取景的變化。
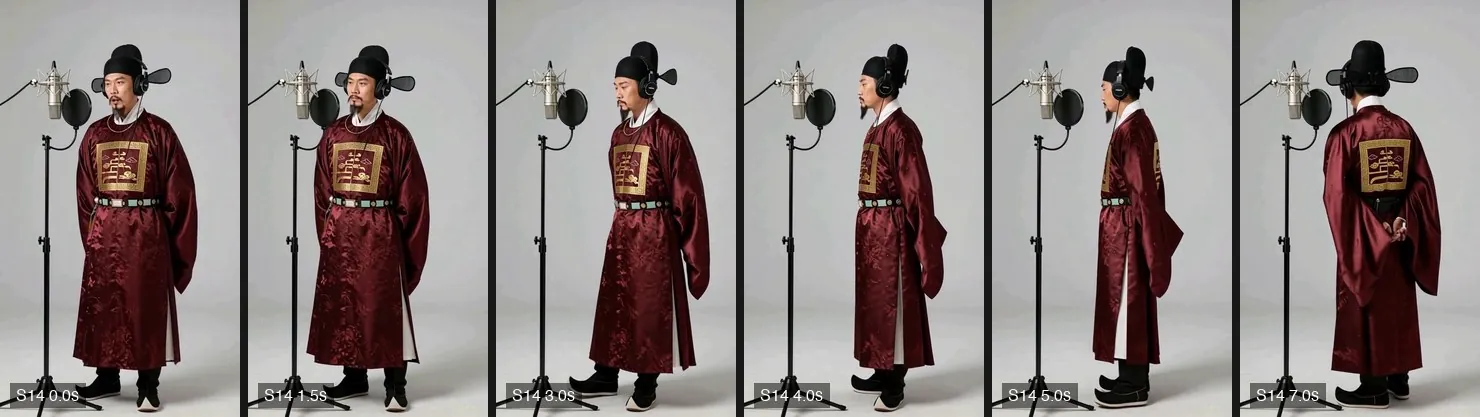
轉身怪怪的,像突然跳成背影?
模型生成的轉身只轉了頭,身體沒轉,剪接又跳過那段,正面就硬切成背影。改成從上一鏡的最後一格接著生成,身體連腳一起轉過去。
每顆鏡頭都太長,節奏很慢?
〈誰的城〉第一版分鏡用影片秒數訂預算,分鏡就偏向長鏡頭,多數一顆 6~7 秒,參考片是 2~3 秒。預算改用顯示卡時間訂,並拿參考片比節奏。
自動檢查把正確的字卡判成錯?
固定門檻在平整的灰牆上夠用,背景換成煙霧和火光就誤判。改成跟「同一格沒有字卡」比。
嘴型能對上歌嗎?
到 2026 年 10 月還不行。量過兩次,嘴張多大跟人聲大小的關係,和故意錯開時間的對照組分不出來,只能照第 4 步從鏡頭設計上避開。
複製給你的 AI Agent
把下面這段貼給你的 AI,讓它對照你手上的歌、角色圖、分鏡和片段。
延伸閱讀
| 資源 | 為什麼重要 |
|---|---|
| 〈AI 做影片:畫面怎麼動、花多少〉 | 六種 AI 影片的做法與成本,這篇只接它沒講的多鏡頭怎麼控。 |
| 〈曹操 VS 刘备 Freestyle 说唱 Battle〉(Boundary into culture,@jieruwenhua) | 〈誰的城〉的結構和鏡頭類型照它量,沒用它的畫面和歌詞。 |