CCR + LiteLLM
Claude Code の頭脳を入れ替えてもインターフェースはそのままに
Claude Code 20x の利用枠は、だいたい四日で底をつきます。計画は Claude Code に任せ、細かいバッチ作業は LiteLLM 上の安価な worker に振り、Codex でもう一度検証する――この『モデルを替え、インターフェースは残す』ワークフローを通じて、他社のモデルが実務でどこまで使えるかも見ていきます。
今朝のあの Codex コマンド
今朝、Codex による検証作業が接続段階で止まりました。同僚に聞いて初めて、会社の OpenAI workspace の責任者アカウントが停止され、チームで使っている Codex を含む workspace 全体が使えなくなったと知りました。この出来事が記事を書き始めた理由ですが、主題ではありません。
その Codex コマンドは何度やり直しても動かず、log を見てようやく CLI 自体がロックされていると分かりました。異議申し立てのメールは送信済みで、OpenAI の回答には少なくとも三営業日かかり、復旧の保証もありません。検証の層は当面 Claude Code だけで回します。LiteLLM 上の小型モデルは使えますが、この層を任せるつもりはありません。理由は後の『三層の役割分担』で説明します。
この記事で本当に話したいのは、最近『Claude Code 20x の利用枠でも足りない』状態から、『LiteLLM で五社の公式 API を接続し、Claude Code が計画し、小型モデルが worker を務め、二つの model で検証する』ワークフローに至るまで試したことです。あわせて DeepSeek、Kimi、GLM、Grok、Qwen が実務でどの程度使えるかも振り返ります。
20x でもなぜ足りないのか
Claude Code 20x のサブスクリプション枠で、計画、実装、debug、検証をすべて任せると、だいたい四日で底をつきます。直感的には『もう一段上げよう』と思いましたが、20x はサブスクリプションの上限です。それ以上は API に切り替えるしかありません。
ccusage の記録を見返して、問題は単に『使いすぎ』ではなく、『Opus でやる必要のない作業まで Opus でやっている』ことだと気づきました。N 個のファイルで同じ import path を直す、N 段の markdown を英訳する、N 回 grep して結果を整理する。こうしたバッチ処理や機械的な作業なら、DeepSeek V3 や Qwen Flash で費用を九割減らせて、結果の差もほとんどありません。
この考え方で分解すると、自然に三層になります。
LiteLLM を調べ始めたのはこのときです。一方では第二層を担う安価な worker model を探したく、もう一方では、よく話題になる DeepSeek / Kimi / GLM / Grok / Qwen を実務で使うとどうなのか、興味がありました。
三層の役割分担:計画 / Worker / 二重検証
計画は Claude Code、worker は LiteLLM 上の小型モデル、検証は Claude Code と Codex で相互に確認します。この三層分担は、少しずつ試してたどり着いたものです。
検証には二つの model を使います。Claude Code に一度確認させ、『テストの六つの鉄則』に沿って一つずつ採点し、違反を洗い出してもらいます(規則と出典は次の節で説明します)。Codex には worktree の git diff を直接渡してもう一度確認させ、コードそのものから bug、命名の不一致、見落とした境界条件を探してもらいます。
二つの model にはそれぞれ盲点があります。Claude Code は『うちのルール』に詳しい一方、純粋な構文や境界条件の誤りには Codex ほど敏感ではありません。Codex は diff を細かく見ますが、私の rules は知りません。組み合わせることで盲点を補えます。
検証層を LiteLLM 上の小型モデルに任せないのは、実際に試したからです。小型モデルは『worker 自身が見落とした問題を見つける』ような慎重な reasoning が必要な作業では、明らかに発見率が足りません。レビューらしく見えても、肝心な bug を見逃すことがよくあります。worker のバッチ作業なら安心して任せられますが、検証の基準として今の私が信頼できるのは Claude Code と Codex だけです。今朝 Codex 側が止まってからは、検証を Claude Code 一つで支える形に後退しました。自分で worker を務めて自分で検証することには限界がありますが、短期的にはほかに良い選択肢がありません。
テストの六つの鉄則
この六つは一度に作ったものではなく、何度も失敗しながら積み上げたものです。今は Claude Code が worker の成果を検証するとき、一つずつ採点する基準になっています。
runtime → 回帰テスト
テストは必ず実際に実行します。import check や type check だけでは足りません。stack trace が出るところまで動かして初めて意味があります。
出典と発展
最初のきっかけは二つの記事です。
| 出典 | 得られたこと |
|---|---|
| How to Test AI-Generated Code the Right Way in 2026 (Katerina Tomislav, 2026-02) |
AI が書いたテストの最大の問題は『100% の行カバレッジ、4% の mutation score』だと述べています。カバレッジは見栄えがよくても、96% の bug を見逃します。HumanEval-Java の研究データを引用しています。 |
| Salesforce VIBEPASS | この benchmark では、bug があると事前に知らされていない最先端の LLM が、コード内の潜在的な bug を見つけて修正できる割合は 50% 未満でした。つまり、AI 自身が書いたテストでは、自分のコードの問題を捉えられない可能性が高いのです。 |
Katerina の原文は、mutation testing、AI-aware code review、CI pipeline validation、prompt engineering という 4 つの方向性を挙げていました。私はまず mutation testing を取り入れ、さらに失敗の経験からいくつか加えました。
- 第一段階では『テスト作成と実装の分離』を追加――自分で書いた 27 個のテストはすべて通りましたが、実装を見せずに独立した sub-agent にテストを書かせると、すぐに本物の bug が 2 個見つかりました。
- 第二段階では『不変条件を優先』を追加――固定の I/O pair だけでは同じことを言い直しているにすぎず、invariant だけが実装から独立しています。
- 第三段階では『runtime → 回帰テスト』『mock は外部 I/O に限定』を追加――どちらも mock に隠されて『テスト済み』になった bug が production で発覚した経験から生まれました。
- 最後に『下書きは完成品ではない』を追加――Salesforce VIBEPASS の結論を踏まえ、AI 自身が書いたテストを盲信せず、commit 前に必ず見直すためです。
これで六つです。検証用のプロンプトでは、この六つを system prompt に入れ、worker が提出した diff + tests を Claude Code に一つずつ確認させます。どの規則に違反し、なぜ違反で、どう直すかをすべて列挙させます。Codex 側にはこの六つを適用せず、『純粋なコードの bug と規範』という別の視点で見てもらいます。だからこそ、同じ model を二度使うより、二つの model を組み合わせるほうが有用なのです。
OpenRouter ではなく五社の公式 API を選んだ理由
worker を誰に任せるかを考えた結果、私は五社の直接契約を選び、 OpenRouter のように、一つの SDK と一つの決済で全 model を使える aggregator は見送りました。
以前、 koc.com.tw のプロバイダー比較記事を読んで、仲介サービスも一時は良さそうだと思いましたが、実際に計算すると四つの欠点がありました。
- 上乗せ料金で公式 promo のメリットが消える。仲介サービスの 5%-20% の上乗せは小さく見えますが、各社の公式キャンペーン、新規ユーザー向け利用枠、期間限定の割引をすべて逃します。
- 公式サイト限定の利用枠を受け取れない。DeepSeek、Qwen、Moonshot は新規ユーザーやキャンペーン向けに token を配布したことがありますが、直接契約していなければ受け取れません。
- 決済がブラックボックスで、debug しにくい。エラー時に仲介サービスの routing が原因なのか、upstream provider の障害なのか区別できません。
- prompt / response が加工されるか分からない。仲介サービスが system prompt、tool schema、stream chunking を変更していないでしょうか。『各社の素の性能を評価する』うえではノイズです。各社の本来の実力を直接見たいという好奇心もあったので、これで仲介サービスはやめました。
最終的に選んだ五社の直接契約:
| Provider | 位置づけ |
|---|---|
| Moonshot(Kimi) | Agent のタスク、深い推論(Kimi K2-Thinking は BrowseComp / AIME で先行) |
| Z.AI(GLM) | 中国語の長文(Arena Chinese で首位) |
| DeepSeek | 費用対効果が最も高い worker の主力($0.28/$0.42、デフォルトのバックグラウンド作業) |
| xAI(Grok) | コーディング + 2M context の旗艦モデル(SWE-Bench で先行) |
| アリババ(Qwen via DashScope) | 超高速・低コスト(qwen3.5-flash $0.10/$0.40 は全候補で最も安い input 価格) |
その後、fallback chain を厚くするために MiniMax と Google Gemini も追加しました。
Google Developer Program のクレジット
私が Google Developer Program に参加すると、Premium tier には毎月 $10 monthly Gen AI & Cloud credits クレジットが付与されます(一度限りのクレジットで、有効期間は一年)。AI Studio と Vertex AI の Gemini API 利用料に直接充当できます。
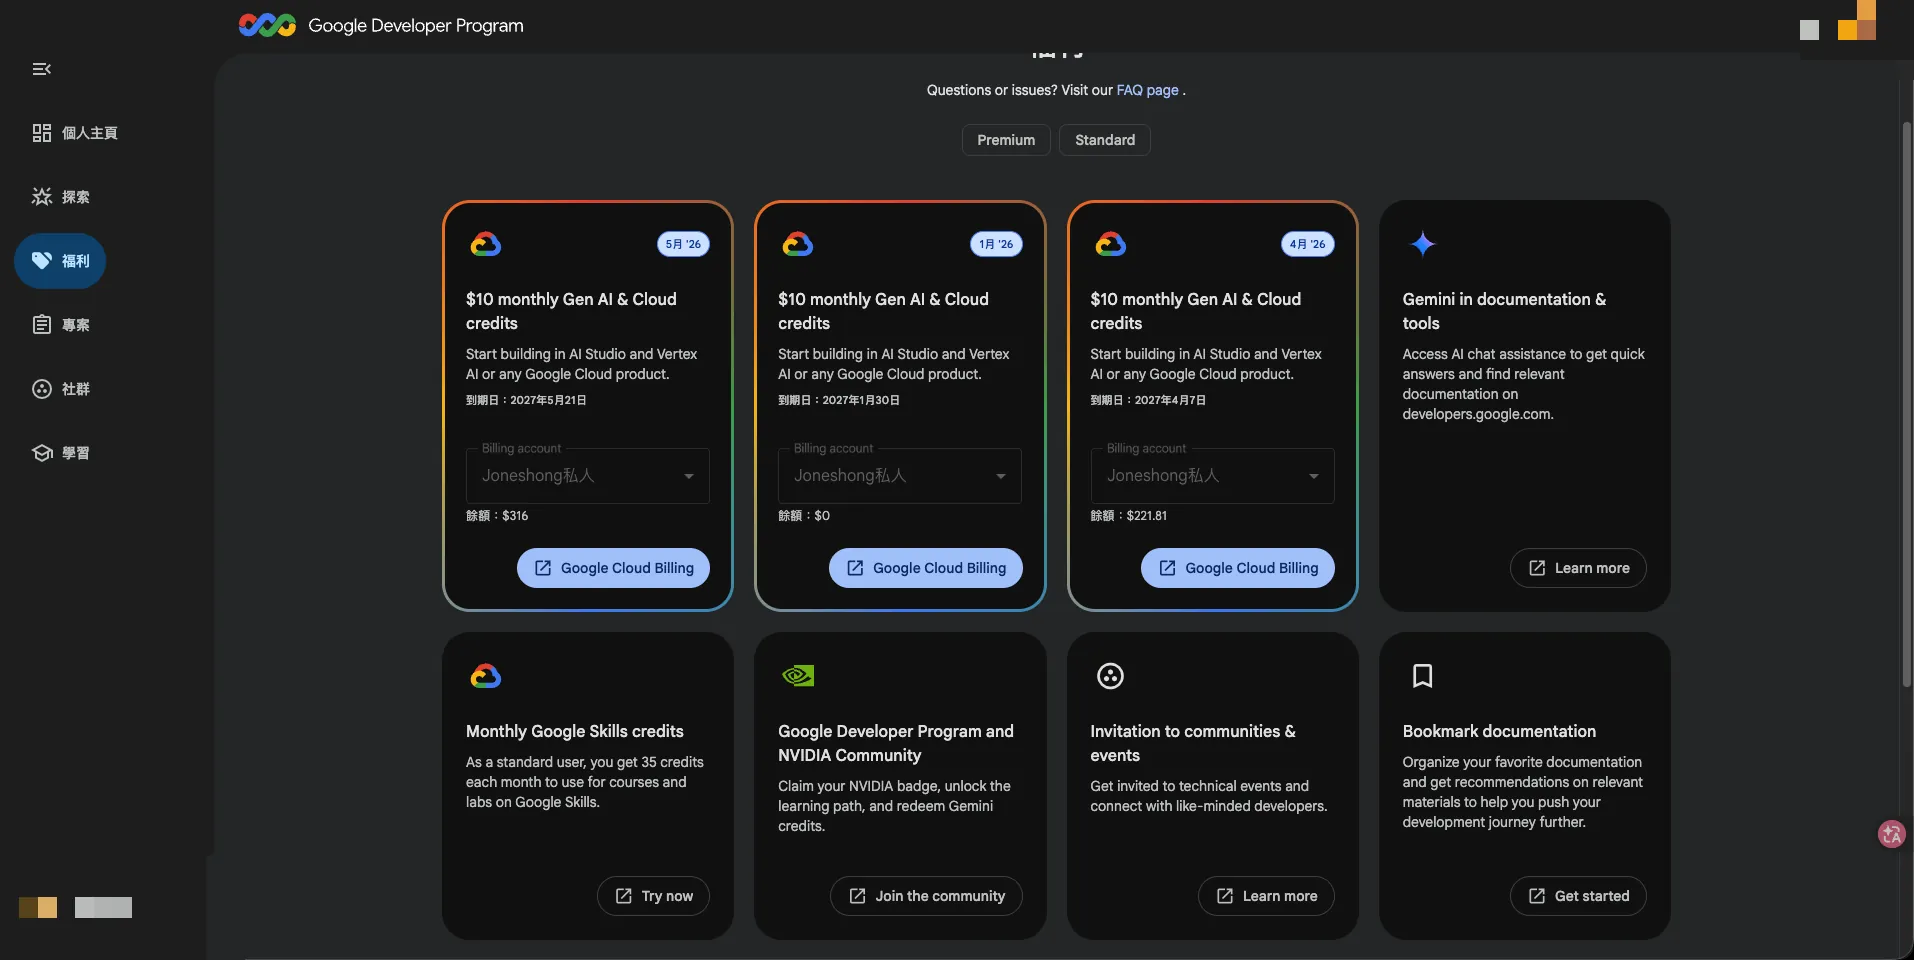
Google Developer Program のクレジットは Google Cloud Billing の管理画面で付与履歴を確認できます。一枚あたり $315-$320 で、月ごとの合計は $300+。Gemini API の利用料に充てられます。
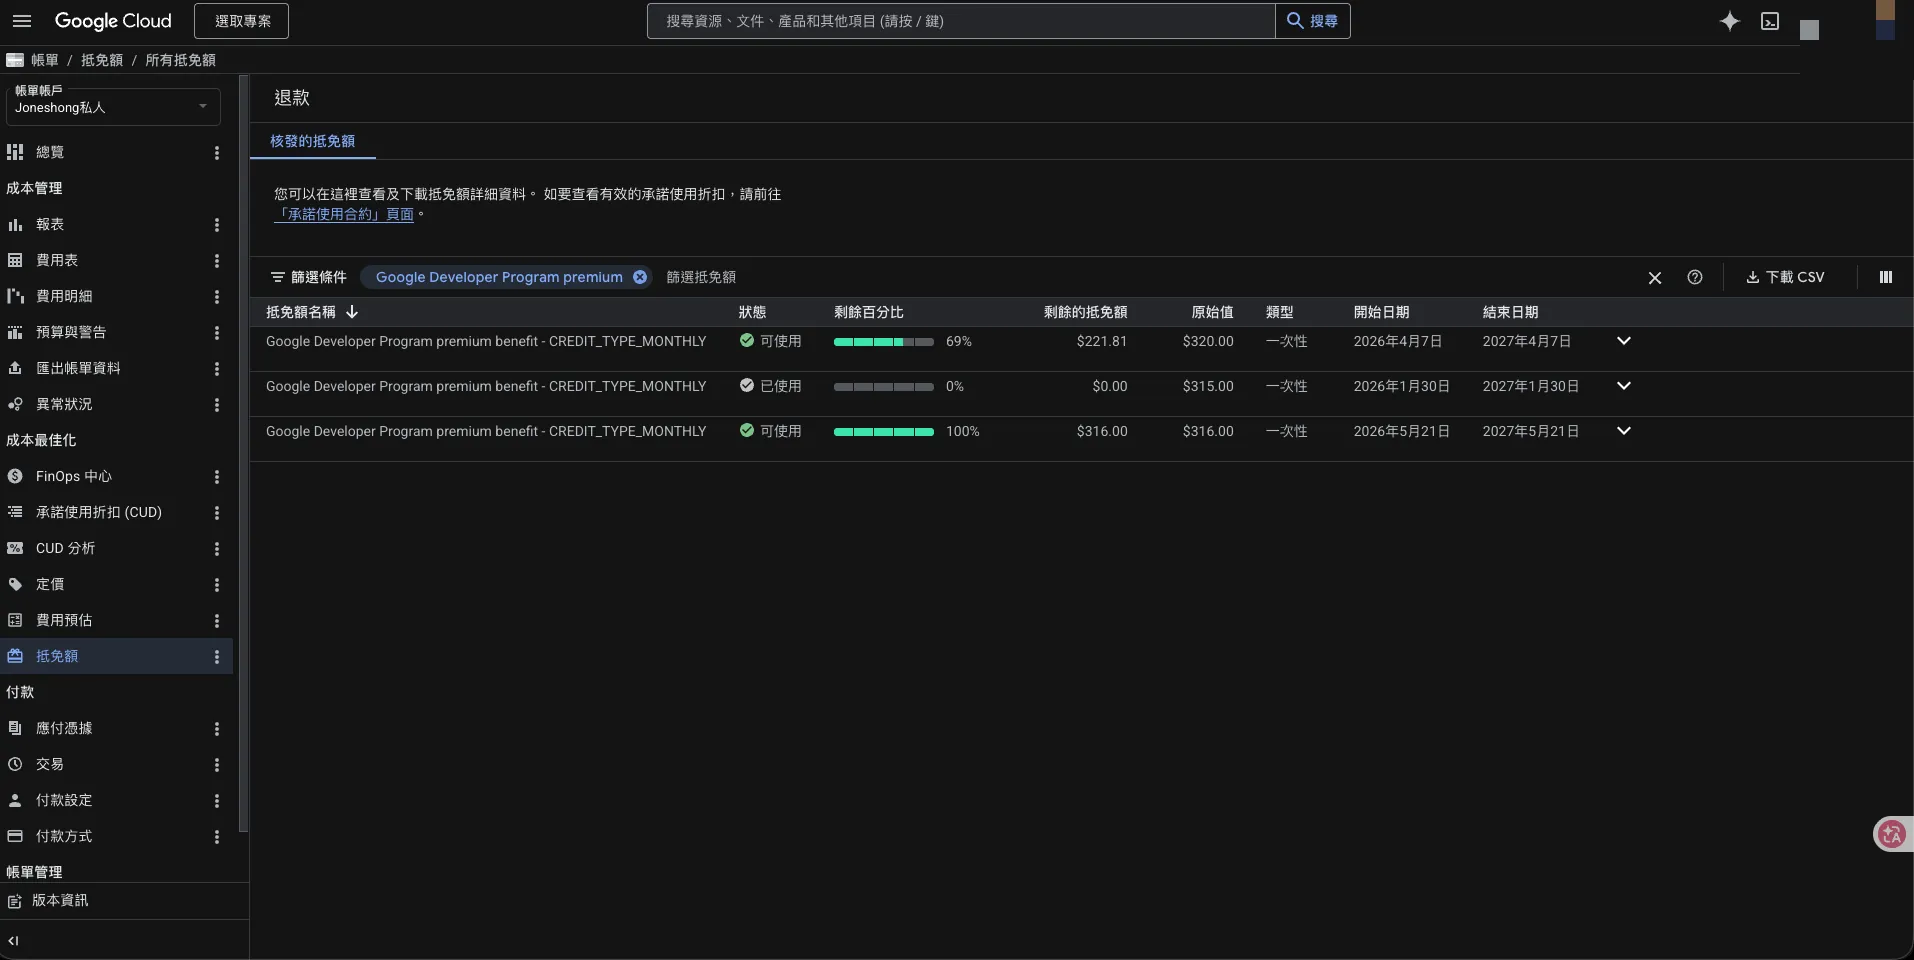
つまり Gemini を LiteLLM につなぐと、このゲートウェイには『無料 model』の枠が自動的にできます。利用枠が尽きたときに gemini-2.5-flash worker を動かしても費用を気にせずに済みます。これは『公式サイトで直接契約する』選択のおまけで、OpenRouter 経由では得られません。
CCR をインターフェースに選んだ理由:やはり Claude Code を使いたいから
最近、Claude Code、Codex、Gemini CLI、Copilot CLI など主要な CLI agent を一通り試しましたが、結局 Claude Code がいちばん使いやすいと感じます。tool use の設計、subagent の仕組み、skill / slash command の体系、git worktree との連携、context 管理、permission flow が全体として一歩先を行っています。試したものは次のとおりです。
ほかの model も使うなら、理想は『モデルを替え、インターフェースは残す』ことです。
最初は『LiteLLM + 短い zsh function』で済ませるつもりでした。Claude Code の ANTHROPIC_BASE_URL 接続先を LiteLLM に向けて :4000request body を自分で少し直せばよい、と。ところが書き始めると、各社のプロトコルには細かな違いが数多くありました。Anthropic の messages API と OpenAI chat/completions では system message、tool definition、stream chunking、reasoning content block の形式が違います。どこか一つでも合わないと 400 になったり、メッセージが黙って落ちたりします。半日ほど transformer を書いたところで、これは自作すべきではないと気づき、そのとき claude-code-router(略して CCR)という既存の transformer を見つけました。
CCR はローカルで :3456 server を動かし、Claude Code には Anthropic API のように見せます。下流にはリクエストを OpenAI プロトコルに transform して LiteLLM へ送ります。Claude Code からすると Anthropic と話している『つもり』でも、実際のリクエストは DeepSeek、Kimi、Grok にルーティングされます。つまり CCR があれば、Claude Code のインターフェースで LiteLLM 上のどの model も使えます。インターフェースも使い慣れた操作も変えず、subagent / skill の体系もそのまま引き継げます。
cc-switch を使わない理由
途中で cc-switch というコミュニティ製ツールも試しました。Claude Code の provider をワンクリックで切り替えられ、私の要件にぴったりに見えました。しかし導入してみると、切り替えは ~/.claude/settings.json:
~/.claude/settings.jsonという Claude Code の 全体で共有する単一のファイルを直接書き換える方式でした。一度切り替えると、そのマシン上の Claude Code session がすべて一緒に変わります。- 私のワークフローでは、tmux の複数 pane を並列でよく使います。一つで Kimi に計画させ、一つで DeepSeek worker を走らせ、もう一つで Grok に長い context を処理させます。cc-switch で一度切り替えると三つの pane が同じ provider になり、再度切り替えるとまた全 pane が別の provider になります。これでは『異なる model を並列実行する』ことができません。
CCR + ENV var の方法は逆で、ANTHROPIC_BASE_URL と ANTHROPIC_MODEL は per-process の環境変数です。tmux の各 pane は独立した shell なので、互いに影響しません。次の節の cc-llm はこの仕組みを使います。
実際にはこのようになります。tmux window を縦に四分割し、それぞれの Claude Code で別々の model を使っています。
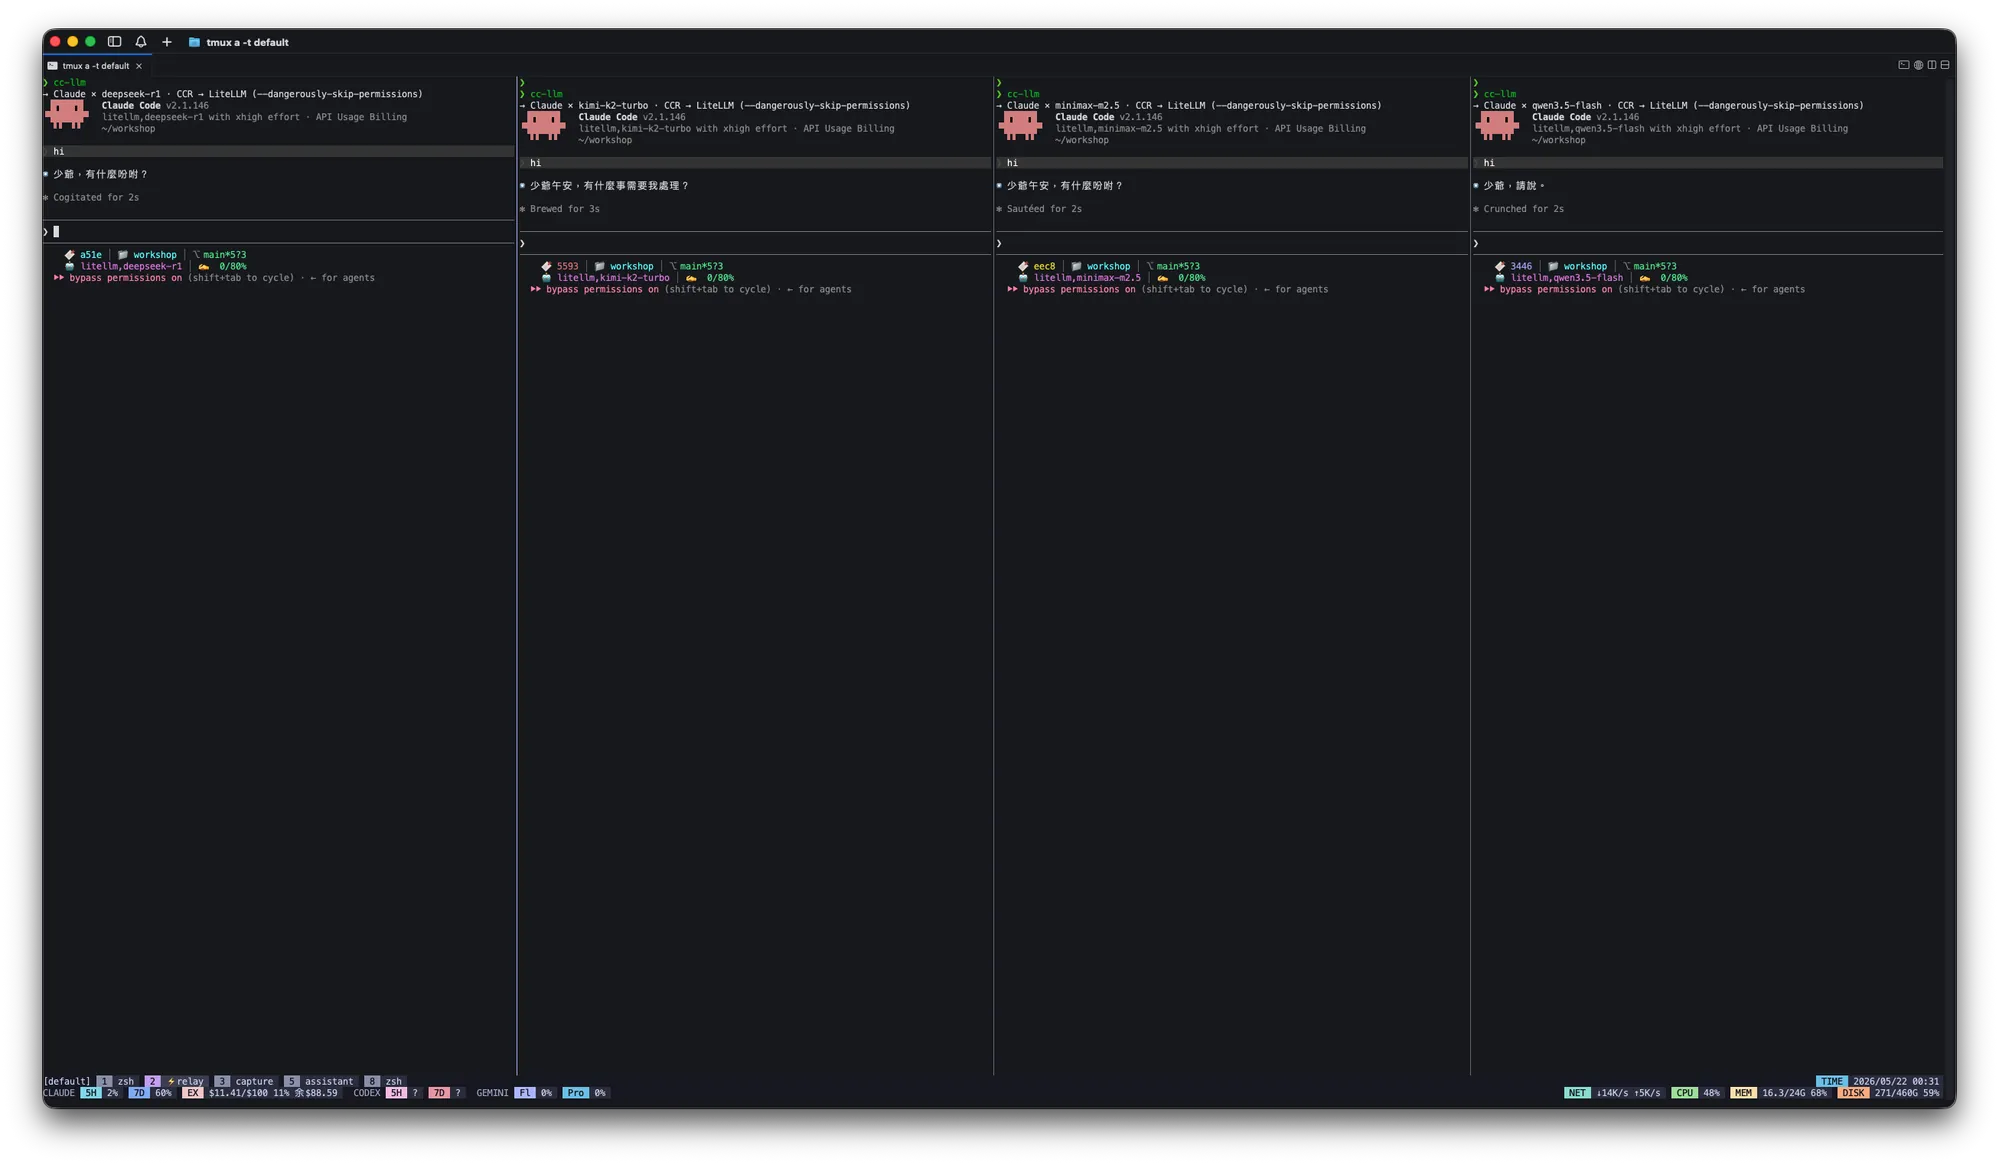
statusline には各 pane の割り当てがそれぞれ表示されます。litellm,deepseek-r1、litellm,kimi-k2-turbo、litellm,minimax-m2.5、litellm,qwen3.5-flash。四つの pane が同時に異なる model を使っていても、CCR :3456 はリクエストを見てルーティングする proxy にすぎず、どの pane から来たかは気にしません。~/.claude/settings.json にもまったく手を加えません。切り替えはすべて shell session 内で完結します。『同じマシンで複数の model を同時に動かす』用途では、CCR が既存の選択肢で唯一実現できる方法です。
技術的な骨組み:LiteLLM + CCR + 自作の zsh function
ルートは二本あります。Claude Code は Anthropic protocol を使い、まず CCR の :3456 で OpenAI プロトコルに変換してから LiteLLM の :4000へ進みます。一方、Codex、Gemini、OpenCode の CLI はもともと OpenAI プロトコルに対応しているため、CCR を経由せず LiteLLM の :4000に直接接続します。図にすると次のとおりです。
LiteLLM が唯一のゲートウェイです。model_list、API key、fallback、cost telemetry はすべて一つの config.yamlにまとめ、provider ごとに entry を一つ置き、API key はすべて env var で参照します。例えば次のような形です(一つの entry を見れば十分です)。
drop_params + modify_params は失敗を経験してから追加した『400 を防ぐ』ための二重の安全策で、provider ごとの param schema を手動で合わせる手間を省きます。fallbacks 設定後は、model A が 429/5xx を返すと自動的に B に切り替わります。
CCR 側の config.json 構造はもっと単純で、最も重要なのは Router ブロックでタスクの種類を具体的な model に対応づけることです。
最後に、すべてを一行のコマンドにする自作の zsh function です cc-llm(機密情報を除いた骨組み):
実際に使うと、cc-llm を直接呼び出すだけで fzf の選択メニューが開き、LiteLLM で現在利用可能な model が自動取得され、provider ごとに表示されます。
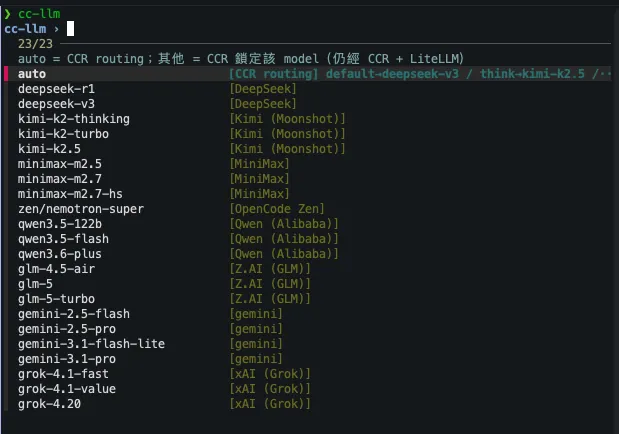
model を選ぶと Claude Code が TUI で起動し、statusline に経由するルート、使う model、effort の設定が明示されます。
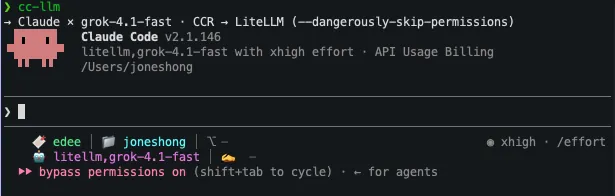
例えば上の画像では、タイトル行の『Claude × grok-4.1-fast · CCR → LiteLLM』が zsh function の出力です。その下の『litellm,grok-4.1-fast』は Claude Code 自身が ANTHROPIC_MODEL を読み取って表示したものです。effort は xhigh に固定され、bypass permissions on になっています。これらが想定どおりなら、安心して作業を始められます。
ほかの使い方:
同じ種類の wrapper として、 cx-llm(Codex)、gm-llm(Gemini CLI)、oc-llm(OpenCode)も作りました。この三つは CCR とプロトコルが合わないため、LiteLLM に直接接続します。すべての CLI が一つの LiteLLM config.yamlを共有するので、新しい model の追加は一か所の変更で済みます。
subagent にも下位のモデルを設定する
explorer、researcher、browser、media の四つの subagent は簡単なタスクを担当するため、model をデフォルトの sonnet から haiku に変えました。subagent の定義ファイル(~/.claude/agents/*.md)にある model: フィールドがこの設定を制御します。メインの対話が subagent にタスクを任せ、subagent が結果を返したら、メインの対話が続けます。
| Agent | 用途 | 変更後の model |
|---|---|---|
explorer | codebase の検索、ファイル探し | haiku |
researcher | web 検索、資料整理 | haiku |
browser | Playwright CLI browser automation | haiku |
media | 動画 / 音声 / 画像 / OCR の処理 | haiku |
この四つのタスクに共通するのは、tool call が多く、reasoning は浅く、高度な model の能力は不要なのに、大量の turn と context を消費することです。以前はすべて sonnet で動かしていたため利用枠の消費が大きかったのですが、haiku に変えると費用は九割減り、品質にも目立った低下はありませんでした。
さらに動的にも調整しています。私が書いた model-policy daemon は五分ごとに Claude の残り利用枠を確認し、normal / boost-1 / boost-2 / boost-3 の四段階で切り替えます。利用枠が十分なら haiku は haiku のままです。利用枠が尽きそうになると(5h < 25% または 7d < 40%)、haiku を sonnet、sonnet を opus に自動で上げ、『大きな model を使えるとき』には使い切り、『節約すべきとき』には自動で下位に戻します。
この役割分担は『Claude Code の内部』のものです。メインの対話では sonnet/opus が計画し、簡単な仕事を任された subagent は haiku で動きます。LiteLLM の『外部 worker』とは別々の節約経路なので、併用できます。
各 model の現在の利用量を把握する
ワークフローができたところで、もう一つ小さな問題が残りました。五社に Big-3 を加えると dashboard が八つあり、サイトごとにレイアウトも違います。各社の管理画面をいくつか見てみましょう。
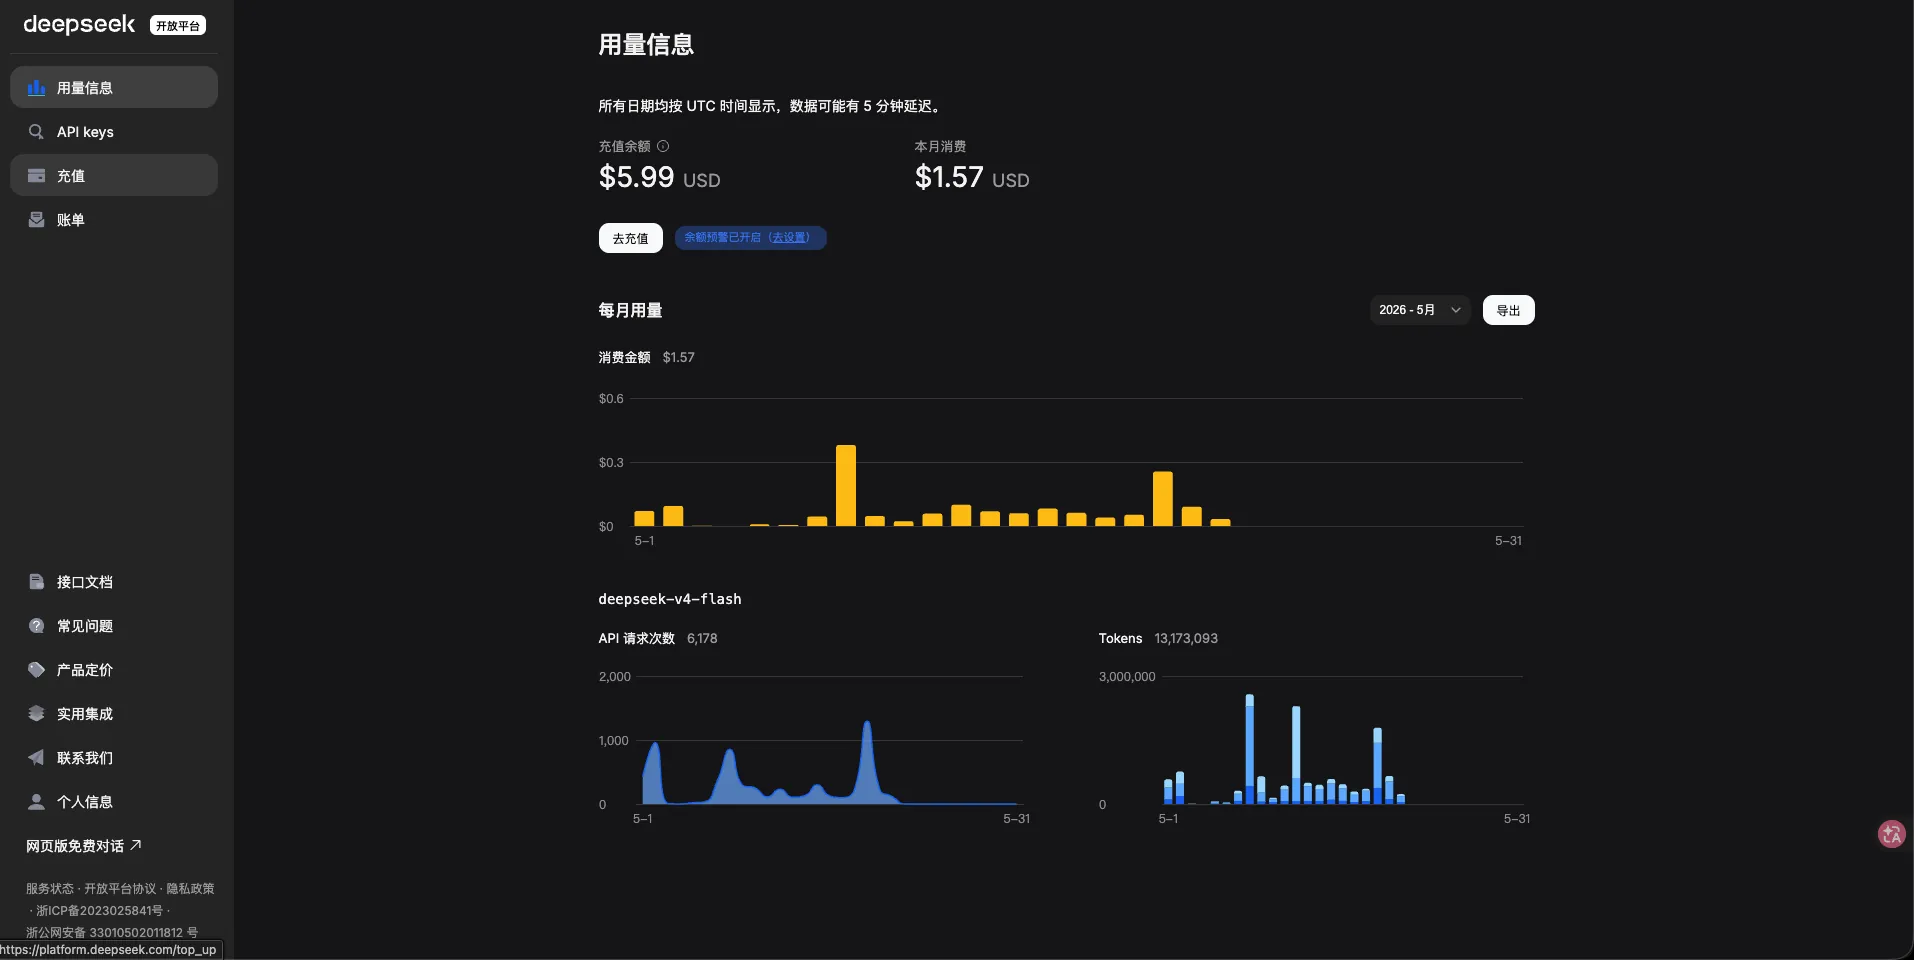
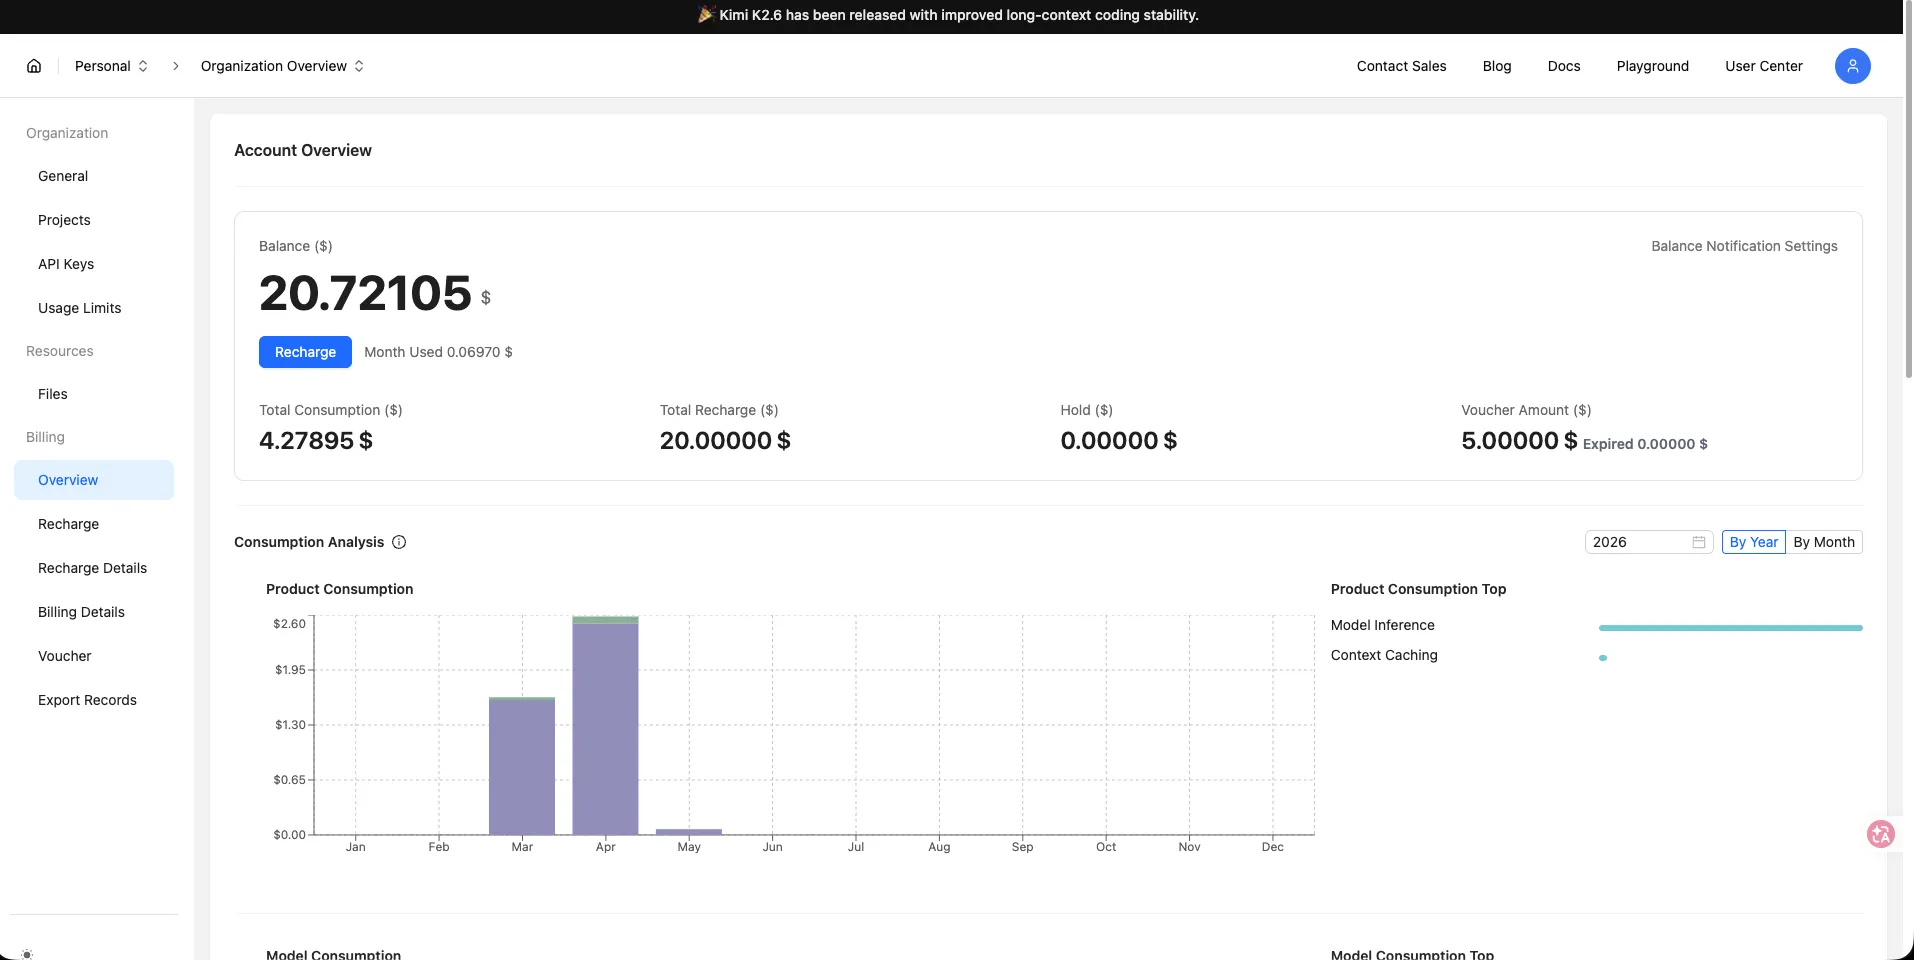
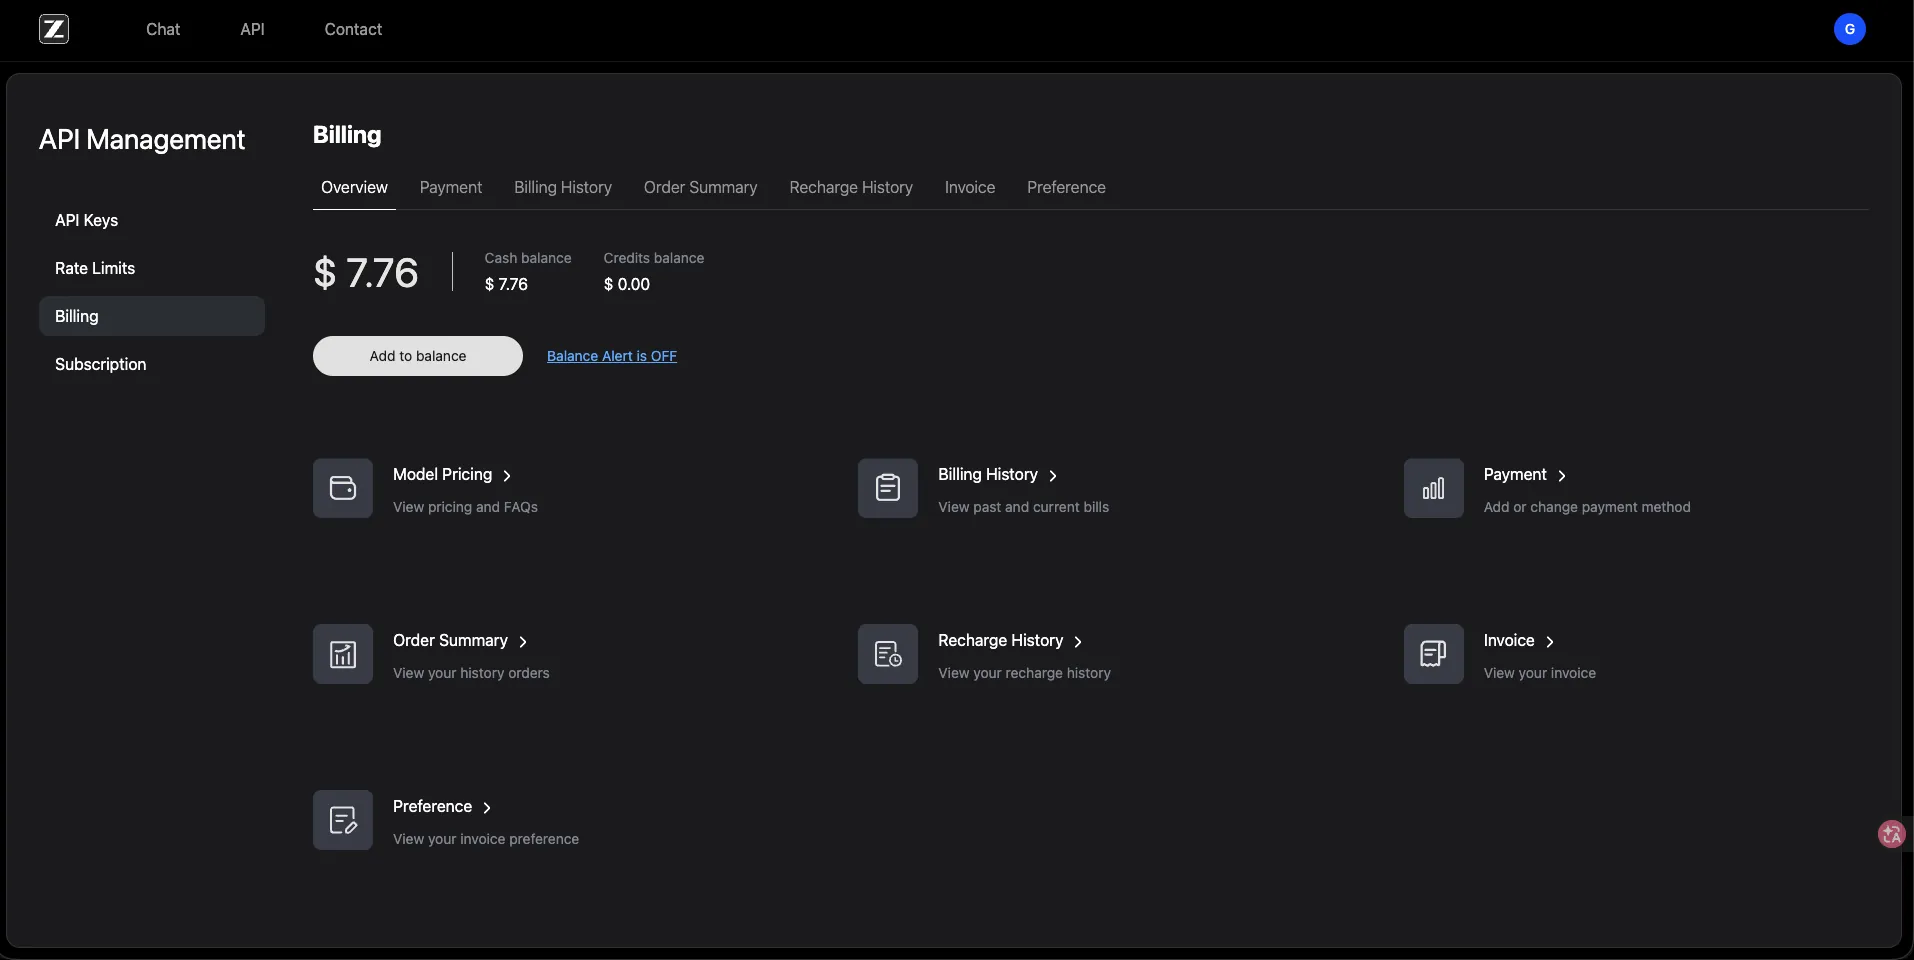
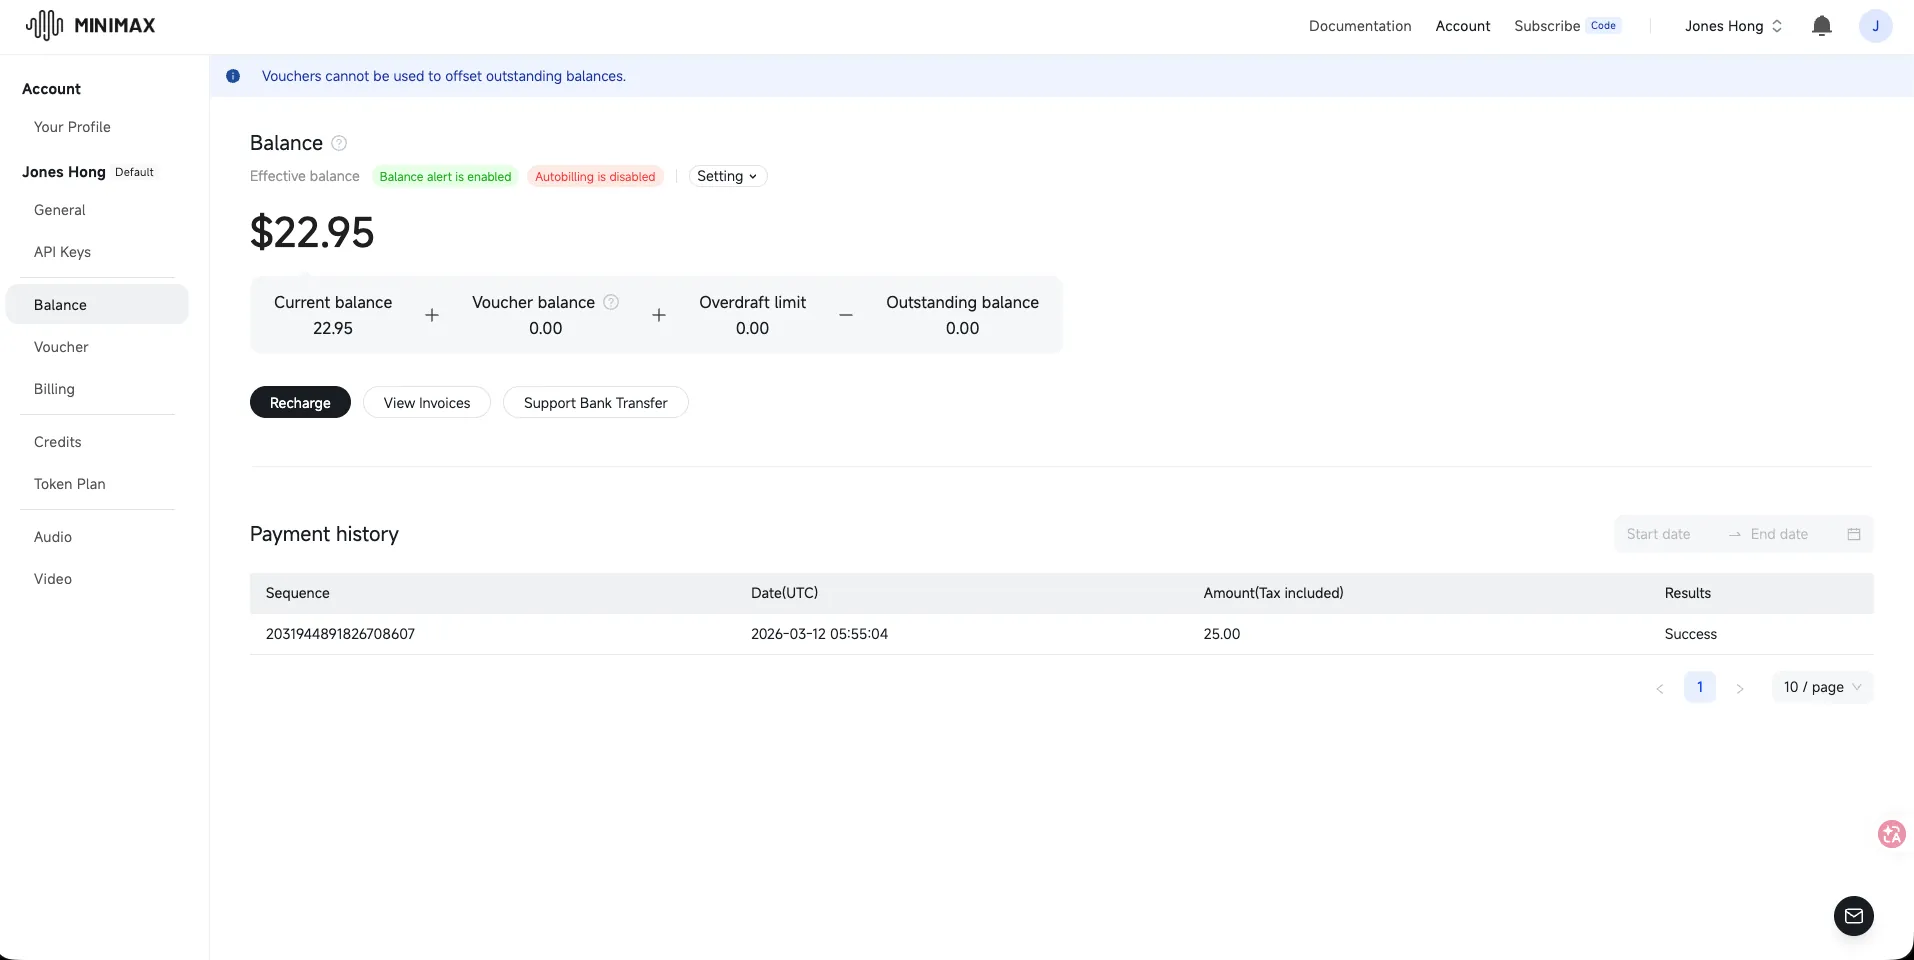
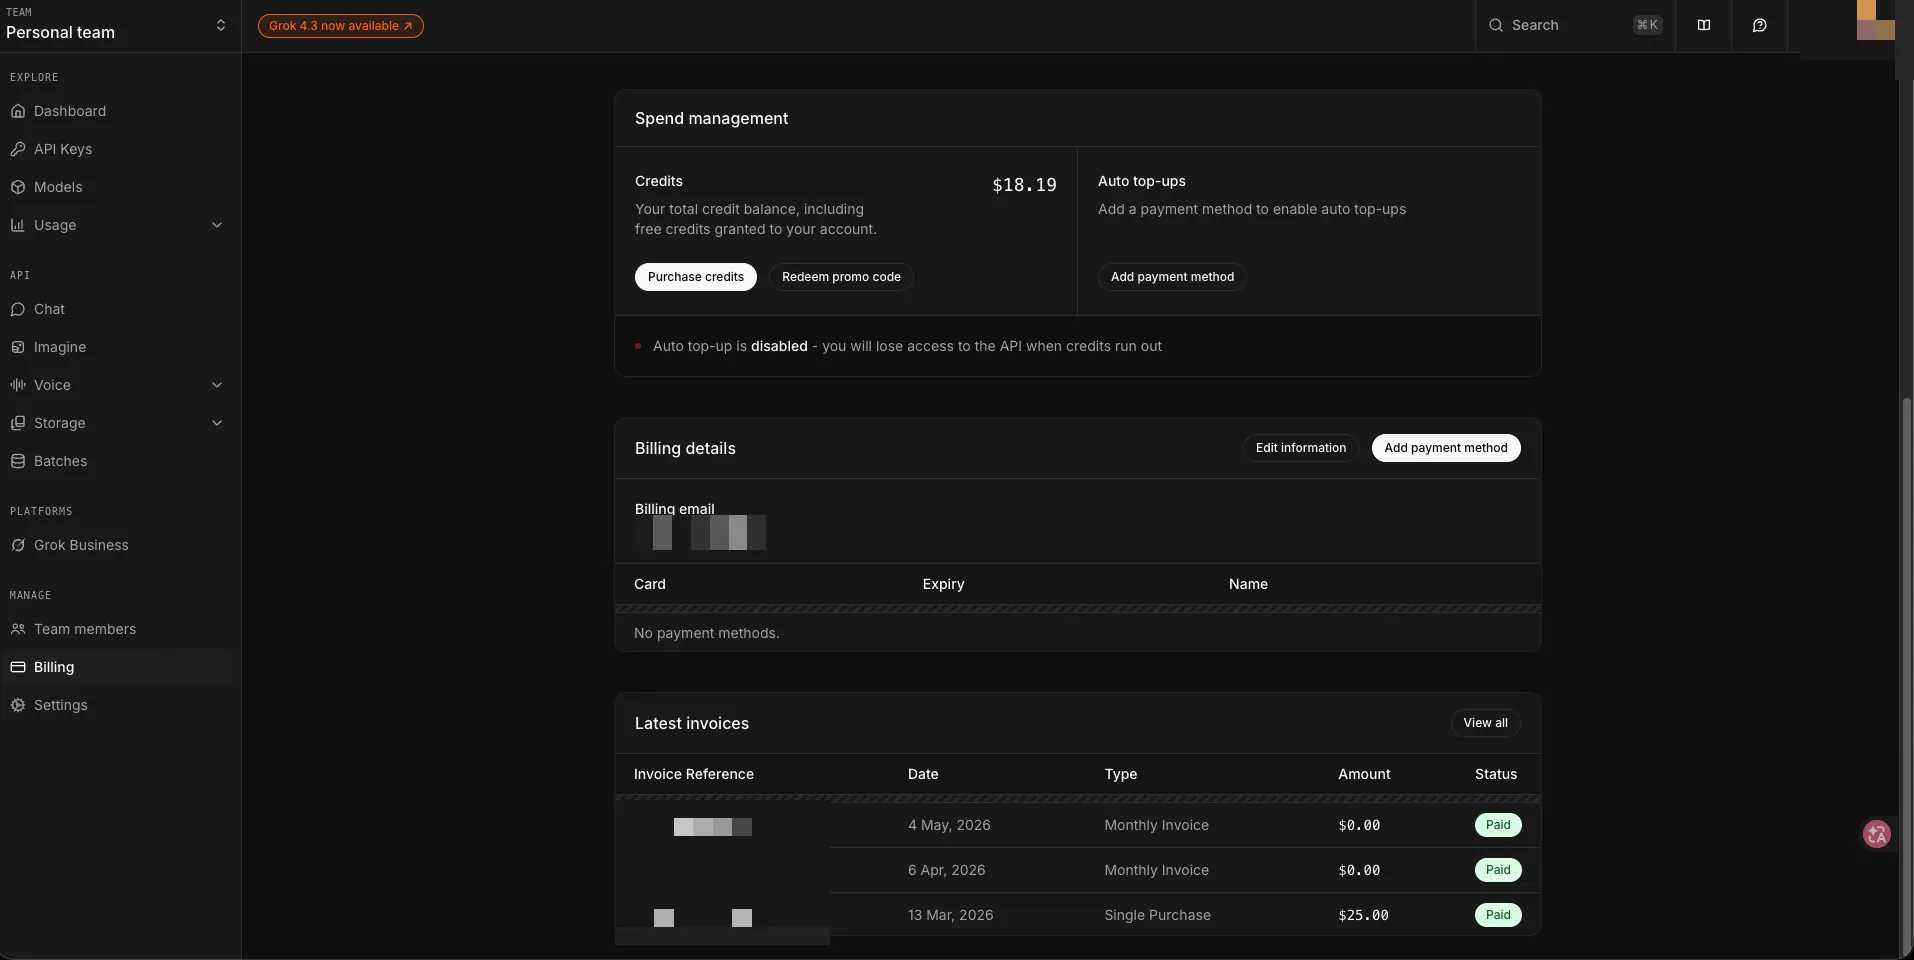
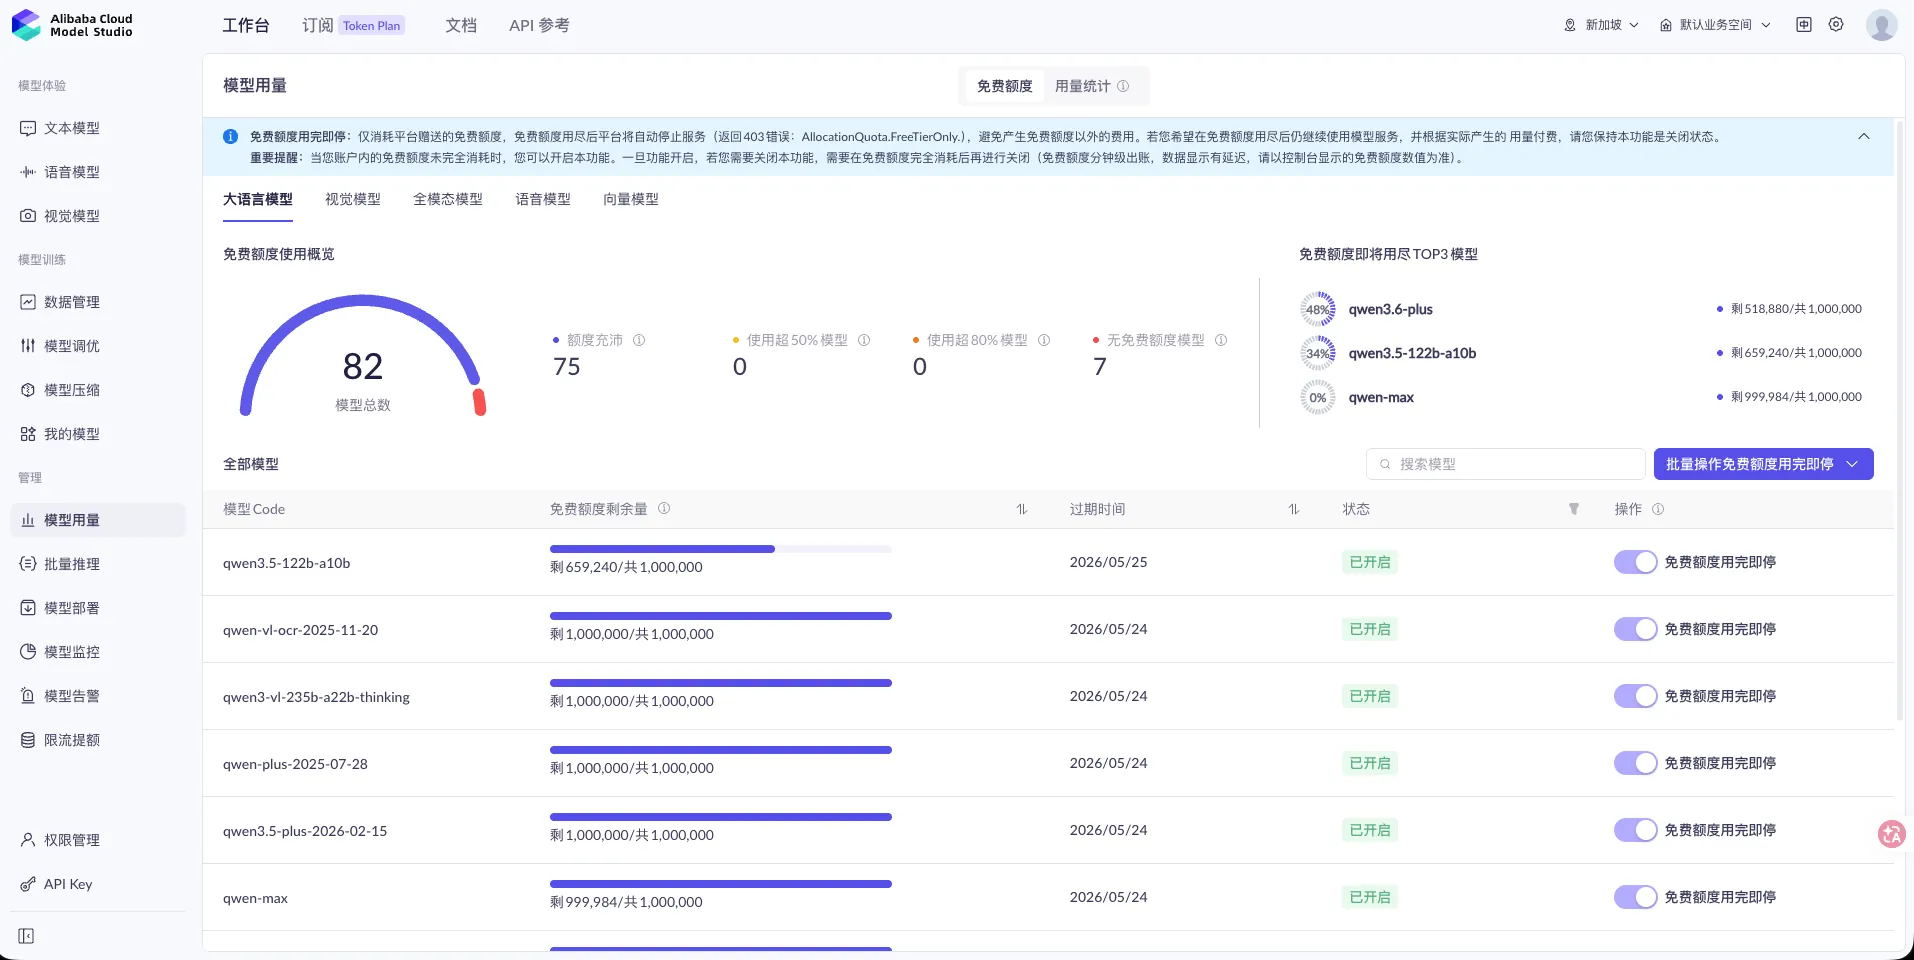
各社で設計思想が違います。『次のタスクをどこへ任せるか』という問いには、どの管理画面も単独では答えられません。六つのタブを開いて手で比較するか、自分でまとめるしかありません。
そこで小さな監視ページを自作し、毎日決まった時刻に残高を取得するようにしました。view は三つあります。
利用枠 view――サブスクリプション型の利用枠(Claude 5h/7d/EX、Codex 5h/7d、Gemini Pro/Flash 24h)と reset 時刻を一緒に表示します。
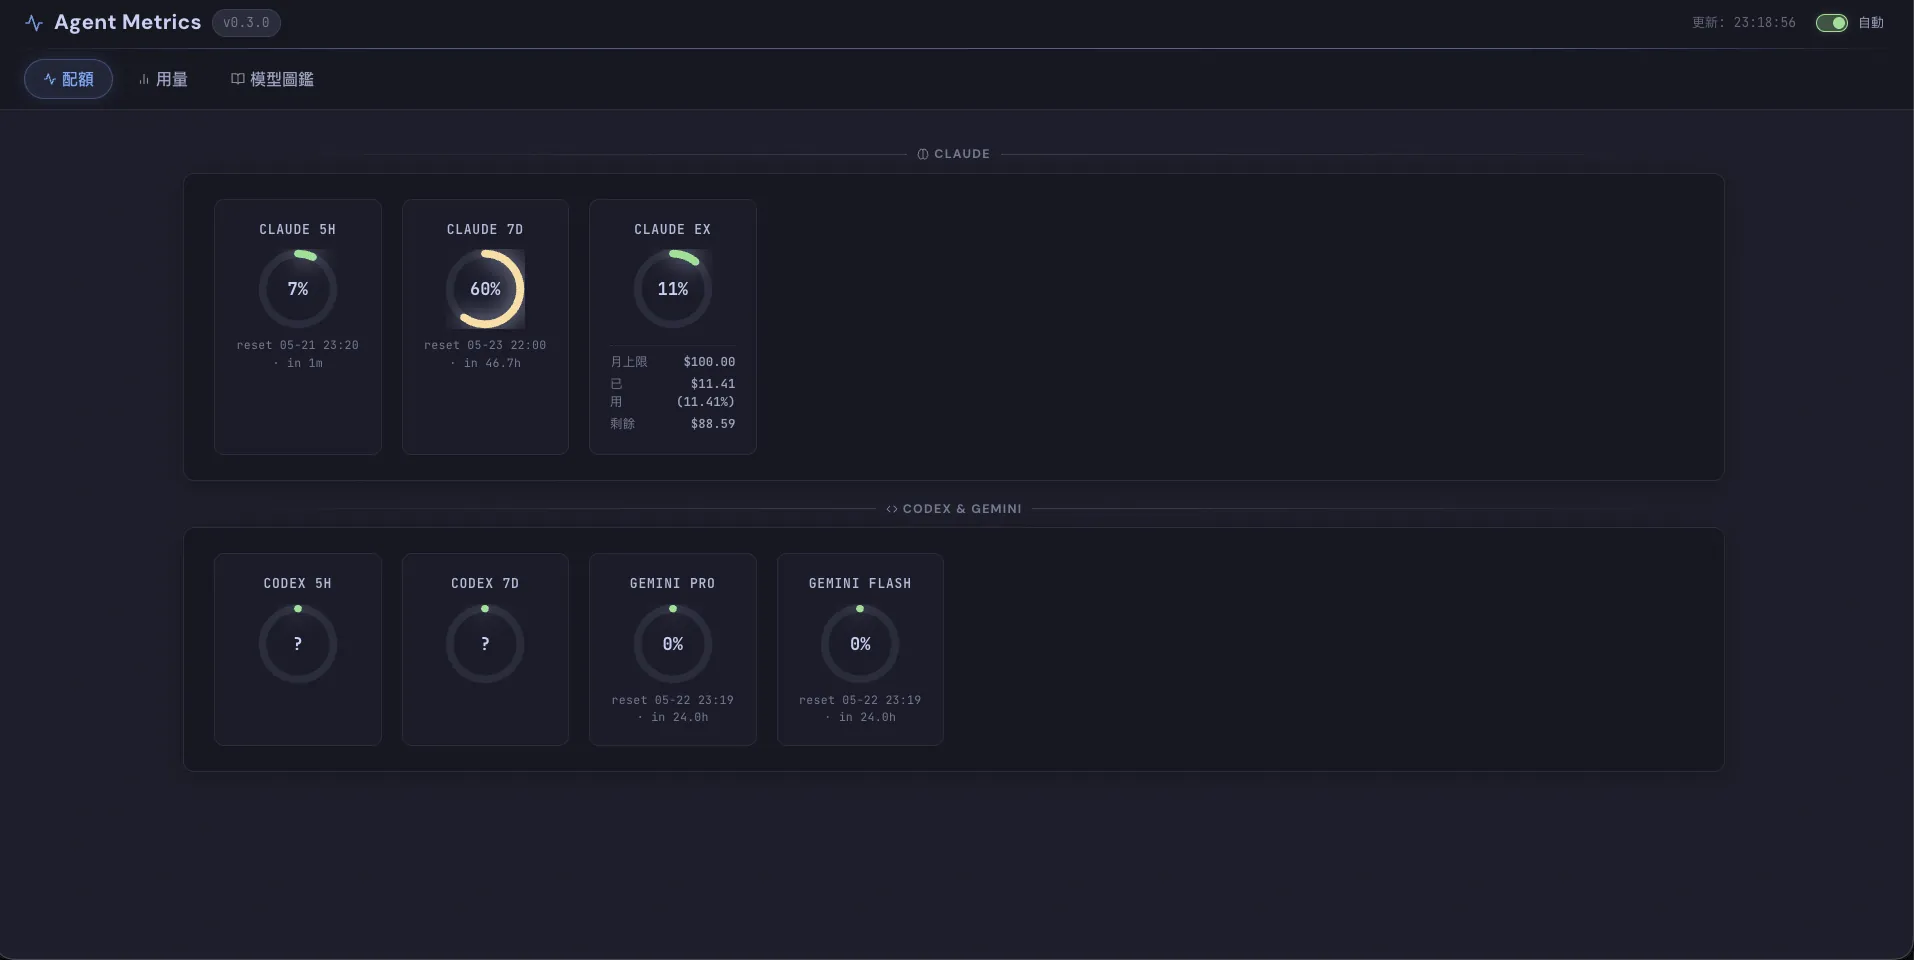
一目見れば分かります。Claude 5h はまだ 7% しか使っておらず(まもなく reset)、7d はすでに 60% を消費し(次の reset まで約二日)、EX の月上限 $100 は 11% しか使っていません。このまま続けるか、先に worker model を切り替えるかを利用枠 view で判断できます。
使用量 view――LiteLLM の前払い残高と、provider ごとのチャージ額 / 残高 / 使用済み額 / 使用率を同じ形式で並べます。
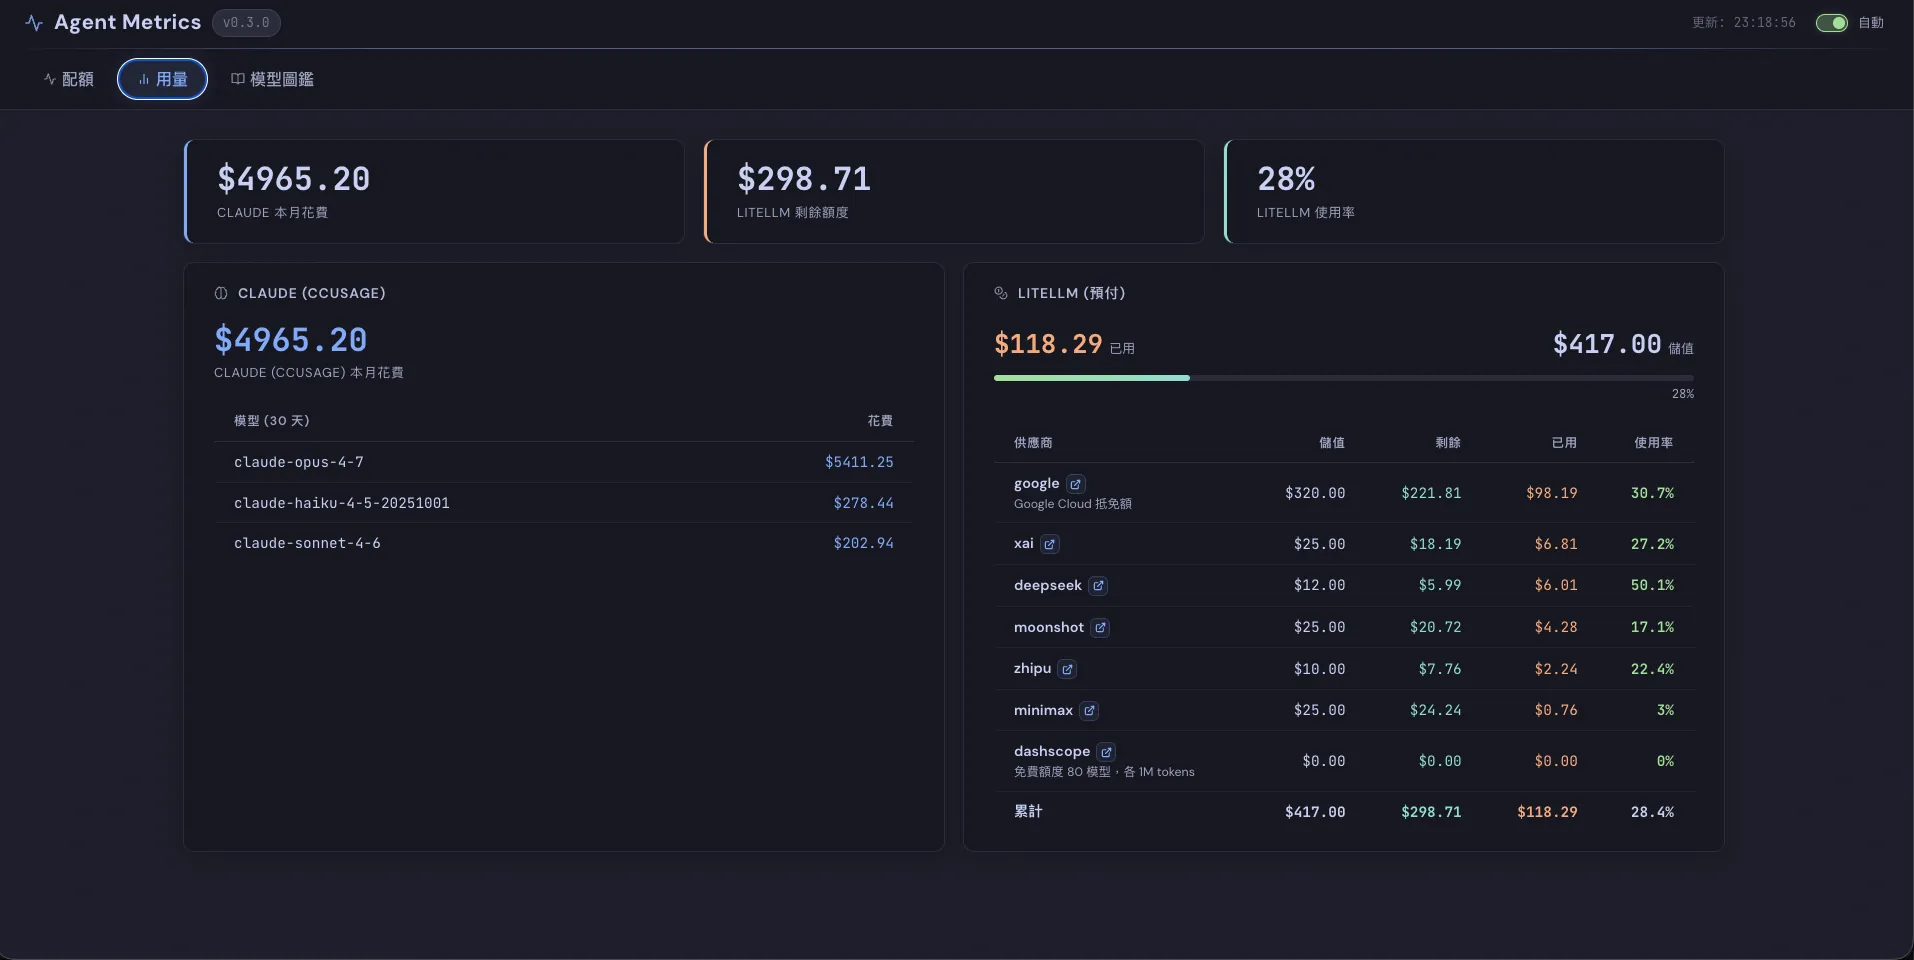
私が最も頻繁に見るのは使用量 view です。DeepSeek は 50% 使用済み、Moonshot はまだ 17%、MiniMax は 3%。つまり DeepSeek に batch task が集中しすぎています。次は一部を Moonshot や MiniMax に分散すれば、一つの provider の枠だけが先に尽きるのを避けられます。Google Cloud のクレジットもこのページに含めています(無料ですが、『残りが少ない』状態は追う必要があります)。
モデル図鑑 view――各社の旗艦 / Fast / Value モデルの一覧に、Arena / SWE-Bench / Speed に基づく用途別の推奨を添えます。
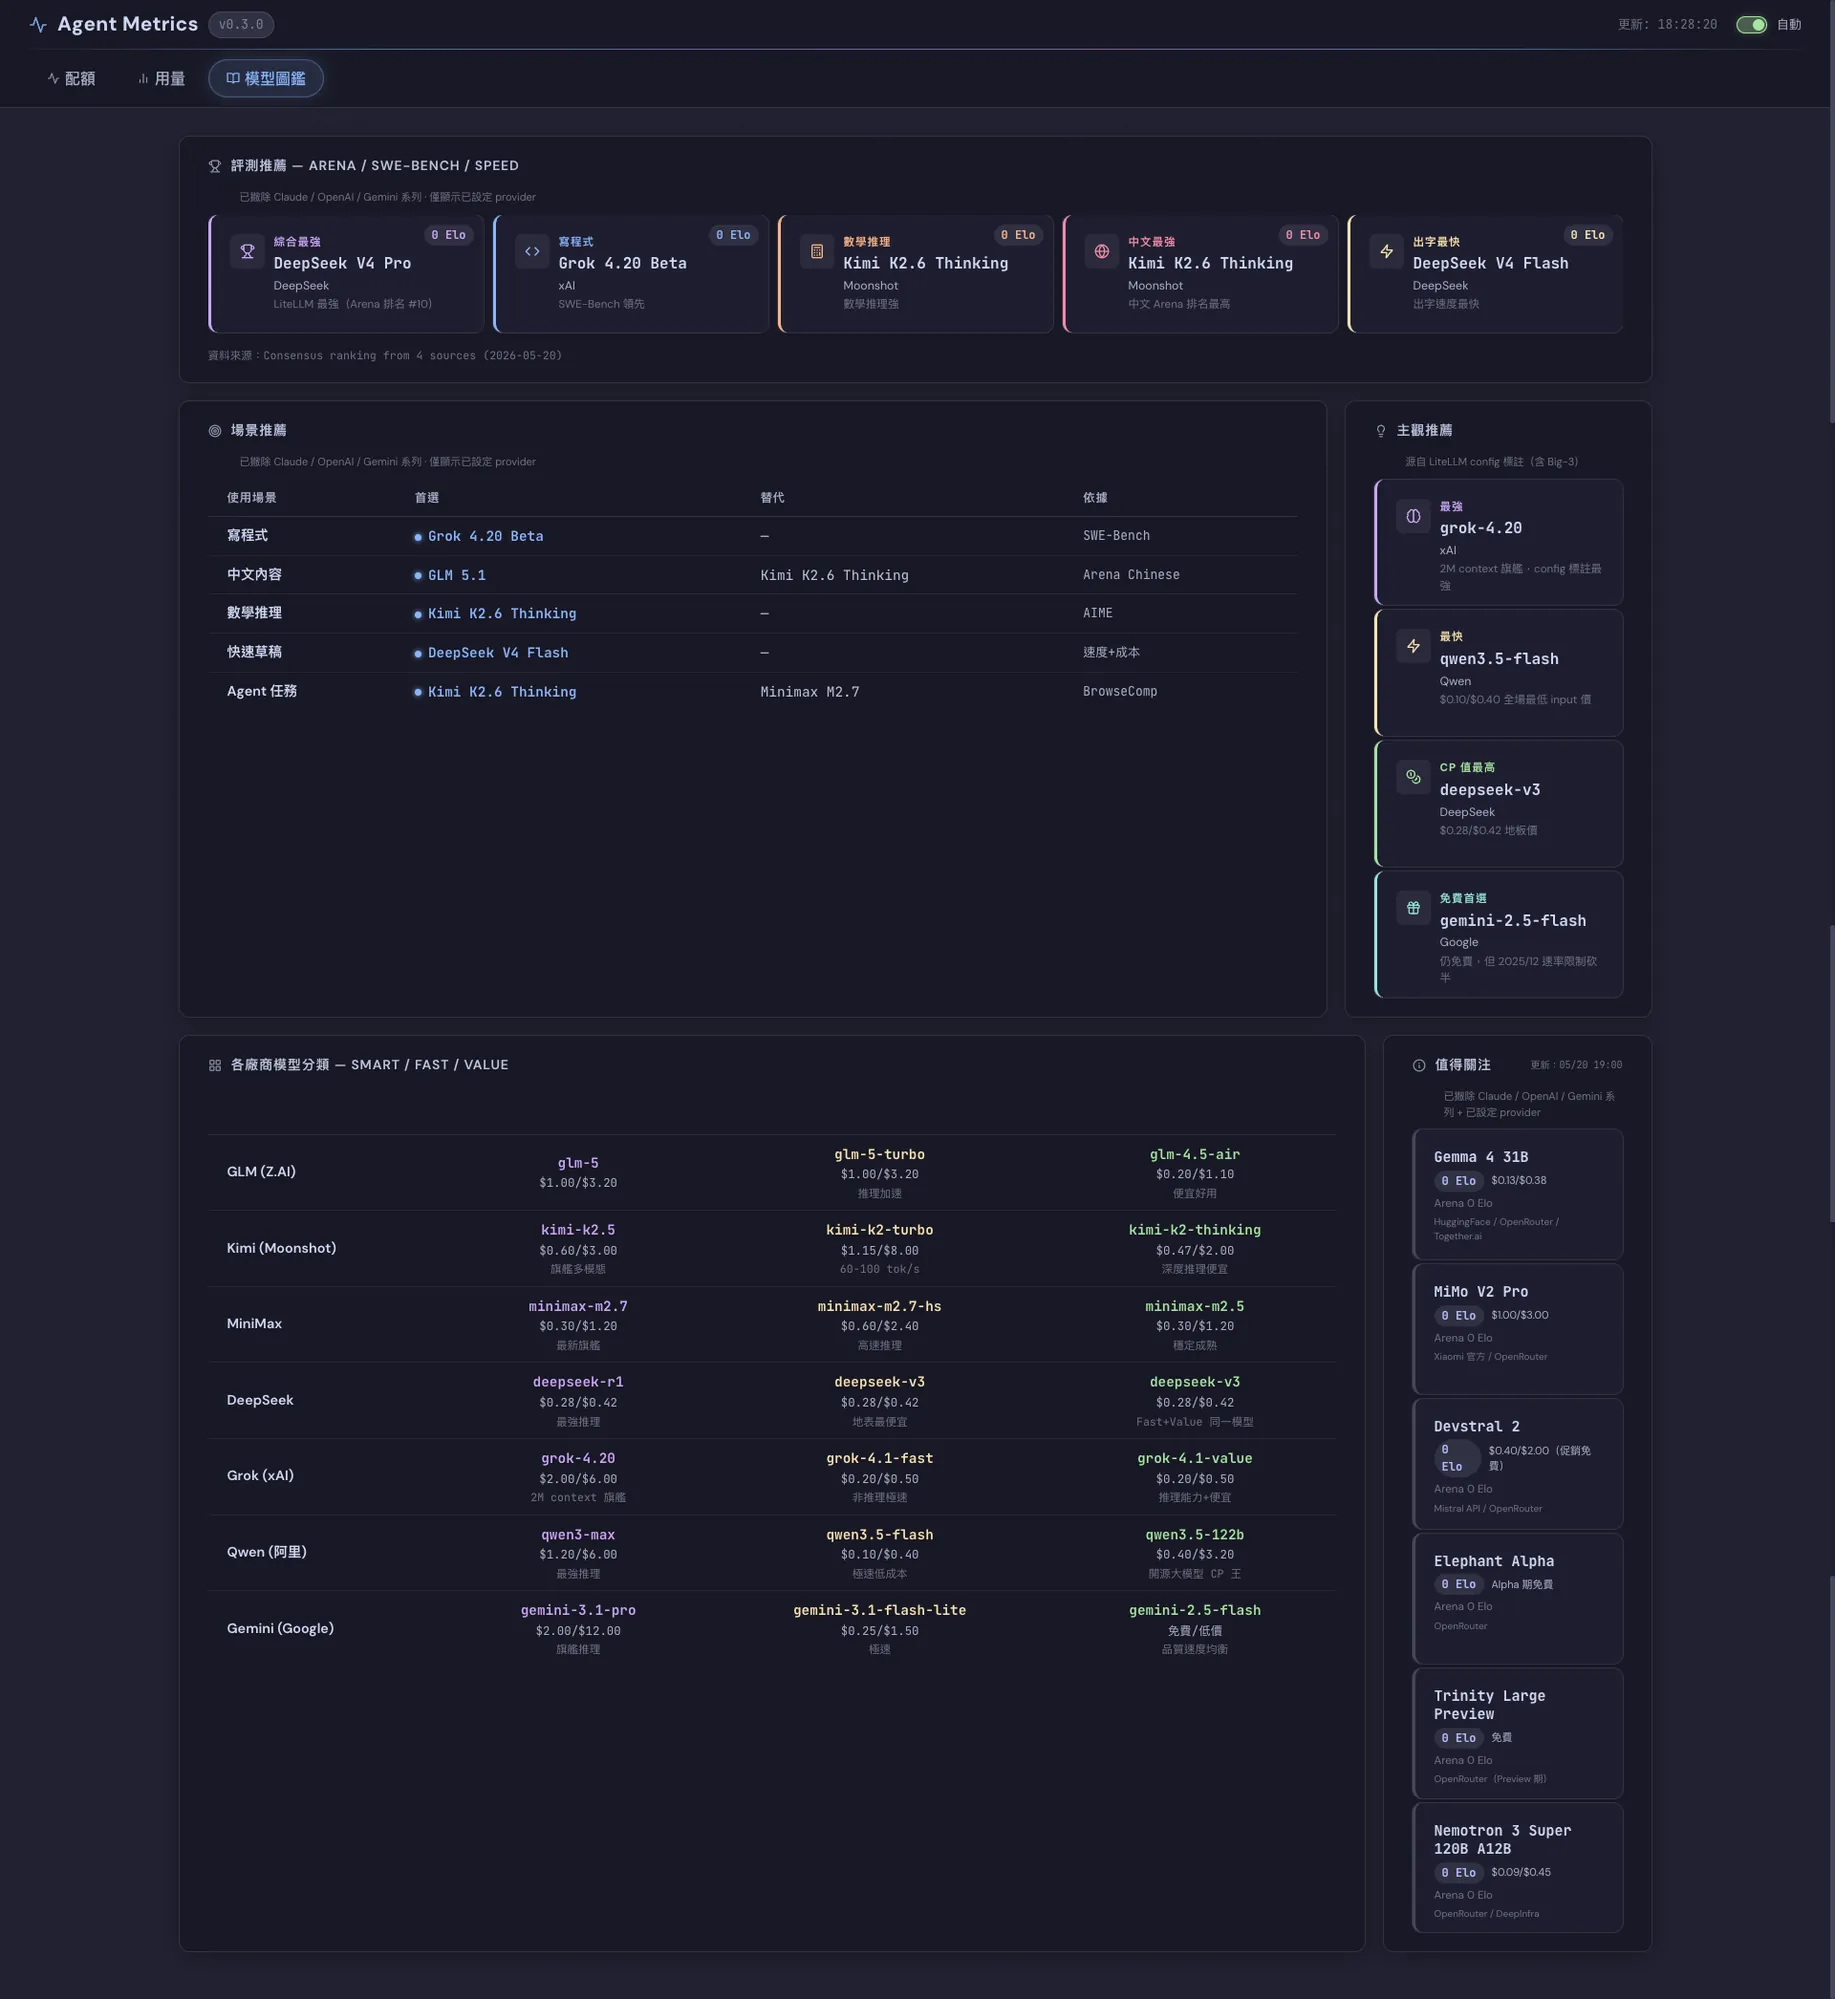
モデル図鑑は数日おきに更新します(Consensus ranking from 4 sources)。『今、どの model をどのタスクへルーティングするか』を決めるためです。2026-05-20 には数学的推論の第一候補を DeepSeek R1 から Kimi K2.6 Thinking に変更しました。変更後は LiteLLM config.yaml と CCR Router も同期して更新しました。
provider model list を照合して『古くなった設定』を検出する
クローラーには四つ目の役割もあります。各 provider の公式サイトから /v1/models endpoint を取得し、LiteLLM config.yaml に記載した model_name と照合します。失敗を経験してから追加した機能です。
以前、何度もありました。朝 Claude Code で仕事を始めると、CCR :3456 が 404 model not found を返します。調べてみると、ある provider が xxx-preview を xxx-stableに改名していたり、旧版の v3.1 を廃止して v3.2に置き換えていたりします。LiteLLM config.yaml には古い名前が残っていて、ルート全体が途切れます。最先端モデルの入れ替わりは想像以上に速く、DeepSeek、Moonshot、Qwen では一、二週間で model code が変わることもあり、新旧の名前に後方互換性がない場合も少なくありません。
照合の仕組みは単純です。
dashboard では stale を赤、new を緑で表示します。『config のどの項目が無効になり削除すべきか / 新たに何を評価できるか』が一目で分かります。この check を事後の debug から事前の警告に変えてからは、『起動して初めて model 404 に気づく』ことがなくなりました。
バックエンドは毎日一回動くクローラー、フロントエンドは自作の小さな単一ページです。技術を見せるために作ったのではありません。既存のツールにはこの情報をまとめたものがなく、見たければ自分で作るしかなかったからです。
向いている人、向いていない人
利点は三つです。三層分担で利用枠を重要なところに使えること、他社モデルの実際の実力が分かること、一つの provider が止まってもワークフロー全体は止まらないことです。
- 三層分担で ROI を合わせる――計画には最も賢い model を残し、worker のバッチ処理には $0.2/$0.5 級を使い、二つの model で検証します。同じ利用枠が数日長く持ち、品質も一つの model だけで最初から最後まで進めるより安定します。
- 『ほかのモデルも知る』のは bonus――しばらく試すうちに、どの provider がどのタスクを得意とするか、自分の経験としてつかめました。人の benchmark 図だけを見て判断せずに済みます。モデル図鑑のページも、その経験を積み重ねたものです。
- 一つの provider が止まっても全体は止まらない――今朝の Codex のようにロックされると、検証は一つのモデルだけに縮小しますが、Claude Code と LiteLLM の二つの経路は動き続けます。
代償も三つあります。CCR と LiteLLM という二つの daemon を追加で保守し、provider ごとの癖を自分で把握し、どのタスクにどの model を割り当てるかも自分で決めなければなりません。
- CCR と LiteLLM の二つの daemon の保守が増える。CCR の更新では transformer schema が変わり、LiteLLM 1.55+ では spend tracking のフィールドが変わりました。そのたびに半日ほど debug することになります。
- provider ごとの癖を自分で把握する――Moonshot はときどき遅延が急増し、DashScope はたまに 5xx を返し、xAI では応答形式が何度か変わりました。fallback chain を適切に設定していないと、これらにぶつかります。
- 『どの task をどの model で実行するか』は誰も決めてくれない――考えることが一つ増えます。経験に頼るか、モデル図鑑のような補助ツールを使うしかありません。
したがって、この構成が向いているのは、20x のサブスクリプションでは本当に足りず、週末を一つ使って構成を整える気がある人です。20x で快適に使えている、あるいはローカルの daemon を二つも増やしたくないなら、現状のままが最も楽です。この構成の代償が利点を上回ります。
私がこの構成を使い続ける理由は一つです。『同じタスクを別の model で動かすと何が起きるのか』という好奇心がまだ消えておらず、役割分担によって利用枠への負担も実際に減ったからです。利用枠が尽きても、サブスクリプションを上げるのではなく、どの層で消費しているかを考えるようになります。『限られた資源に考えることを促される』この感覚が、むしろ一番気に入っています。
このタスクはどの層に任せるべきか
上で示した CCR の Router 設定は四つの枠しかありませんが、実際のタスクは四種類に収まりません。手元のタスクの特徴を選ぶと、この記事の『計画 / worker / 検証』の定義に沿って層を判定し、その層について本文に書いた文を表示します。層と Router の四つの枠は別々の軸です。本文の config.json 枠に当てはまればその model を表示し、当てはまらなければ『見つからない』と表示します。この記事では計画と検証を Claude Code 側に残しているため、Router の四枠には対応する場所がありません。すべてブラウザー内で動き、API key の入力は不要で、データは一切送信されません。
定数の出典はすべて本文にあります。三層の定義は『三層の役割分担』節の三枚のカードからそのまま取り、Router の四枠と longContextThreshold: 60000 は本文に載せた CCR config.jsonから取り、コマンド形式は本文の cc-llm zsh function から取りました。『バッチ数 ≥ 2 のときだけ費用節約の項目を表示する』のは私が設定した表示基準で、本文に出てくる数値ではありません――この記事にある数値上の基準は 60000 だけです。model 名はこの記事の 2026-05 時点の表記であり、ここでの推奨値ではありません。
まず、どの層が利用枠を消費しているか把握する
三層分担の価値は『節約』よりも『適切な配分』にあります。最も高価な model には、その model が本当に担うべき仕事だけをさせます。導入前にまず AI に、あなたの利用枠がどの層で消費されているか計算してもらってください。
自分のワークフローと利用枠の状況を AI に伝え、三層に分ける価値があるか、どう段階的に移行するかを判断してもらいましょう。
関連資料
このワークフローの設計判断に実際に参考にした資料です。
| 資料 | 重要な理由 |
|---|---|
| claude-code-router | Anthropic ↔ OpenAI protocol transformer。これがなければ Claude Code から LiteLLM に接続できず、ルーティング全体の要となる中間層です。 |
| LiteLLM | 複数の provider を統合するゲートウェイ。この記事で紹介した構成全体の中心です。 |
| cc-switch | 試してから採用を見送った方法です。README を見れば、なぜ『複数の model を同時に並列実行する』用途に合わないかが分かります。設計上の前提は『マシン全体で一度に一つの provider』です。 |
| koc.com.tw の各 AI API 仲介サービス比較 | 仲介サービスの入門的な概観です。読んでから、私は仲介サービスを使わないと決めました。 |
| How to Test AI-Generated Code the Right Way in 2026 | 『テストの六つの鉄則』の最初のきっかけです。『100% coverage / 4% mutation score』という対比を知ってから、AI が書いたテストを無条件には信じられなくなりました。 |
| Salesforce VIBEPASS | benchmark によると、最先端の LLM でも自分のコードに潜む bug を見つける成功率は 50% 未満です。『検証層を小型モデルに任せない』ことを裏づける最も強い証拠です。 |
| tmux:汎用ステータスバー、画面分割、リモート接続から複数 agent の役割分担まで | この記事の『tmux の四分割 pane で異なる model を並列実行する』スクリーンショットの裏にあるツール群が、どうできたかを説明しています。まだ tmux で複数の agent CLI を動かしたことがなければ、この記事で基本的なレイアウトとステータスバーを紹介しています。 |