CCR + LiteLLM
Claude Code의 인터페이스는 그대로, 두뇌는 교체
Claude Code 20x 할당량이 약 나흘 만에 바닥납니다. 계획은 Claude Code에 맡기고, 작은 배치 작업은 LiteLLM의 저렴한 worker에 넘긴 뒤, Codex로 이중 검증합니다. 이 “모델은 바꾸고 인터페이스는 남기는” 워크플로를 통해 다른 회사 모델들이 실제 업무에서는 어느 정도인지도 살펴봅니다.
오늘 아침 그 Codex 명령
오늘 아침 Codex 검증 작업이 연결 단계에서 막혔습니다. 동료에게 물어보니 회사 OpenAI workspace 책임자 계정이 정지되면서 팀에서 쓰던 Codex를 포함한 workspace 전체가 멈췄다고 합니다. 이 일이 글을 쓰게 된 계기이지만, 글의 주제는 아닙니다.
그 Codex 명령을 몇 번 다시 시도해도 안 됐고, log를 연결하고서야 CLI 자체가 잠겼다는 사실을 확인했습니다. 이의 신청 메일은 보냈지만, OpenAI는 답변까지 최소 영업일 기준 3일이 걸리고 복구도 보장할 수 없다고 합니다. 당분간 검증 단계는 Claude Code 혼자 맡아야 합니다. LiteLLM의 작은 모델들도 있지만, 이 단계를 맡길 생각은 없습니다. 뒤의 “3단계 역할 분담”에서 이유를 설명하겠습니다.
이 글에서 실제로 다룰 내용은 최근 “Claude Code 20x 할당량도 쓰다 보니 부족하다”에서 출발해 “LiteLLM으로 다섯 회사의 공식 API를 연결하고, Claude Code가 계획을 세우고, 작은 모델이 worker를 맡고, 두 model이 검증하는” 워크플로에 이르기까지 시험한 과정입니다. 아울러 DeepSeek, Kimi, GLM, Grok, Qwen을 실제 업무에 투입했을 때의 수준도 되짚어 봅니다.
20x도 왜 부족할까요?
Claude Code 20x 구독 할당량으로 계획, 작성, debug, 검증을 전부 돌렸더니 약 나흘 만에 바닥났습니다. 직감적으로는 “한 단계 업그레이드해야 하나” 싶었지만, 20x가 이미 구독 플랜의 상한이라 그 이상은 API를 써야 합니다.
ccusage 기록을 다시 보니 문제는 단순히 “많이 쓴다”가 아니었습니다. “Opus로 돌릴 필요가 없는 작업까지 Opus로 돌리고 있다”는 게 문제였습니다. N개 파일에서 같은 import path를 바꾸거나, N개 markdown 문단을 영어로 번역하거나, N개 grep 결과를 정리하는 일 같은 배치형 기계 작업은 DeepSeek V3나 Qwen Flash로 돌려도 결과 차이는 무시할 만하면서 비용을 90% 절약할 수 있습니다.
이 기준으로 나눠 보니 자연스럽게 세 단계가 됐습니다.
이때부터 LiteLLM을 알아보기 시작했습니다. 한편으로는 저렴한 worker model을 찾아 두 번째 단계를 연결하고 싶었고, 다른 한편으로는 자주 거론되는 DeepSeek / Kimi / GLM / Grok / Qwen을 실제로 돌리면 어떨지 궁금했습니다.
3단계 역할 분담: 계획 / Worker / 이중 검증
계획은 Claude Code에 맡기고, worker는 LiteLLM의 작은 모델에 넘기며, 검증은 Claude Code와 Codex가 교차로 확인합니다. 이 3단계 역할 분담은 조금씩 시험하면서 만들어졌습니다.
두 model을 이용해 교차 검증합니다. Claude Code에 한 번 맡기고 “테스트 6대 원칙”에 따라 항목별로 점수를 매겨 위반 사항을 찾게 합니다(다음 절에서 규칙과 출처를 설명합니다). Codex에는 worktree의 git diff를 직접 넣어 한 번 더 검토하게 하고, 코드 관점에서 bug, 일관되지 않은 명명, 빠뜨린 경계 조건을 찾게 합니다.
두 model에는 각자의 사각지대가 있습니다. Claude Code는 “우리 집 규칙”에 익숙하지만 순수한 문법 오류나 경계 조건 오류를 감지하는 데에는 Codex보다 덜 민감합니다. Codex는 diff를 꼼꼼히 보지만 제 rules는 모릅니다. 함께 쓰면 서로의 사각지대를 메울 수 있습니다.
검증 단계를 LiteLLM의 작은 모델에 넘기지 않는 이유는 실제로 시험해 봤기 때문입니다. 작은 모델은 “worker가 스스로 발견하지 못한 문제 찾기”처럼 신중한 reasoning이 필요한 작업에서 적중률이 분명히 부족했습니다. 검토하는 것처럼 보이지만 정작 중요한 bug를 놓친 review를 자주 내놓았습니다. worker 작업은 작은 모델에 맡겨 배치로 돌릴 수 있지만, 검증 기준은 지금도 Claude Code와 Codex만 믿을 수 있습니다. 오늘 아침 Codex 쪽이 끊긴 뒤 검증은 Claude Code 혼자 버티는 상태가 됐습니다. 스스로 worker가 되고 스스로 검증하는 데에는 한계가 있지만, 단기적으로는 더 나은 선택지가 없습니다.
테스트 6대 원칙
이 여섯 가지는 한 번에 만든 것이 아니라 여러 차례 시행착오를 겪으며 쌓인 것입니다. 지금은 Claude Code가 worker의 결과물을 검증할 때 항목별로 점수를 매기는 기준입니다.
mutation thinking
테스트를 작성할 때는 먼저 “이 code의 어느 줄을 잘못 바꾸면 이 test가 실패할까”를 생각해야 합니다. 실패하지 않는다면 그 test는 장식일 뿐입니다.
코드 작성과 테스트 작성 분리
code를 작성한 agent가 그에 대응하는 test까지 직접 작성해서는 안 됩니다. 다른 agent를 열어 작성해야 합니다. 같은 머리로 자기를 검증하면 사각지대가 가장 커집니다.
불변 조건 우선
“기존 동작과 비교해 바뀌면 안 되는 것”이라는 불변 조건을 “내가 예상하는 결과”보다 우선해 테스트합니다. 예상은 틀릴 수 있지만 불변 조건은 더 단단합니다.
runtime → 회귀 테스트
테스트는 반드시 실제로 실행해야 합니다. import check나 type check로는 부족합니다. stack trace가 나올 수 있어야 의미가 있습니다.
출처와 발전 과정
처음 씨앗이 된 것은 두 글입니다.
| 출처 | 얻은 것 |
|---|---|
| How to Test AI-Generated Code the Right Way in 2026 (Katerina Tomislav, 2026-02) |
AI가 작성한 테스트의 가장 큰 문제로 “100% 줄 커버리지, 4% mutation score”를 지적합니다. 커버리지 수치는 좋아 보여도 bug의 96%를 놓친다는 겁니다. HumanEval-Java 연구 데이터를 인용합니다. |
| Salesforce VIBEPASS | 이 benchmark에 따르면, 최전선 LLM은 bug가 있다고 미리 알려주지 않았을 때 코드에서 숨은 bug를 찾아 고치는 성공률이 50% 미만입니다. 다시 말해 AI가 직접 쓴 테스트는 자기 코드의 문제를 잡아내지 못할 가능성이 큽니다. |
Katerina의 원문은 원래 네 가지 방향을 제시했습니다. mutation testing, AI-aware code review, CI pipeline validation, prompt engineering입니다. 읽고 나서 첫 번째인 mutation testing부터 적용했고, 직접 겪은 시행착오를 바탕으로 몇 가지를 더했습니다.
- 첫 번째로 “코드 작성과 테스트 작성 분리”를 추가했습니다—직접 작성한 테스트 27개가 모두 통과했지만, 구현을 보여주지 않은 독립 sub-agent에게 테스트 작성을 다시 맡기자 실제 bug 2개를 바로 찾아냈습니다.
- 두 번째로 “불변 조건 우선”을 추가했습니다—고정된 I/O pair는 같은 말을 되풀이하는 것에 불과하며, invariant만이 구현에서 독립적입니다.
- 세 번째로 “runtime → 회귀 테스트”와 “mock은 외부 I/O 경계에만”을 추가했습니다—두 원칙 모두 mock으로 감춘 bug가 “테스트 완료”로 처리됐다가 production에서 터지는 일을 겪고 만들었습니다.
- 마지막으로 “초안은 완성품이 아닙니다”를 추가했습니다—Salesforce VIBEPASS의 결론 때문입니다. AI가 직접 작성한 테스트를 맹신해서는 안 되며 commit 전에 반드시 다시 검토해야 합니다.
이렇게 해서 여섯 가지가 됐습니다. 검증 프롬프트의 system prompt에 이 여섯 가지를 넣고 Claude Code가 worker가 제출한 diff + tests를 항목별로 확인하도록 합니다. 어떤 원칙을 왜 위반했는지, 어떻게 고칠지 모두 나열하게 합니다. Codex 쪽에는 이 여섯 가지를 적용하지 않으므로 “순수한 코드의 bug와 규칙”이라는 독립적인 관점에서 검토합니다. 그래서 하나의 model을 두 번 돌리는 것보다 두 model을 함께 쓰는 편이 더 유용합니다.
왜 OpenRouter가 아니라 다섯 회사의 공식 계정인가
worker를 누구에게 맡길지 고민한 끝에 다섯 회사의 직접 계정을 선택하고 OpenRouter 처럼 SDK 하나와 결제 경로 하나로 모든 model을 연결하는 aggregator는 포기했습니다.
처음에는 koc.com.tw의 공급자 비교 글을 보고 중개 서비스를 쓰는 방향이 맞을지도 모른다고 생각했지만, 실제로 계산해 보니 감점 요인이 네 가지였습니다.
- 추가 요금 때문에 공식 promo 혜택이 사라집니다. 중개 서비스의 5%-20% 추가 요금은 크지 않아 보여도 각 회사의 공식 행사, 신규 사용자 할당량, 기간 한정 할인은 전부 받을 수 없습니다.
- 공식 사이트 전용 할당량을 받을 수 없습니다. DeepSeek, Qwen, Moonshot 모두 신규 사용자나 행사에 무료 token을 제공한 적이 있으며, 직접 계정이 있어야 받을 수 있습니다.
- 결제 경로가 블랙박스라 debug가 어렵습니다. 오류가 나면 중개 서비스의 routing 문제인지 upstream provider의 장애인지 구분하기 어렵습니다.
- prompt / response 가공 여부가 불확실합니다. 중개 서비스가 system prompt, tool schema, stream chunking을 바꾸지는 않을까요? 각 회사 모델의 원래 성능을 평가하는 데에는 잡음입니다. 애초에 직접 성능을 확인하고 싶다는 호기심도 있었기에 이 점 때문에 중개 서비스 방식을 포기했습니다.
결국 선택한 다섯 회사의 직접 계정은 다음과 같습니다.
| Provider | 용도 |
|---|---|
| Moonshot(Kimi) | Agent 작업, 심층 추론(Kimi K2-Thinking이 BrowseComp / AIME에서 선두) |
| Z.AI(GLM) | 중국어 장문(Arena Chinese 순위 최고) |
| DeepSeek | 가성비가 가장 좋은 주력 worker($0.28/$0.42 기본 백그라운드 작업) |
| xAI(Grok) | 코딩 + 2M context 플래그십(SWE-Bench 선두) |
| 알리바바(Qwen via DashScope) | 초고속 저비용(qwen3.5-flash $0.10/$0.40으로 전체에서 input 가격이 가장 낮음) |
나중에는 fallback chain을 더 깊게 만들고 싶어 MiniMax와 Google Gemini도 추가했습니다.
Google Developer Program 크레딧
제가 Google Developer Program 에 가입한 뒤 Premium tier에서 매달 $10 monthly Gen AI & Cloud credits 크레딧을 지급합니다(일회성 크레딧, 유효기간 1년). AI Studio와 Vertex AI의 Gemini API 사용량에 바로 적용할 수 있습니다.
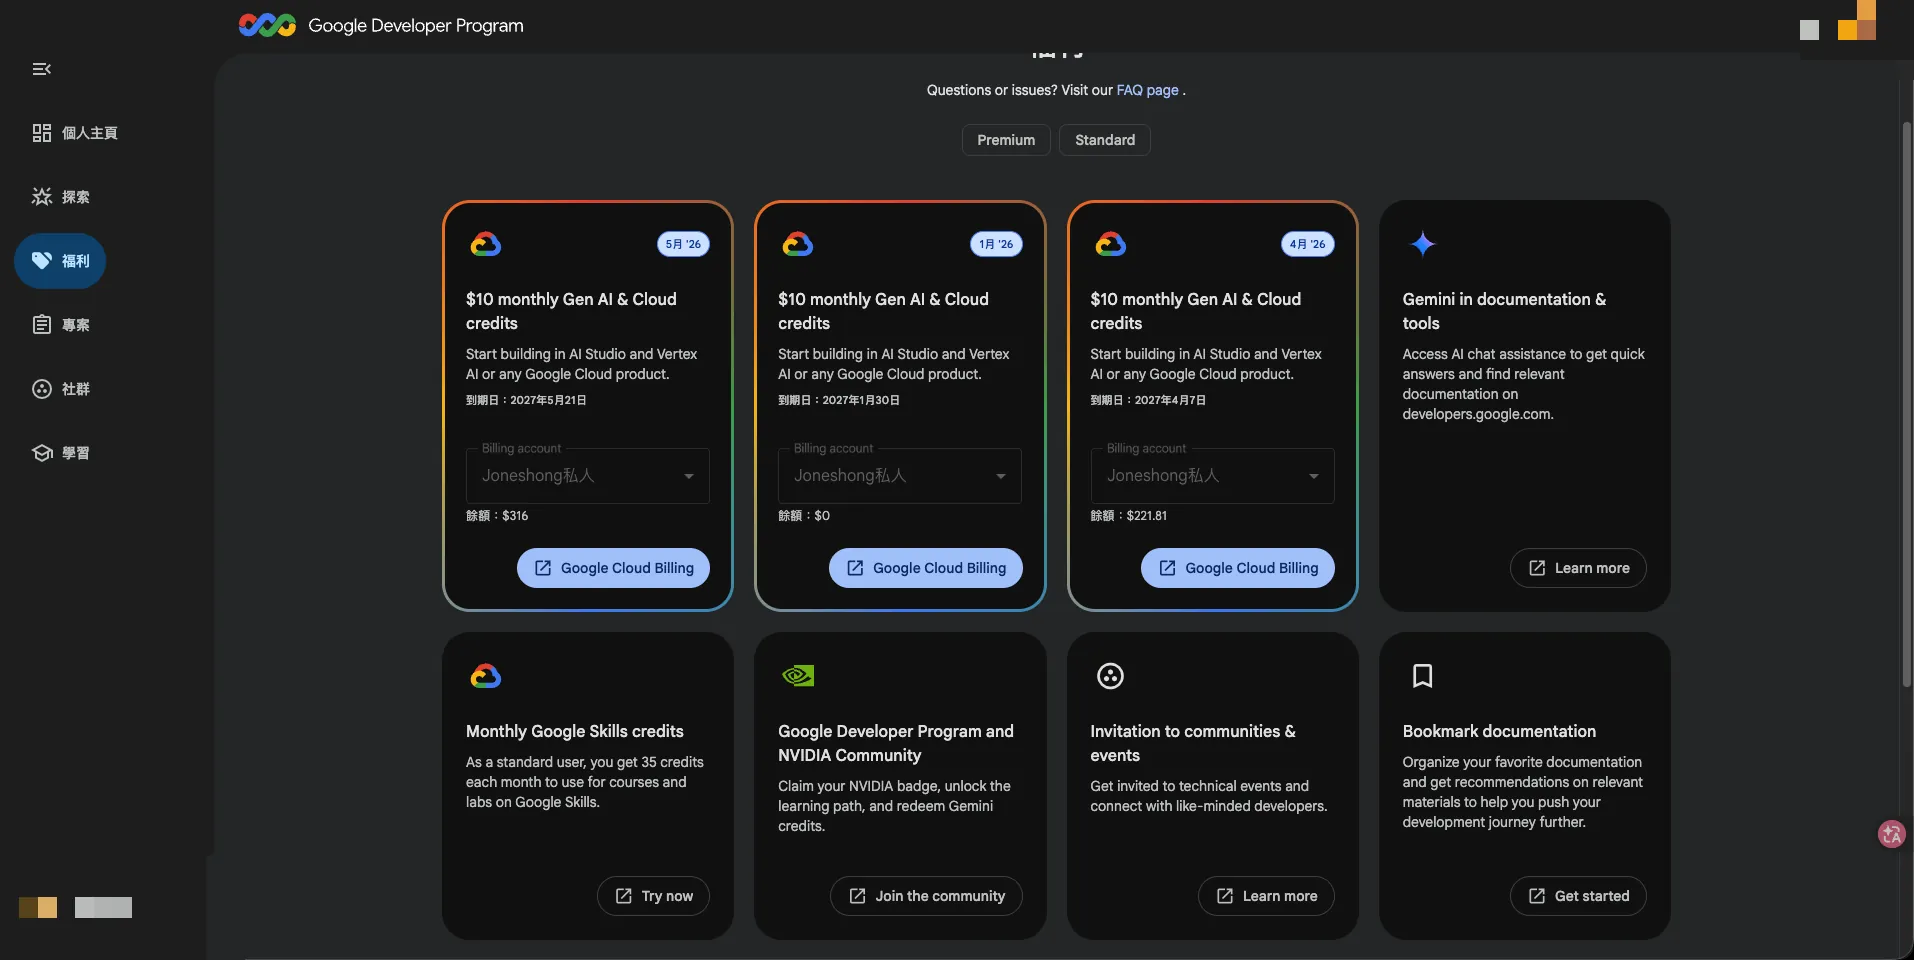
Google Developer Program 크레딧은 Google Cloud Billing 관리 화면에서 발급 내역을 확인할 수 있습니다. 각 크레딧의 액면가는 $315-$320으로 다르고, 월별 합계가 $300+여서 Gemini API에 사용할 수 있습니다.
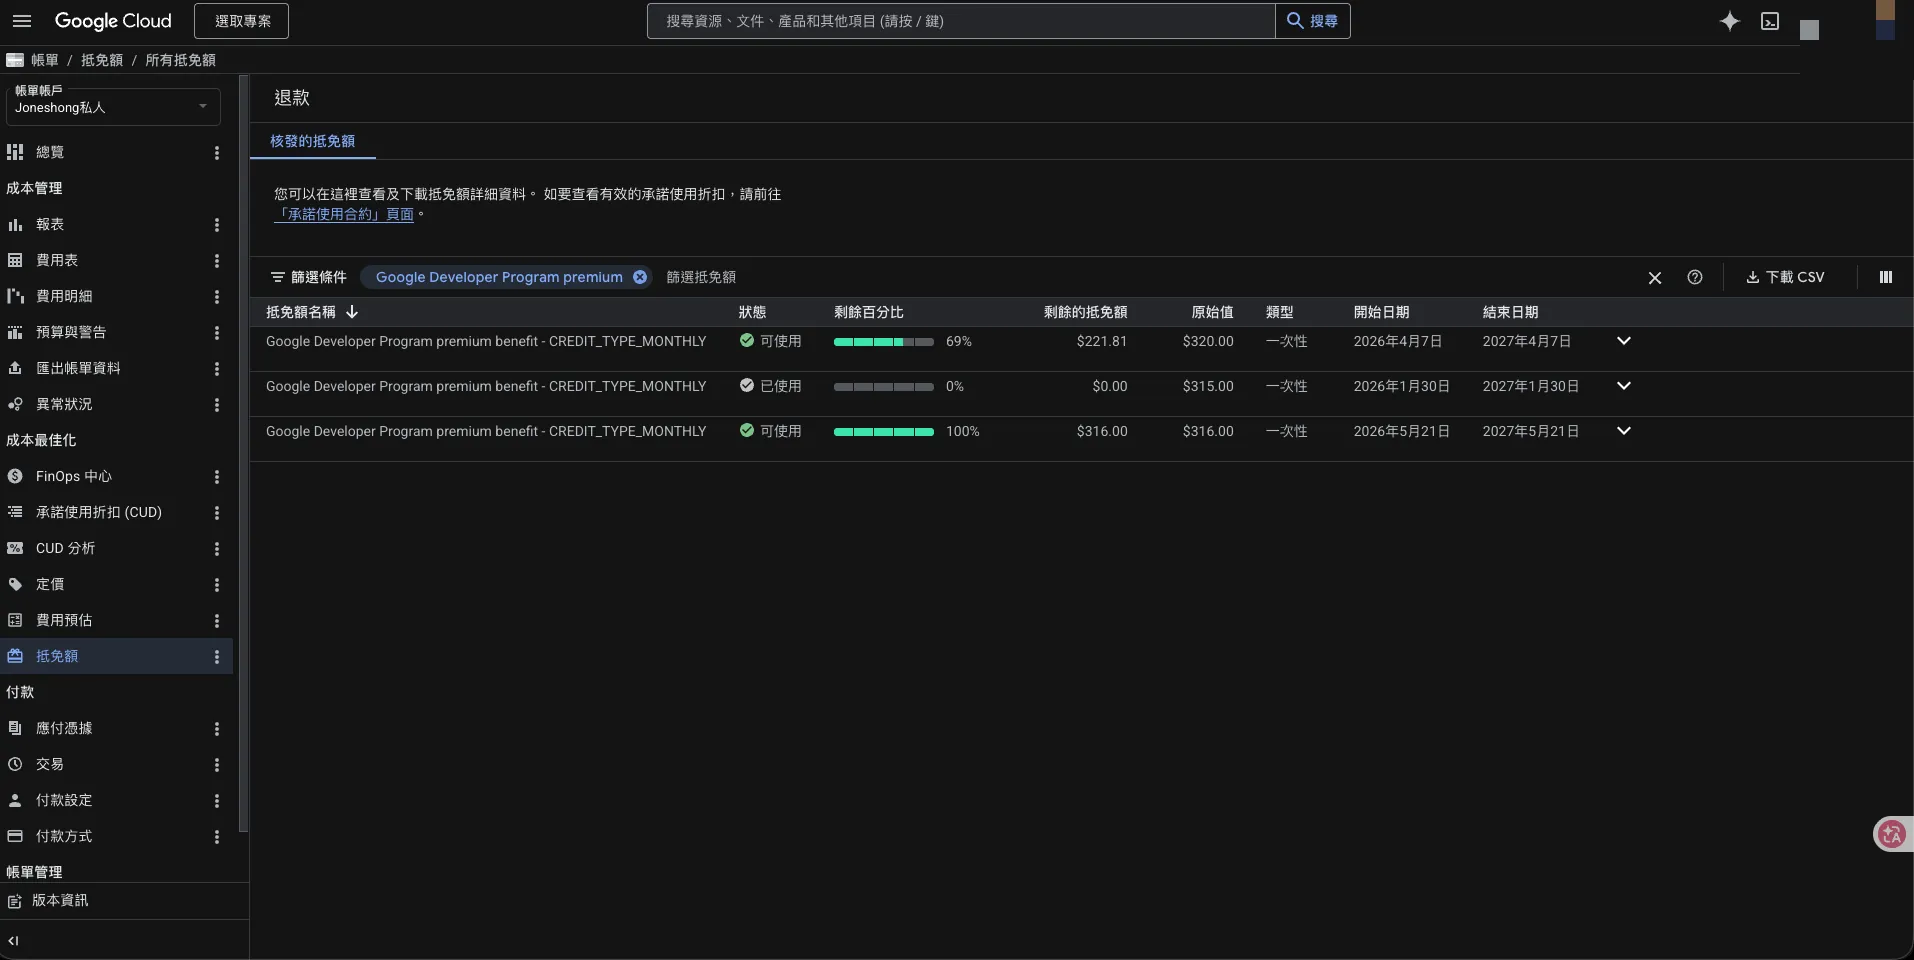
다시 말해 Gemini를 LiteLLM에 연결하면 이 게이트웨이에 “무료 model” 항목이 자동으로 생깁니다. 할당량이 바닥났을 때 gemini-2.5-flash 로 worker를 돌려도 비용이 아깝지 않습니다. “공식 사이트에서 직접 구매”하는 방식의 추가 혜택이며 OpenRouter로는 받을 수 없습니다.
왜 인터페이스로 CCR을 선택했나: Claude Code를 계속 쓰고 싶어서
최근 Claude Code, Codex, Gemini CLI, Copilot CLI 같은 주요 CLI agent를 모두 시험해 봤습니다. 결론은 여전히 Claude Code가 가장 손에 익는다는 겁니다. tool use 설계, subagent 구조, skill / slash command 체계, git worktree와의 조합, context 관리, permission flow가 전반적으로 한발 앞섭니다. 시험한 목록은 다음과 같습니다.
다른 model도 돌리고 싶다면 가장 좋은 방법은 “모델은 바꾸고 인터페이스는 남기는 것”입니다.
처음에는 사실 “LiteLLM + zsh function 하나”면 될 줄 알았습니다. Claude Code의 ANTHROPIC_BASE_URL 을 LiteLLM으로 지정하고 :4000request body를 직접 바꾸면 되겠다고 생각했습니다. 그런데 실제로 작성해 보니 각 회사의 프로토콜 세부 사항이 크게 달랐습니다. Anthropic의 messages API와 OpenAI chat/completions 는 system message, tool definition, stream chunking, reasoning content block 형식이 모두 달랐습니다. 어느 한 곳이라도 맞지 않으면 400 오류가 나거나 메시지가 조용히 사라졌습니다. 반나절쯤 transformer를 작성하다가 직접 만들 일이 아니라는 걸 깨달았고, 그때 claude-code-router(줄여서 CCR)라는 기존 transformer를 찾았습니다.
CCR은 로컬에서 :3456 서버를 실행합니다. Claude Code에는 Anthropic API처럼 보이고, 하위 단계에는 요청을 OpenAI 프로토콜로 transform해 LiteLLM에 보냅니다. Claude Code 입장에서는 Anthropic과 대화한다고 “생각”하지만 실제 요청은 DeepSeek, Kimi, Grok으로 라우팅됩니다. CCR 덕분에 Claude Code 인터페이스에서 LiteLLM의 모든 model을 돌릴 수 있습니다. 인터페이스를 바꾸거나 익숙한 사용법을 다시 배울 필요가 없고, subagent / skill 체계도 그대로 이어집니다.
왜 cc-switch를 쓰지 않았나
도중에 cc-switch 라는 커뮤니티 도구도 사용해 봤습니다. Claude Code provider를 한 번에 바꿔 주니 제 필요에 딱 맞아 보였습니다. 하지만 설치 후 살펴보니 전환 방식이 ~/.claude/settings.json:
~/.claude/settings.json를 직접 바꾸는 것이었습니다. 이 파일은 Claude Code의 전역 단일 파일입니다. 한 번 전환하면 컴퓨터의 모든 Claude Code session이 함께 바뀝니다.- 제 워크플로는 tmux의 여러 pane을 병렬로 돌리는 데 크게 의존합니다. 한 pane에서는 Kimi로 계획을 세우고, 다른 pane에서는 DeepSeek worker를 돌리고, 또 다른 pane에서는 Grok으로 긴 context를 처리합니다. cc-switch로 한 번 전환하면 세 pane이 모두 같은 회사로 바뀌고, 다시 전환하면 모두 다른 회사로 바뀌니 “서로 다른 model을 병렬 실행”할 수 없습니다.
CCR + ENV var 방식은 반대로 작동합니다.ANTHROPIC_BASE_URL 와 ANTHROPIC_MODEL 는 프로세스별 환경 변수입니다. tmux pane마다 독립된 shell이어서 서로 간섭하지 않습니다. 다음 절의 cc-llm 도 이 원리를 이용합니다.
실제로는 다음과 같습니다. tmux window 하나를 세로로 네 칸 나누고, 각 칸에서 Claude Code가 서로 다른 model을 호출합니다.
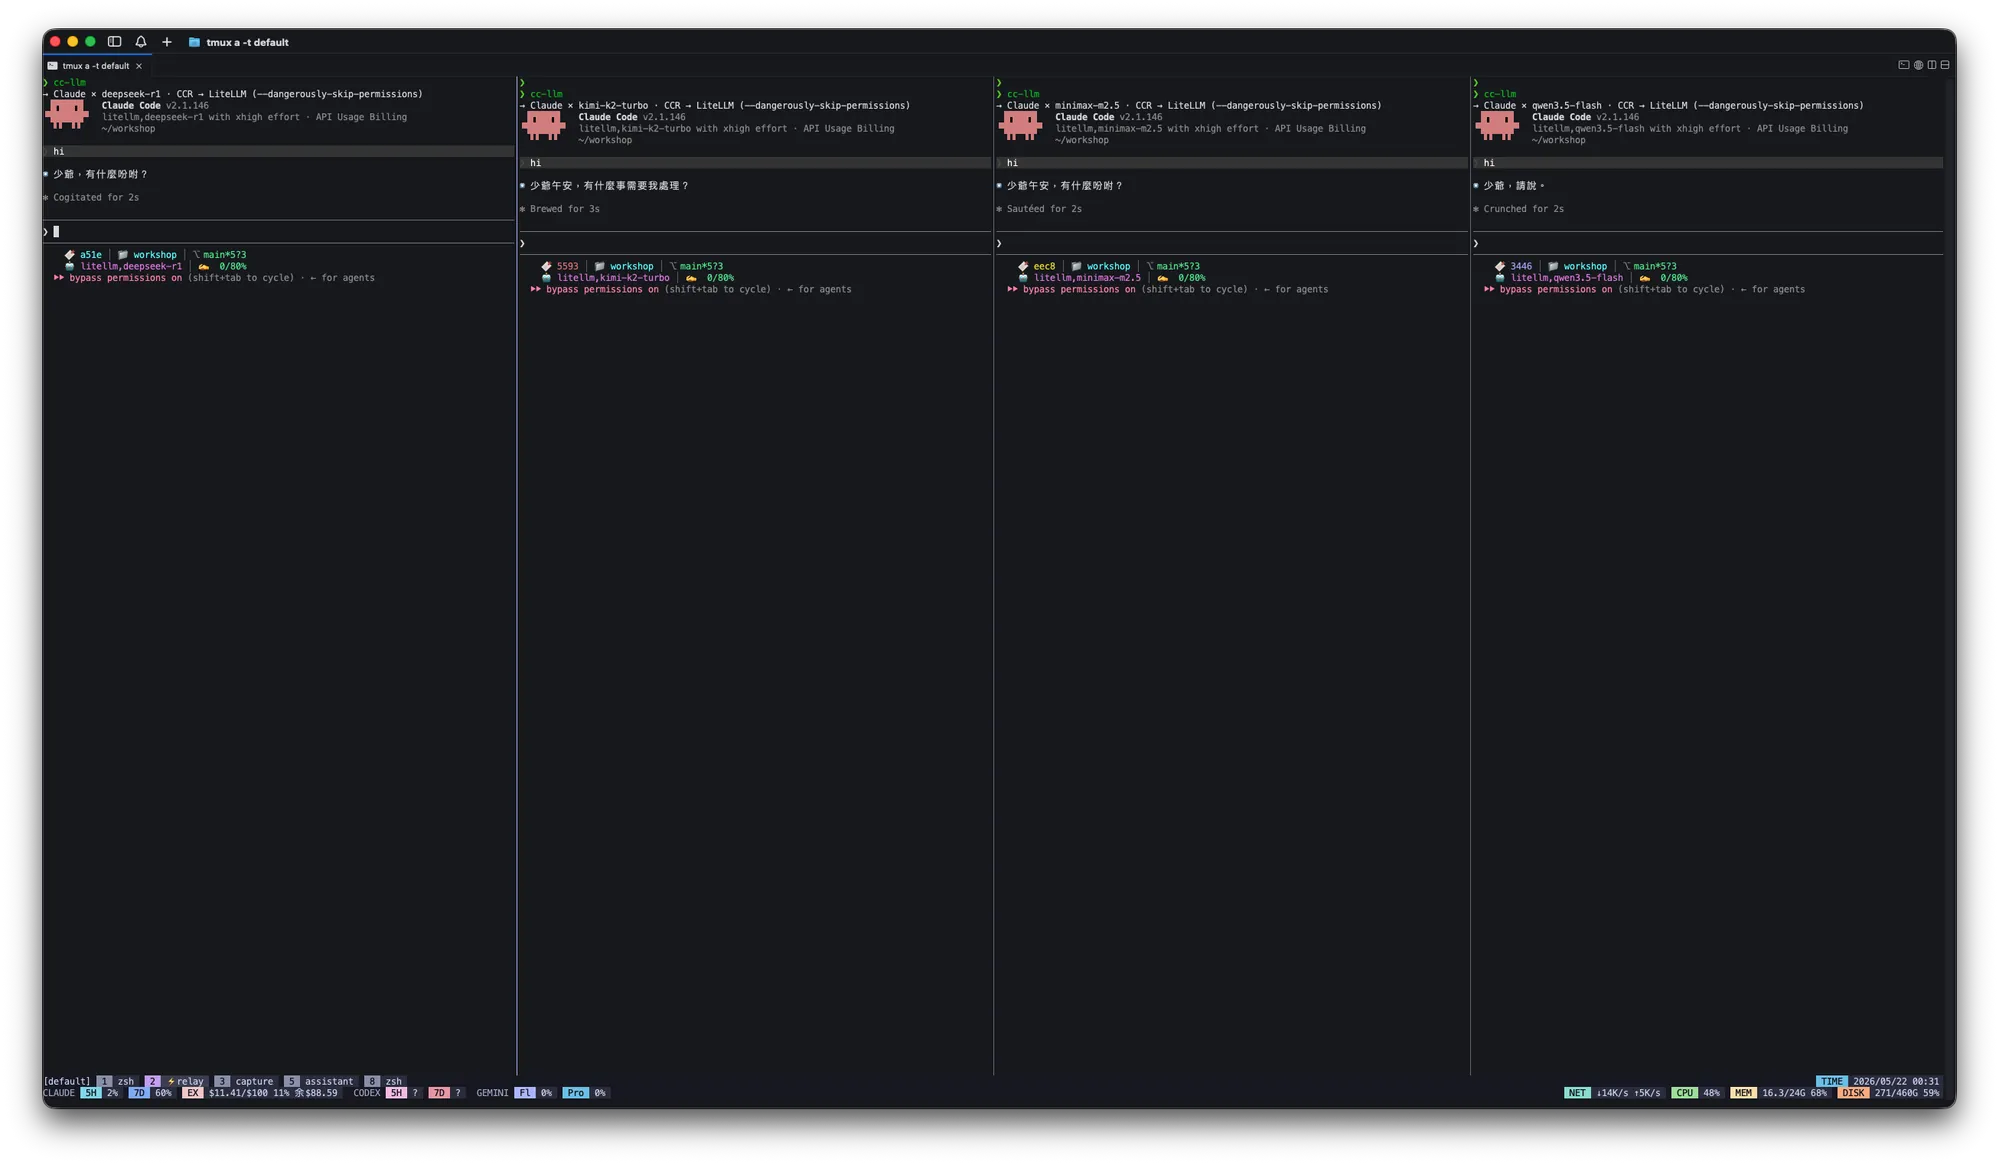
statusline에서 각 pane의 연결 상태를 볼 수 있습니다.litellm,deepseek-r1,litellm,kimi-k2-turbo,litellm,minimax-m2.5,litellm,qwen3.5-flash. 네 pane이 동시에 서로 다른 model을 돌려도 CCR은 :3456 요청의 라우팅만 확인하는 proxy이므로 어느 pane에서 왔는지는 신경 쓰지 않습니다.~/.claude/settings.json 도 전혀 건드리지 않았습니다. 모든 전환은 shell session 안에서만 일어납니다. “한 컴퓨터에서 여러 model을 동시에 실행”하는 상황에서는 기존 방식 중 CCR만이 이를 가능하게 합니다.
기술 구성: LiteLLM + CCR + 직접 만든 zsh function
라우팅은 두 갈래입니다. Claude Code는 Anthropic protocol로 통신하므로 먼저 CCR의 :3456 을 거쳐 OpenAI 프로토콜로 바뀐 다음 LiteLLM의 :4000으로 들어갑니다. Codex, Gemini, OpenCode CLI는 원래 OpenAI 프로토콜을 사용하므로 CCR을 거치지 않고 LiteLLM의 :4000을 직접 호출합니다. 그림으로 나타내면 다음과 같습니다.
LiteLLM이 유일한 게이트웨이입니다. 모든 model_list, API key, fallback, cost telemetry를 config.yaml파일 하나에 모읍니다. provider마다 entry 하나를 두고 API key는 모두 env var로 참조합니다. 형태는 다음과 같습니다(한 entry만 보면 충분합니다).
drop_params + modify_params 은 시행착오 끝에 추가한 “400 오류 방지” 이중 안전장치로, 회사마다 param schema를 수동으로 맞추는 수고를 덜어 줍니다.fallbacks 설정하고 나면 A model에서 429/5xx가 발생할 때 자동으로 B로 전환합니다.
CCR 쪽은 config.json 구조가 더 간단합니다. 핵심은 Router 블록에서 작업 유형을 구체적인 model에 대응시키는 것입니다.
마지막은 이 모든 것을 한 줄 명령으로 만들어 주는 직접 작성한 zsh function cc-llm입니다(민감 정보 제거한 기본 구조).
실제로는cc-llm 를 인자 없이 호출하면 fzf 메뉴가 열려 LiteLLM에서 현재 사용 가능한 모든 model을 자동으로 가져와 provider별로 묶어 보여 줍니다.
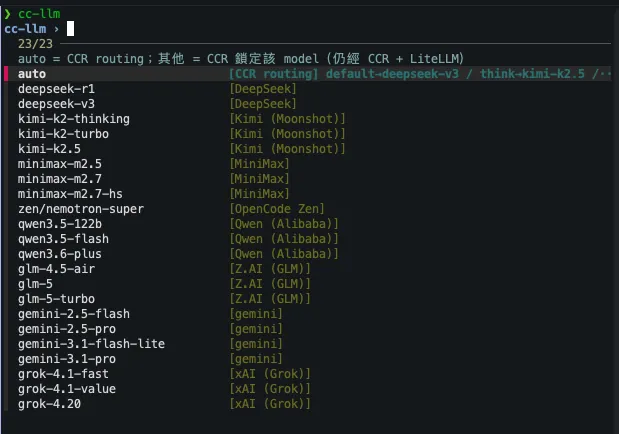
model을 선택하면 Claude Code가 TUI로 시작하고, statusline에 어떤 경로와 model을 쓰는지, effort 값은 얼마인지 명확히 표시됩니다.
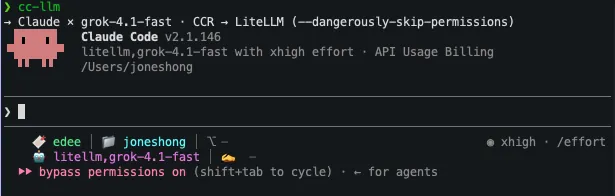
예를 들어 위 이미지에서 제목 표시줄의 “Claude × grok-4.1-fast · CCR → LiteLLM”는 zsh function이 출력한 메시지이고, 상태 표시줄 아래의 “litellm,grok-4.1-fast”는 Claude Code가 직접 ANTHROPIC_MODEL 을 읽고 표시한 것입니다. effort는 xhigh로 고정되어 있고 bypass permissions on입니다. 예상한 값과 일치하는지 확인하면 안심하고 작업을 시작할 수 있습니다.
다른 사용법:
같은 방식으로 cx-llm(Codex),gm-llm(Gemini CLI),oc-llm(OpenCode)도 만들었습니다. 이 세 CLI의 프로토콜은 CCR과 호환되지 않으므로 LiteLLM에 직접 연결합니다. 모든 CLI가 LiteLLM의 config.yaml설정 하나를 공유하므로 새 model을 추가할 때 한 곳만 바꾸면 됩니다.
subagent에도 더 저렴한 모델 설정
간단한 작업을 맡는 explorer, researcher, browser, media 네 subagent의 model을 기본 sonnet에서 haiku로 바꿨습니다. subagent 정의 파일(~/.claude/agents/*.md)의 model: 필드가 이를 제어합니다. 메인 대화가 subagent에 작업을 위임하고, subagent가 결과를 돌려주면 메인 대화가 이어서 진행합니다.
| Agent | 용도 | 변경 후 model |
|---|---|---|
explorer | codebase 검색, 파일 찾기 | haiku |
researcher | web 검색, 자료 정리 | haiku |
browser | Playwright CLI browser automation | haiku |
media | 영상 / 이미지 / OCR 처리 | haiku |
이 네 작업의 공통점은 tool call은 많고 reasoning은 얕으며 높은 model 지능은 필요하지 않은데 turn과 context는 많이 쓴다는 것입니다. 원래는 모두 sonnet으로 돌려 할당량 소모가 컸지만, haiku로 바꾸고 나서는 비용이 90% 줄었고 품질 저하도 뚜렷하지 않았습니다.
조금 더 정교하게는 동적으로 조정합니다. 제가 만든 model-policy daemon은 5분마다 Claude 할당량의 잔여량을 확인하고 normal / boost-1 / boost-2 / boost-3 네 단계로 나눕니다. 할당량이 넉넉할 때 haiku는 그대로 haiku입니다. 할당량이 거의 소진될 때(5h < 25% 또는 7d < 40%)는 haiku를 sonnet으로, sonnet을 opus로 자동으로 올립니다. “큰 model을 쓸 수 있을 때” 충분히 쓰고 “아껴야 할 때” 자동으로 등급을 낮춥니다.
이 역할 분담은 “Claude Code 내부”에서 일어납니다. 메인 대화는 계속 sonnet/opus로 계획하지만, 간단한 일을 맡은 subagent는 haiku로 실행합니다. LiteLLM의 “외부 worker”와는 별개의 할당량 절약 방법이며 함께 적용할 수 있습니다.
지금 각 model을 얼마나 썼는지 확인하기
워크플로를 연결하고 나니 작은 문제가 하나 남았습니다. 다섯 회사에 Big-3까지 합쳐 dashboard가 여덟 개이고, 사이트마다 화면 구성도 다릅니다. 각 회사의 관리 화면 몇 개를 보여 드리겠습니다.
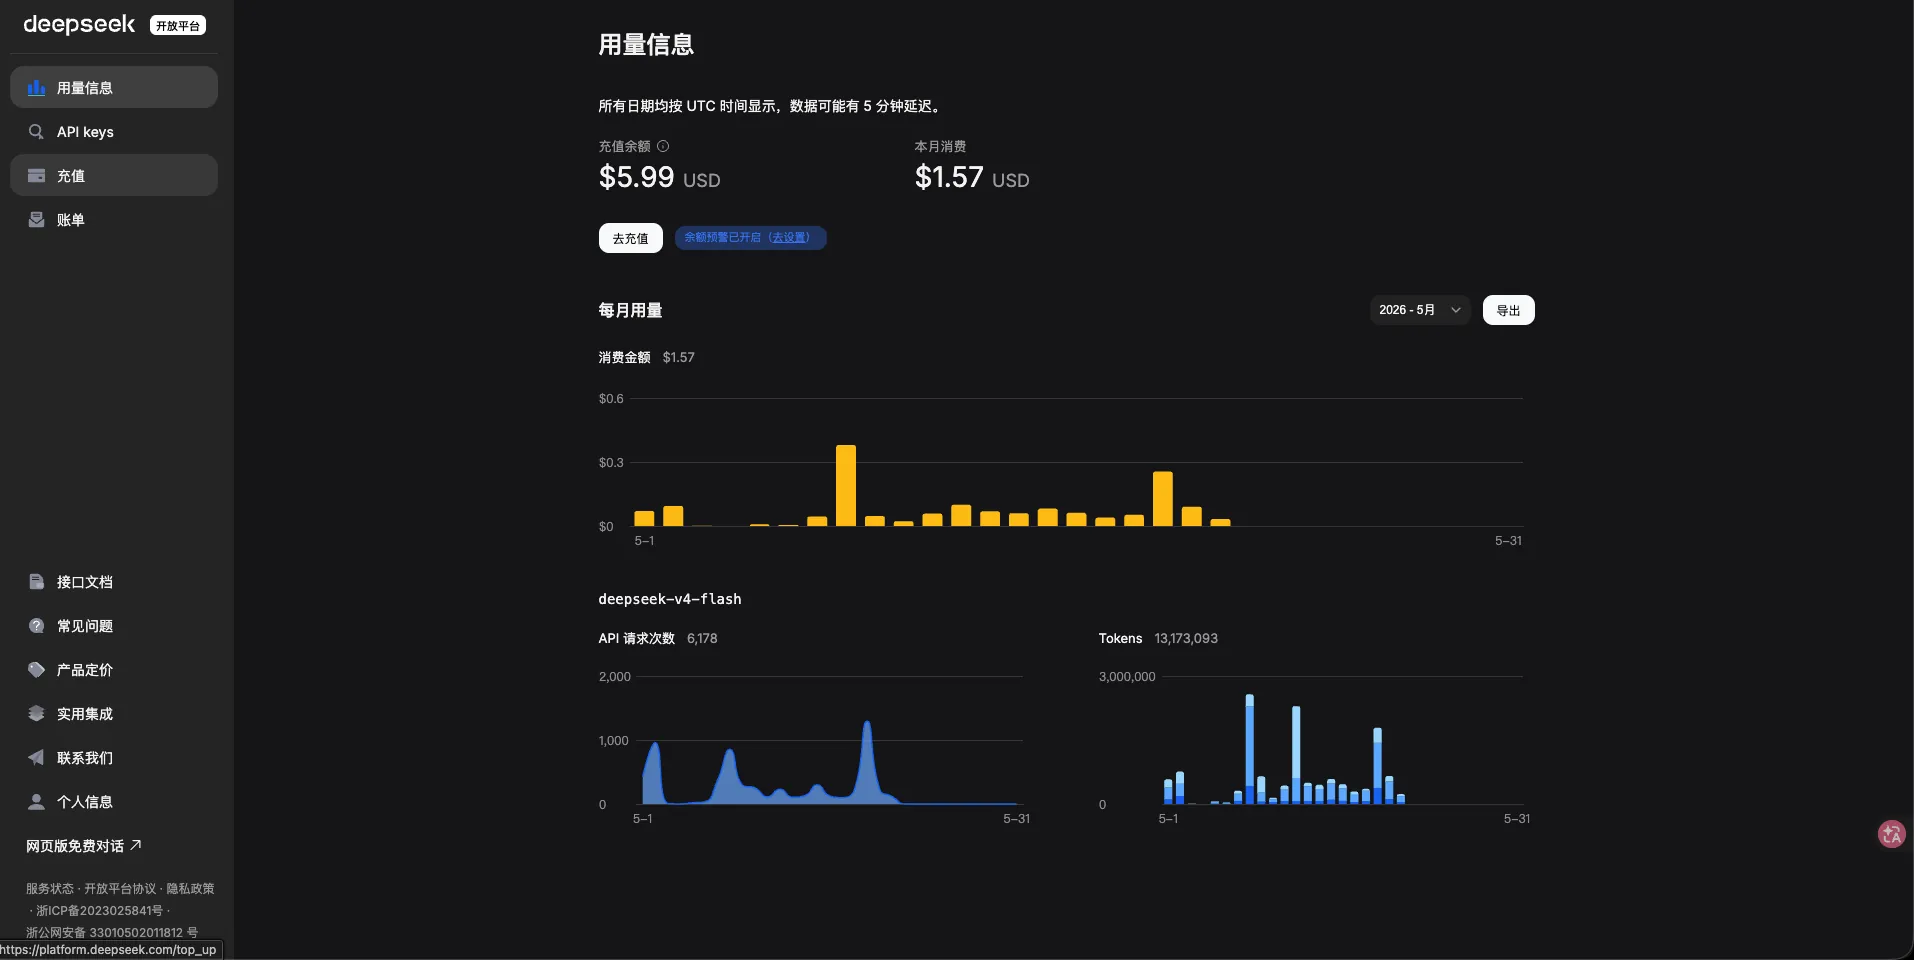
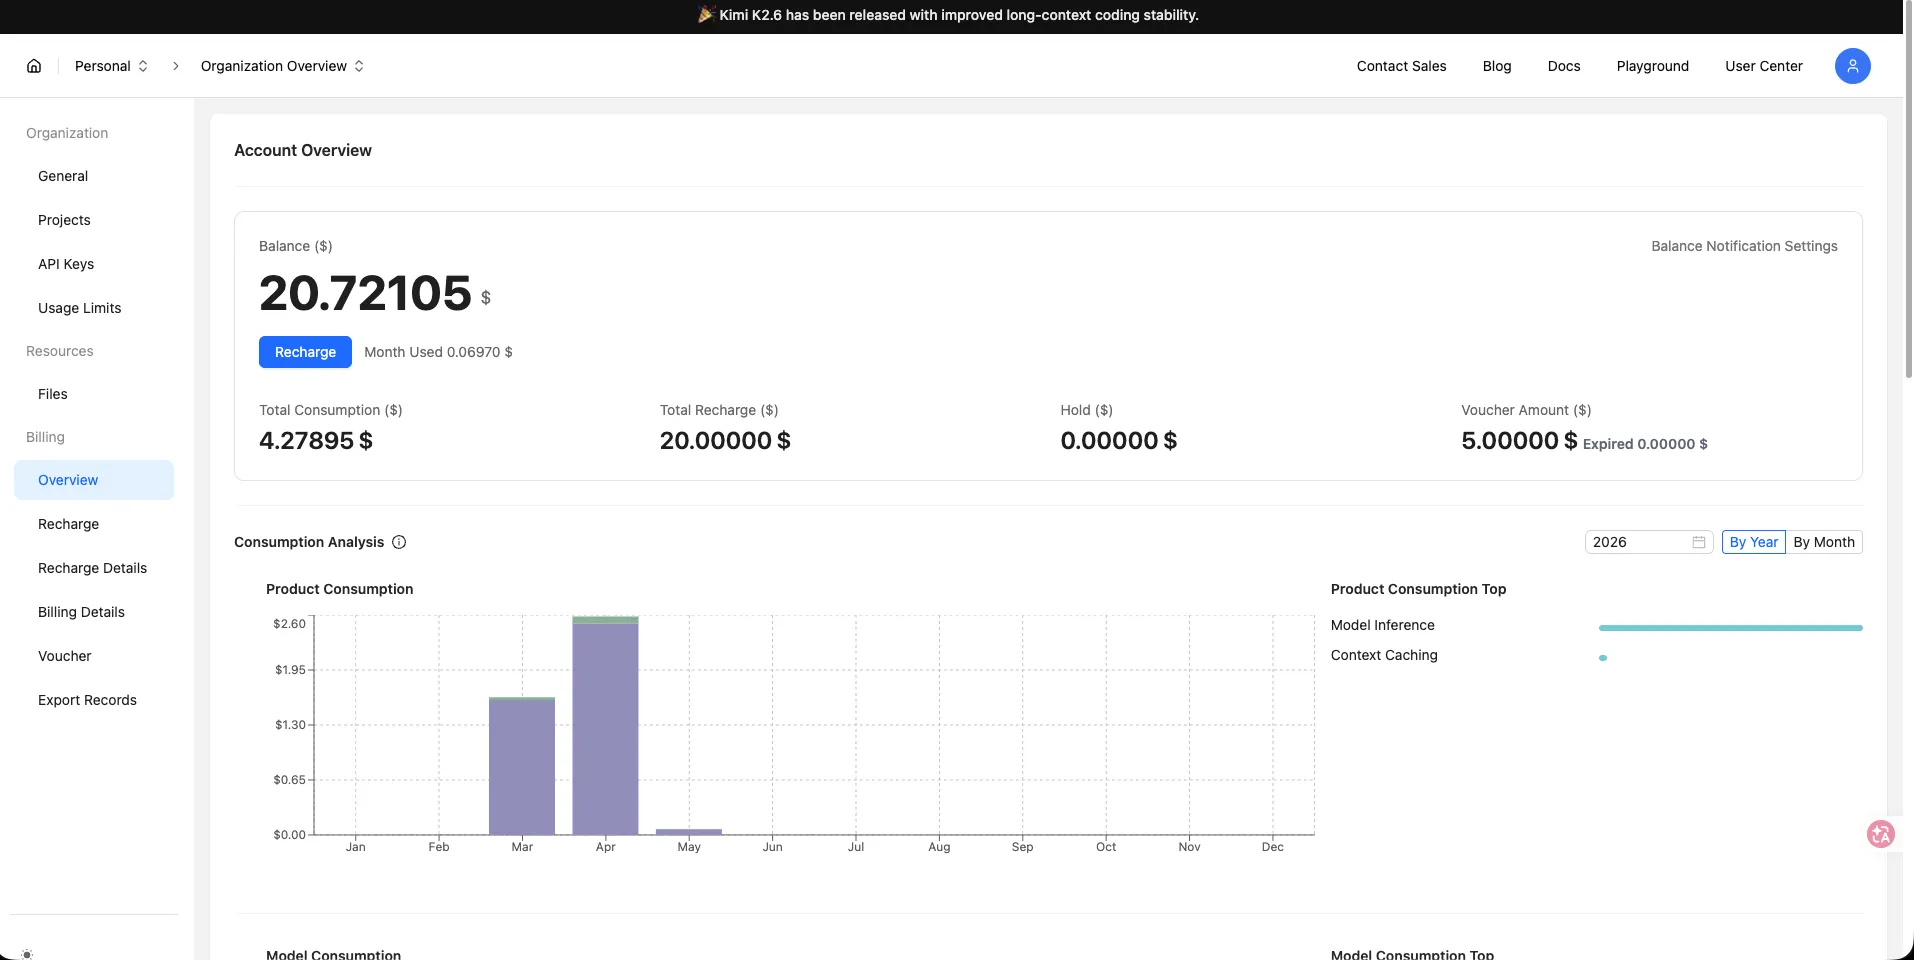
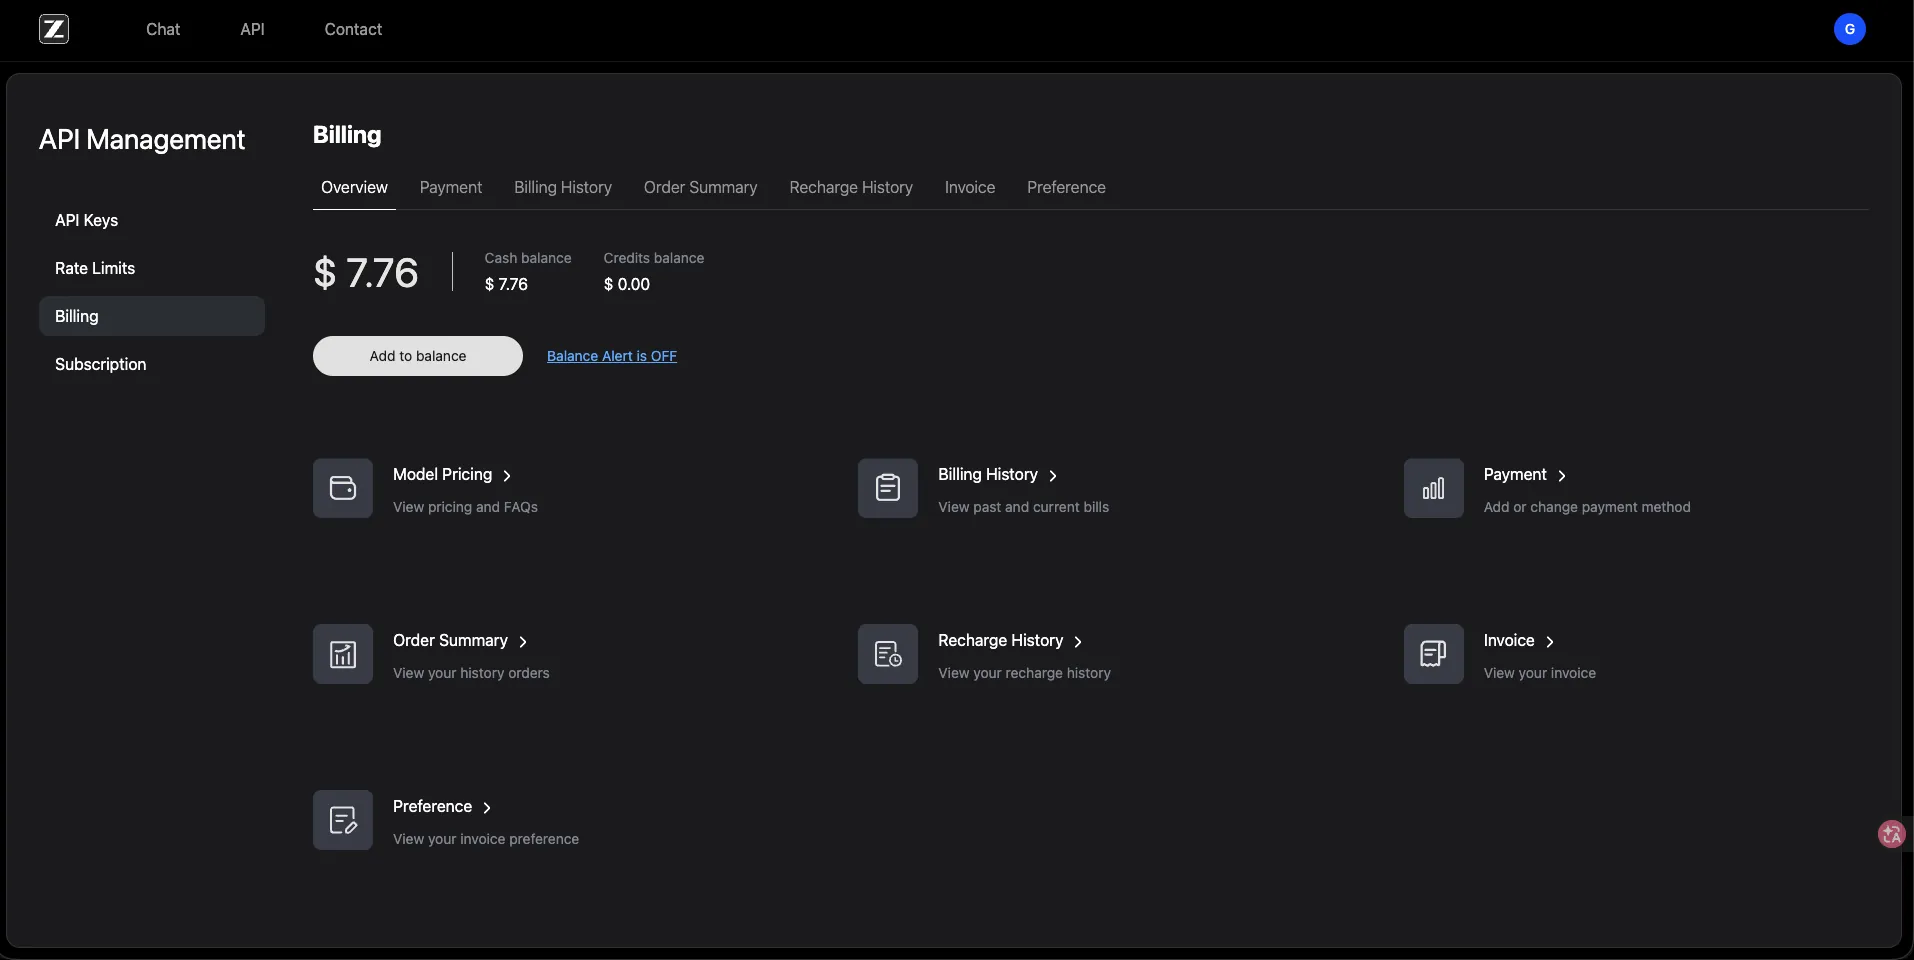
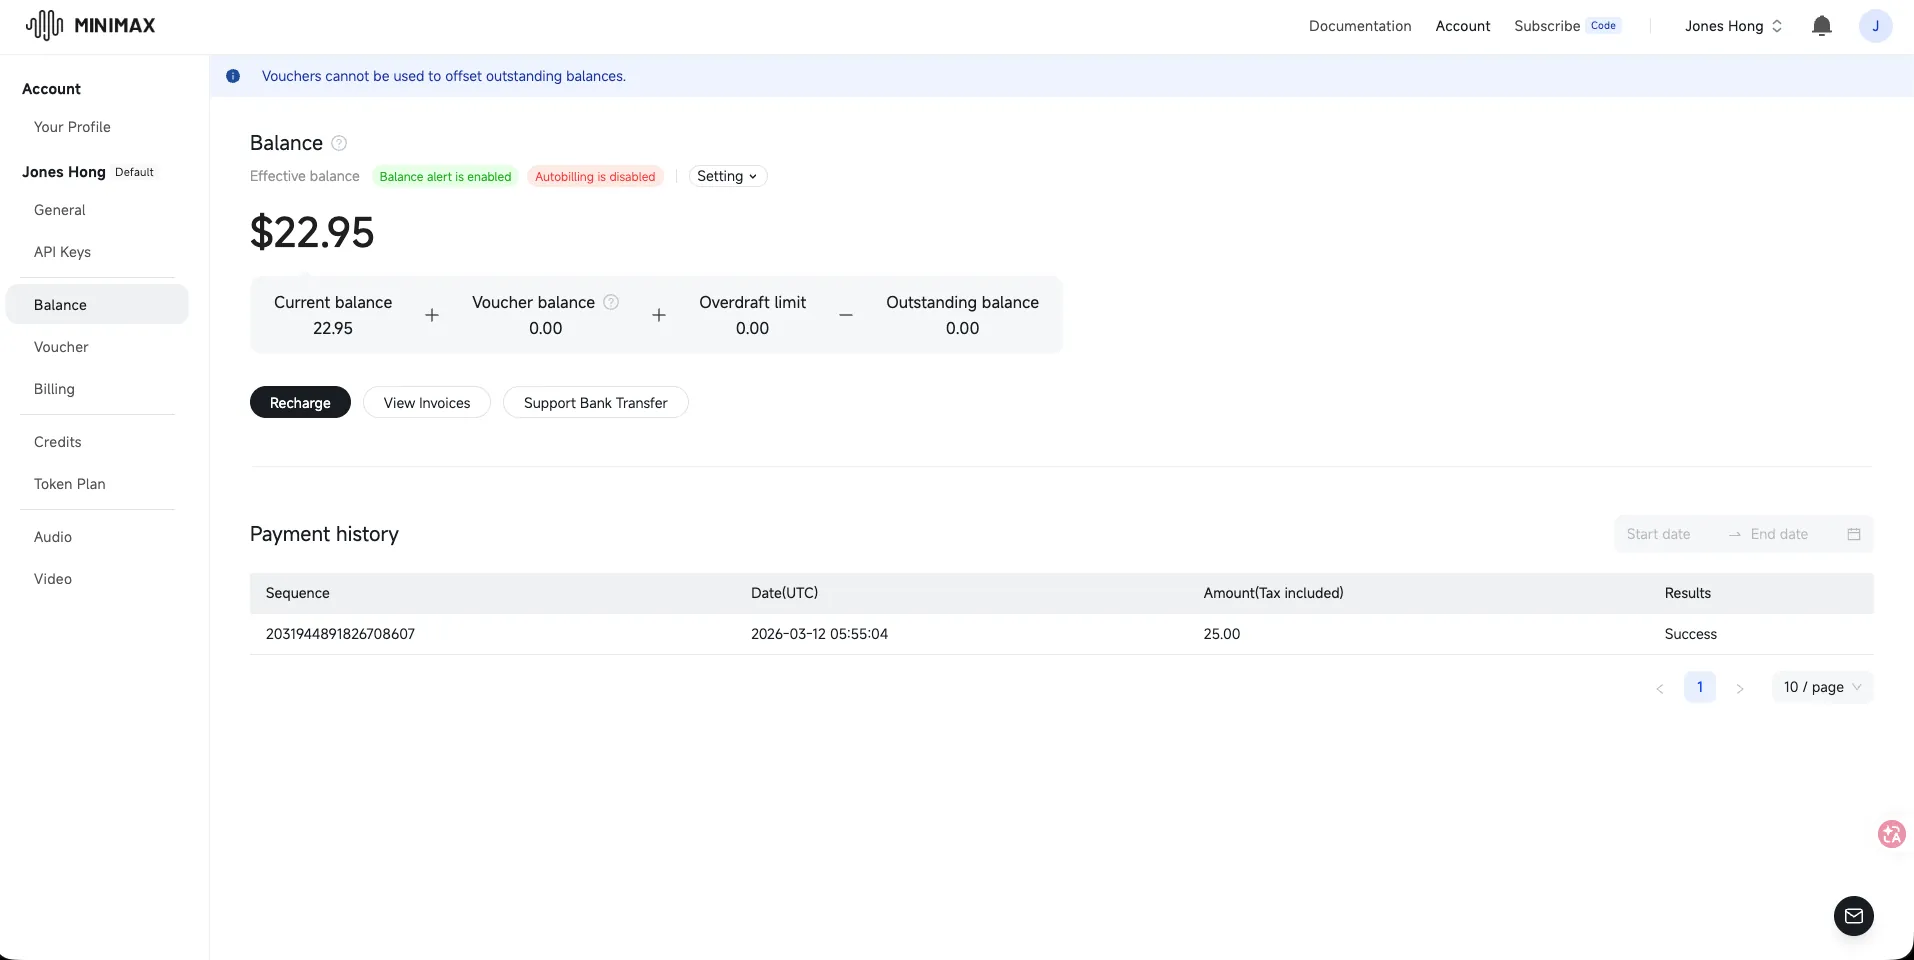
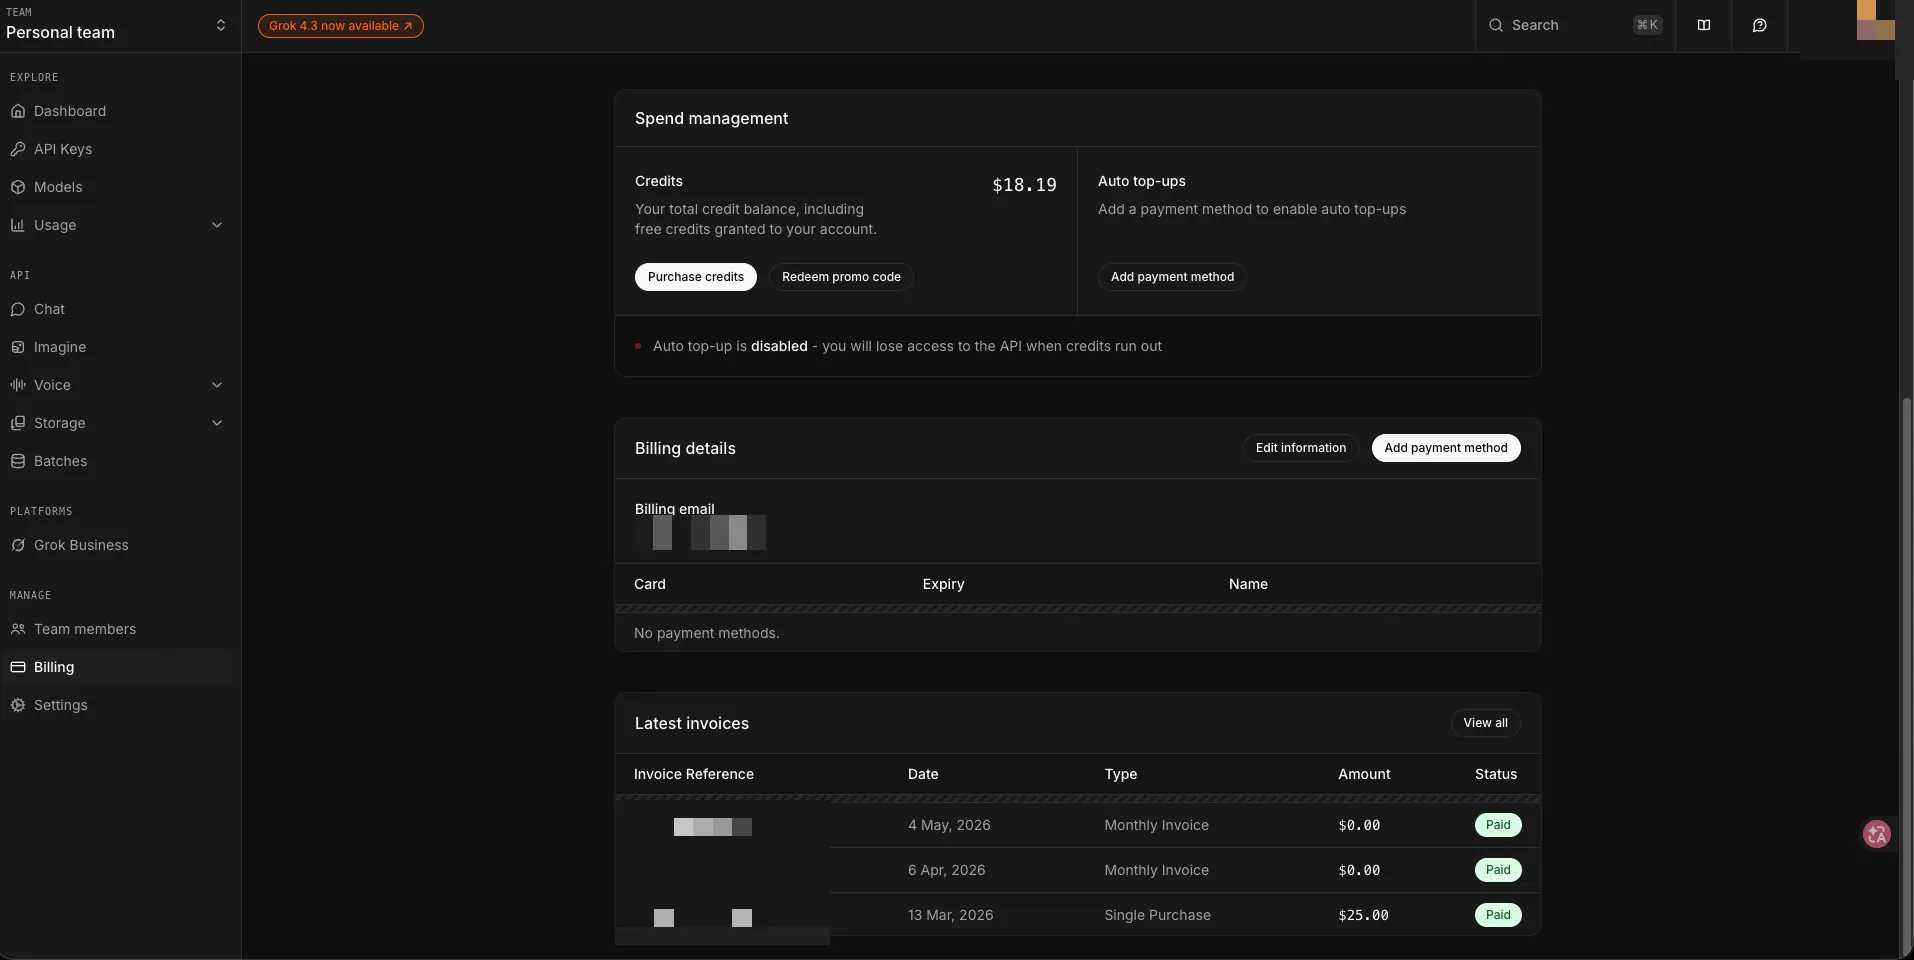
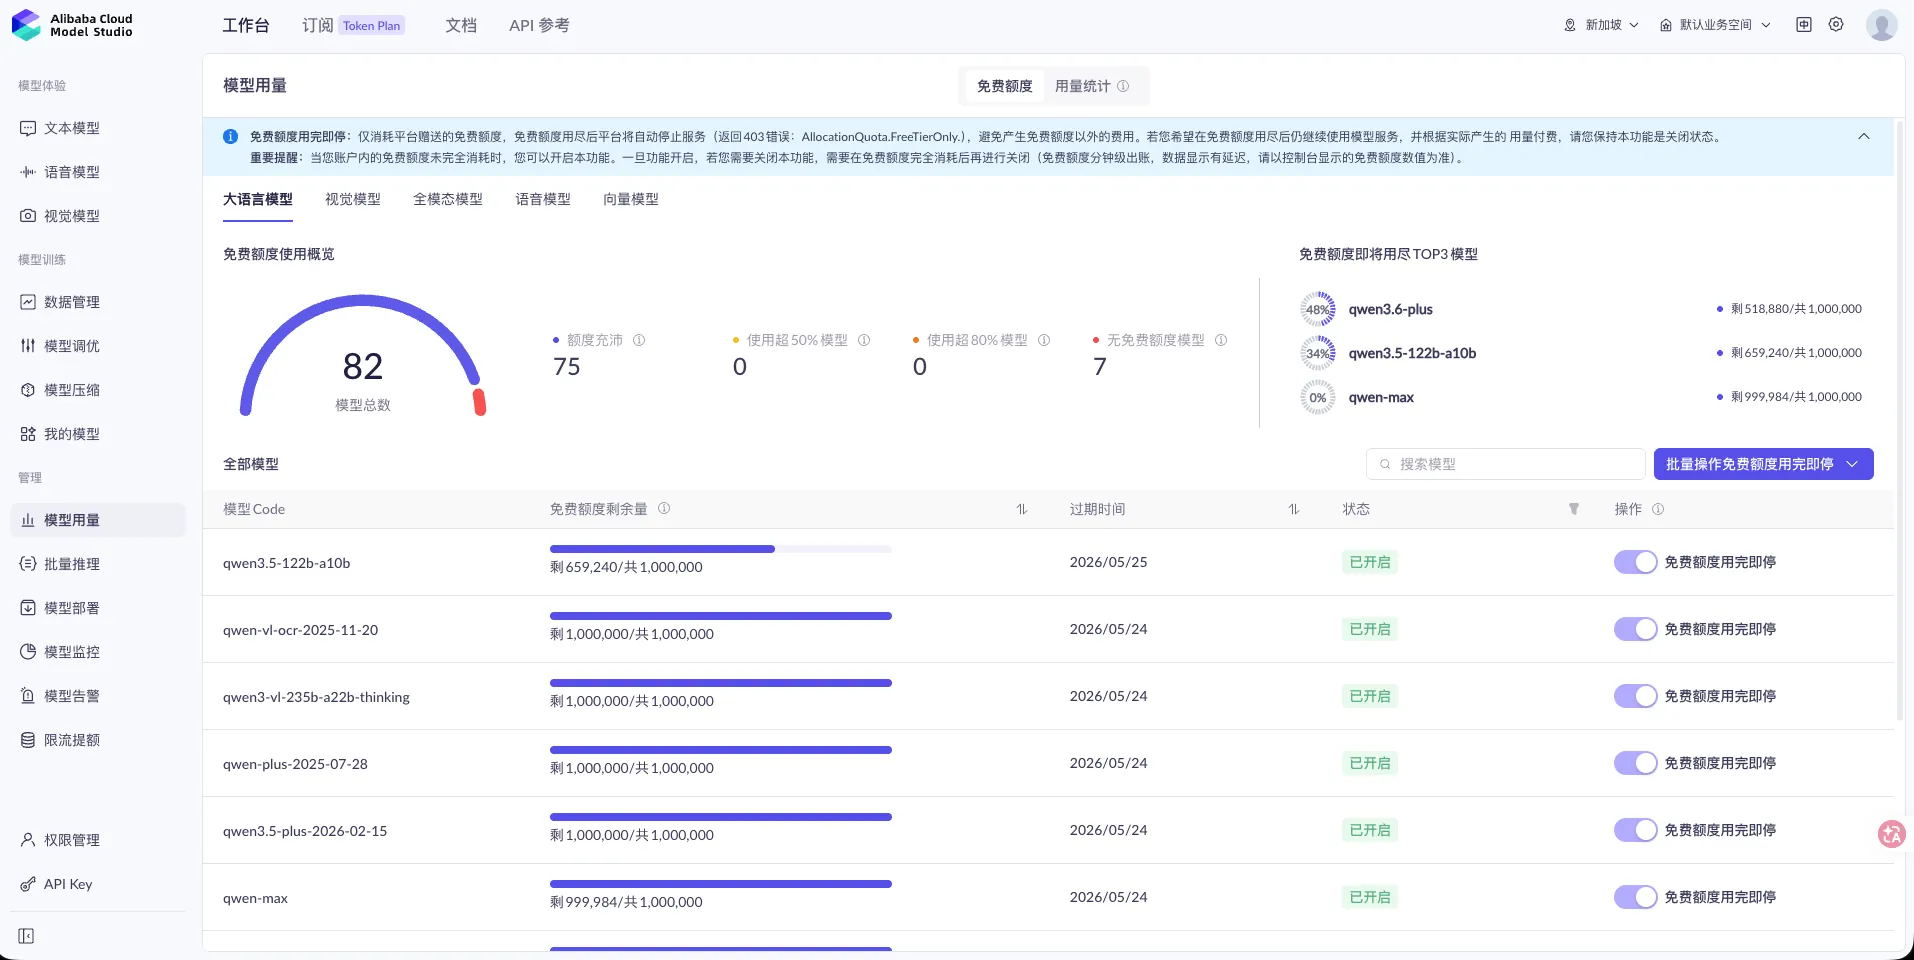
회사마다 설계 방식이 다르므로 “다음 작업을 어디에 맡길까”라는 질문에는 어느 한 관리 화면도 답하지 못합니다. 여섯 탭을 열어 손으로 비교하거나 직접 통합해야 합니다.
그래서 매일 정해진 시간에 잔액을 한 번씩 가져오는 작은 모니터링 페이지를 직접 만들었습니다. view는 세 가지입니다.
할당량 view—구독형 할당량(Claude 5h/7d/EX, Codex 5h/7d, Gemini Pro/Flash 24h)과 reset 시간을 한곳에 표시합니다.
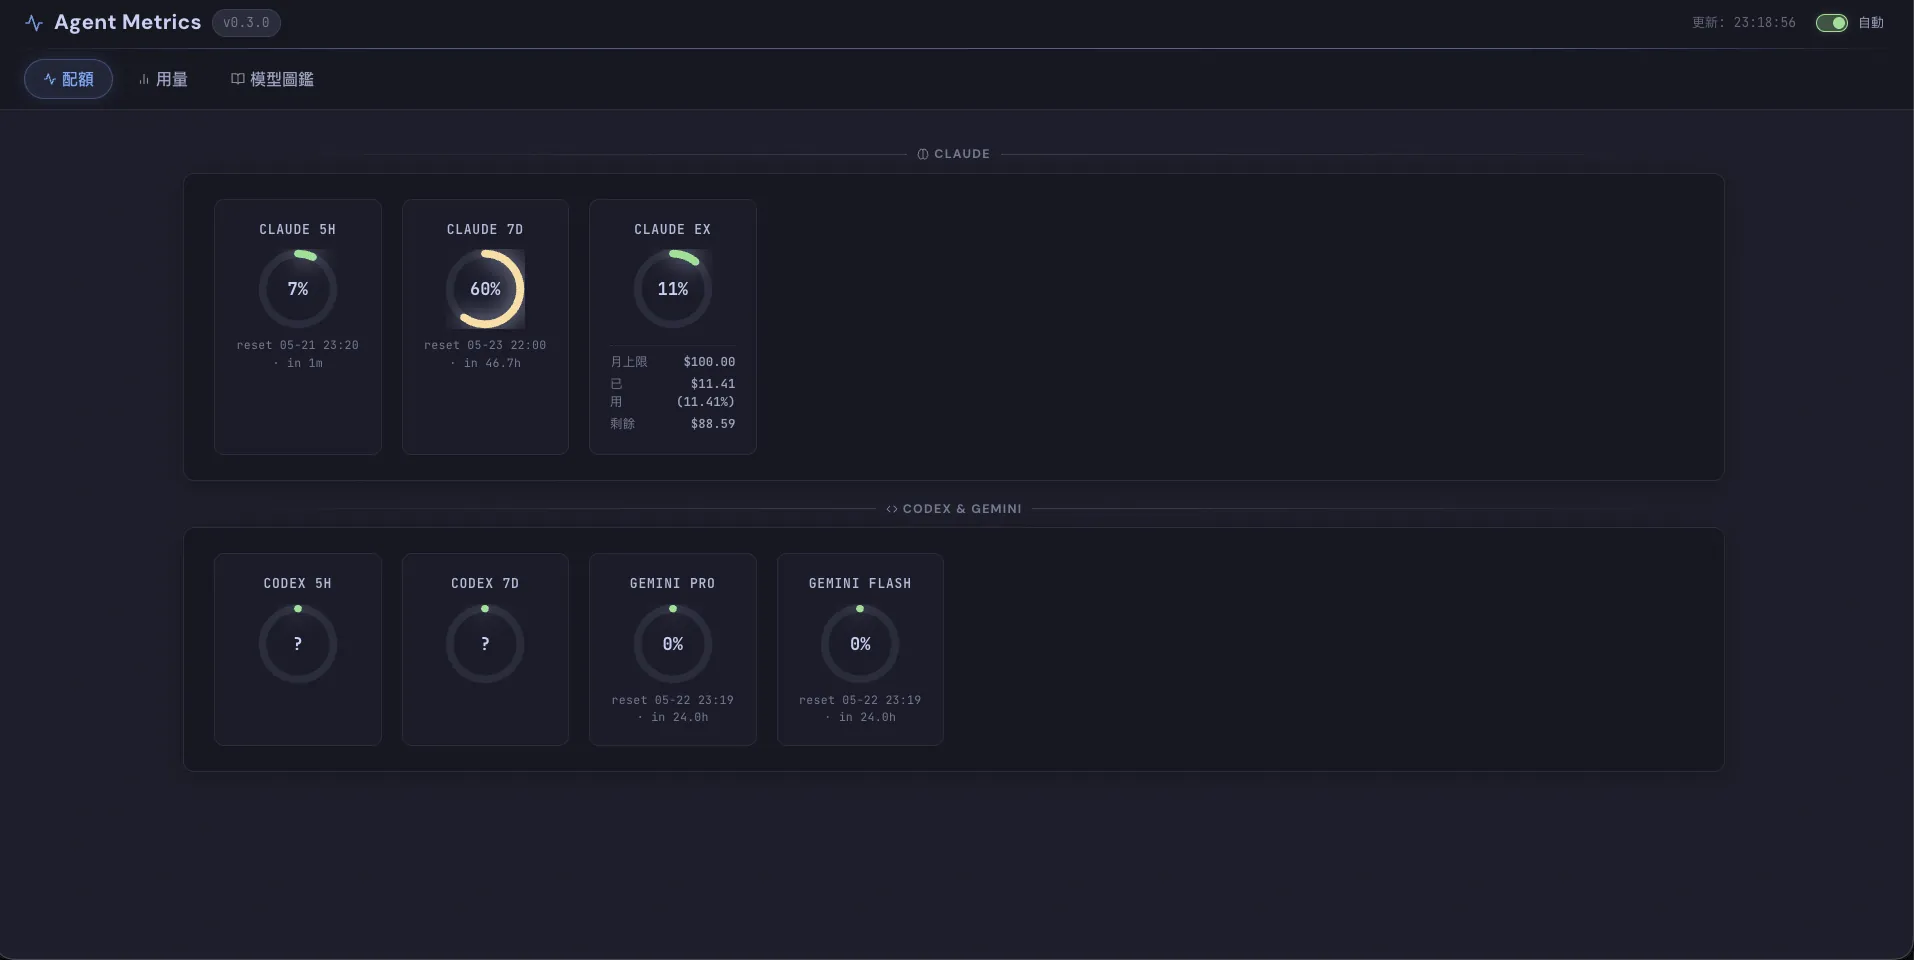
한눈에 알 수 있습니다. Claude 5h는 7%만 썼고 곧 reset되지만, 7d는 60%를 써서 다음 reset까지 약 이틀 남았고, EX 월 한도 $100 중 11%를 썼습니다. 계속 밀어붙일지 worker model을 먼저 바꿀지는 할당량 view를 보고 결정할 수 있습니다.
사용량 view—LiteLLM의 선불 할당량과 각 provider의 충전액 / 잔액 / 사용액 / 사용률을 한눈에 펼쳐 보여 줍니다.
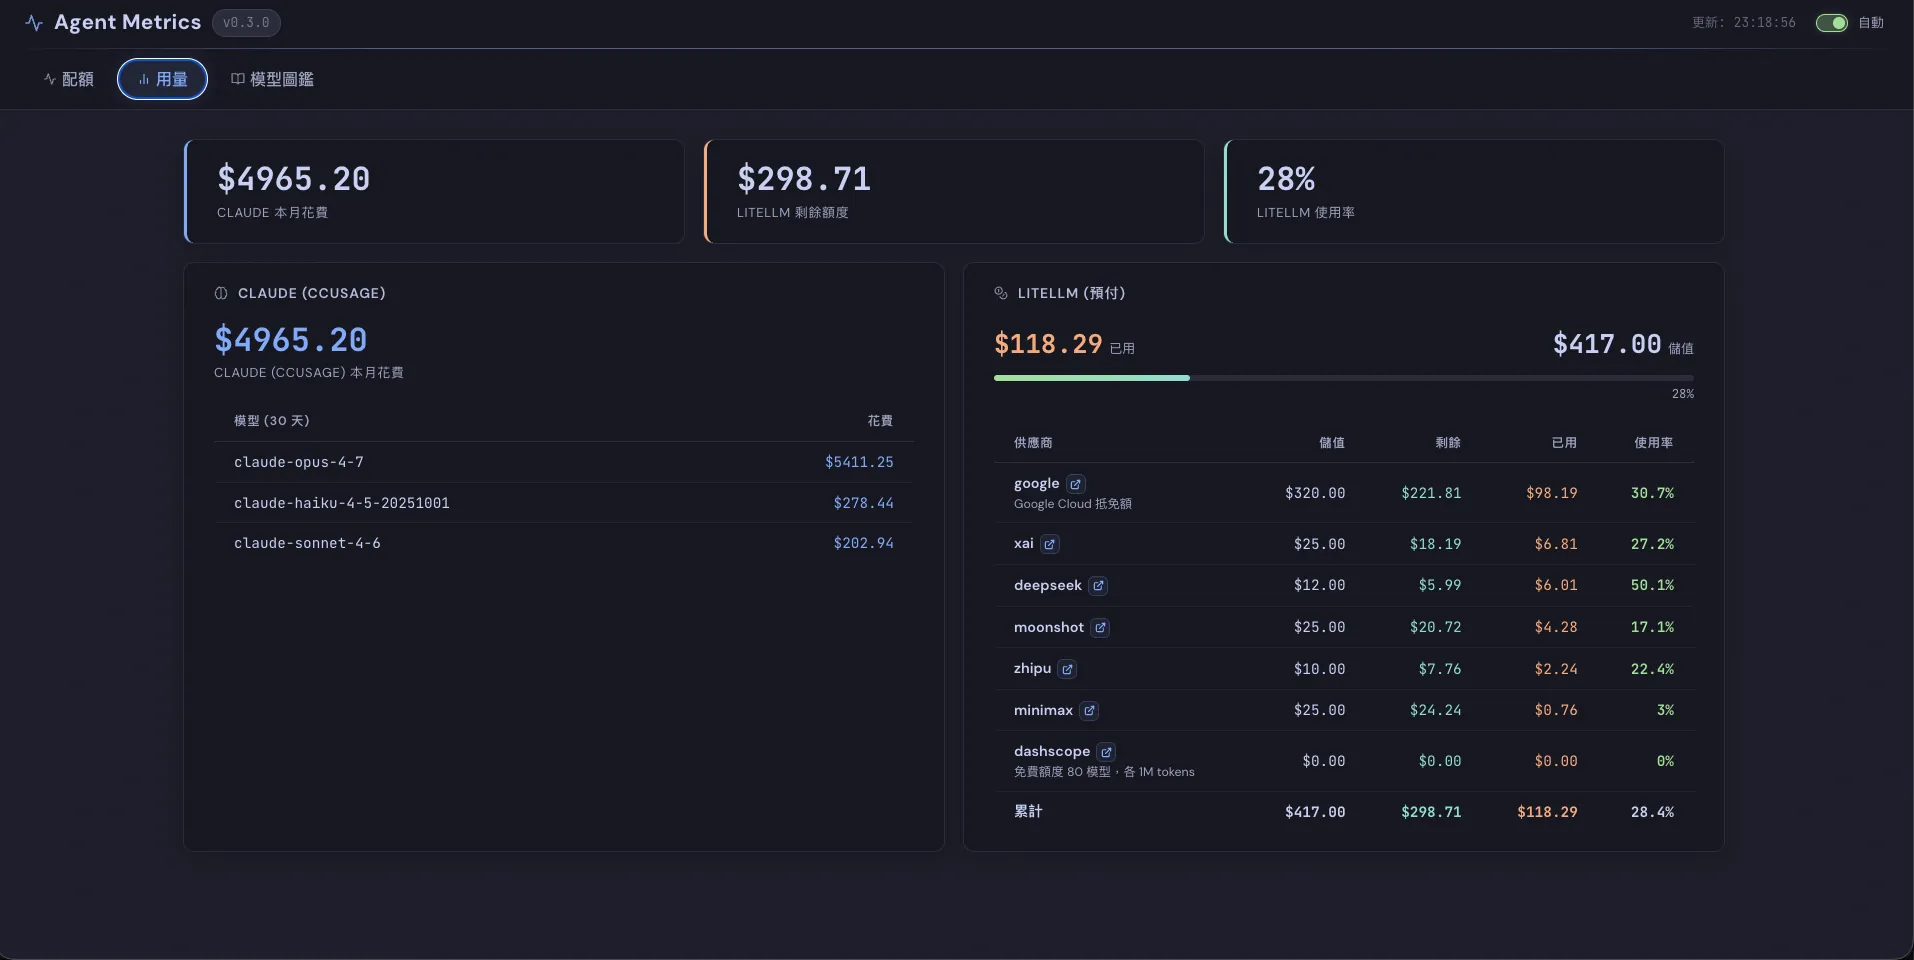
가장 자주 보는 것은 사용량 view입니다. DeepSeek는 50%를 썼지만 Moonshot은 17%, MiniMax는 3%만 썼습니다. DeepSeek에 batch task가 너무 많이 몰렸다는 뜻이니 다음에는 일부를 Moonshot이나 MiniMax로 분산해 한 provider의 할당량이 먼저 바닥나는 일을 피할 수 있습니다. Google Cloud 크레딧도 이 페이지에 넣었습니다. 무료이지만 “소진 직전”은 추적해야 합니다.
모델 도감 view—각 회사의 플래그십 / Fast / Value 모델 목록과 Arena / SWE-Bench / Speed 기준 상황별 추천을 보여 줍니다.
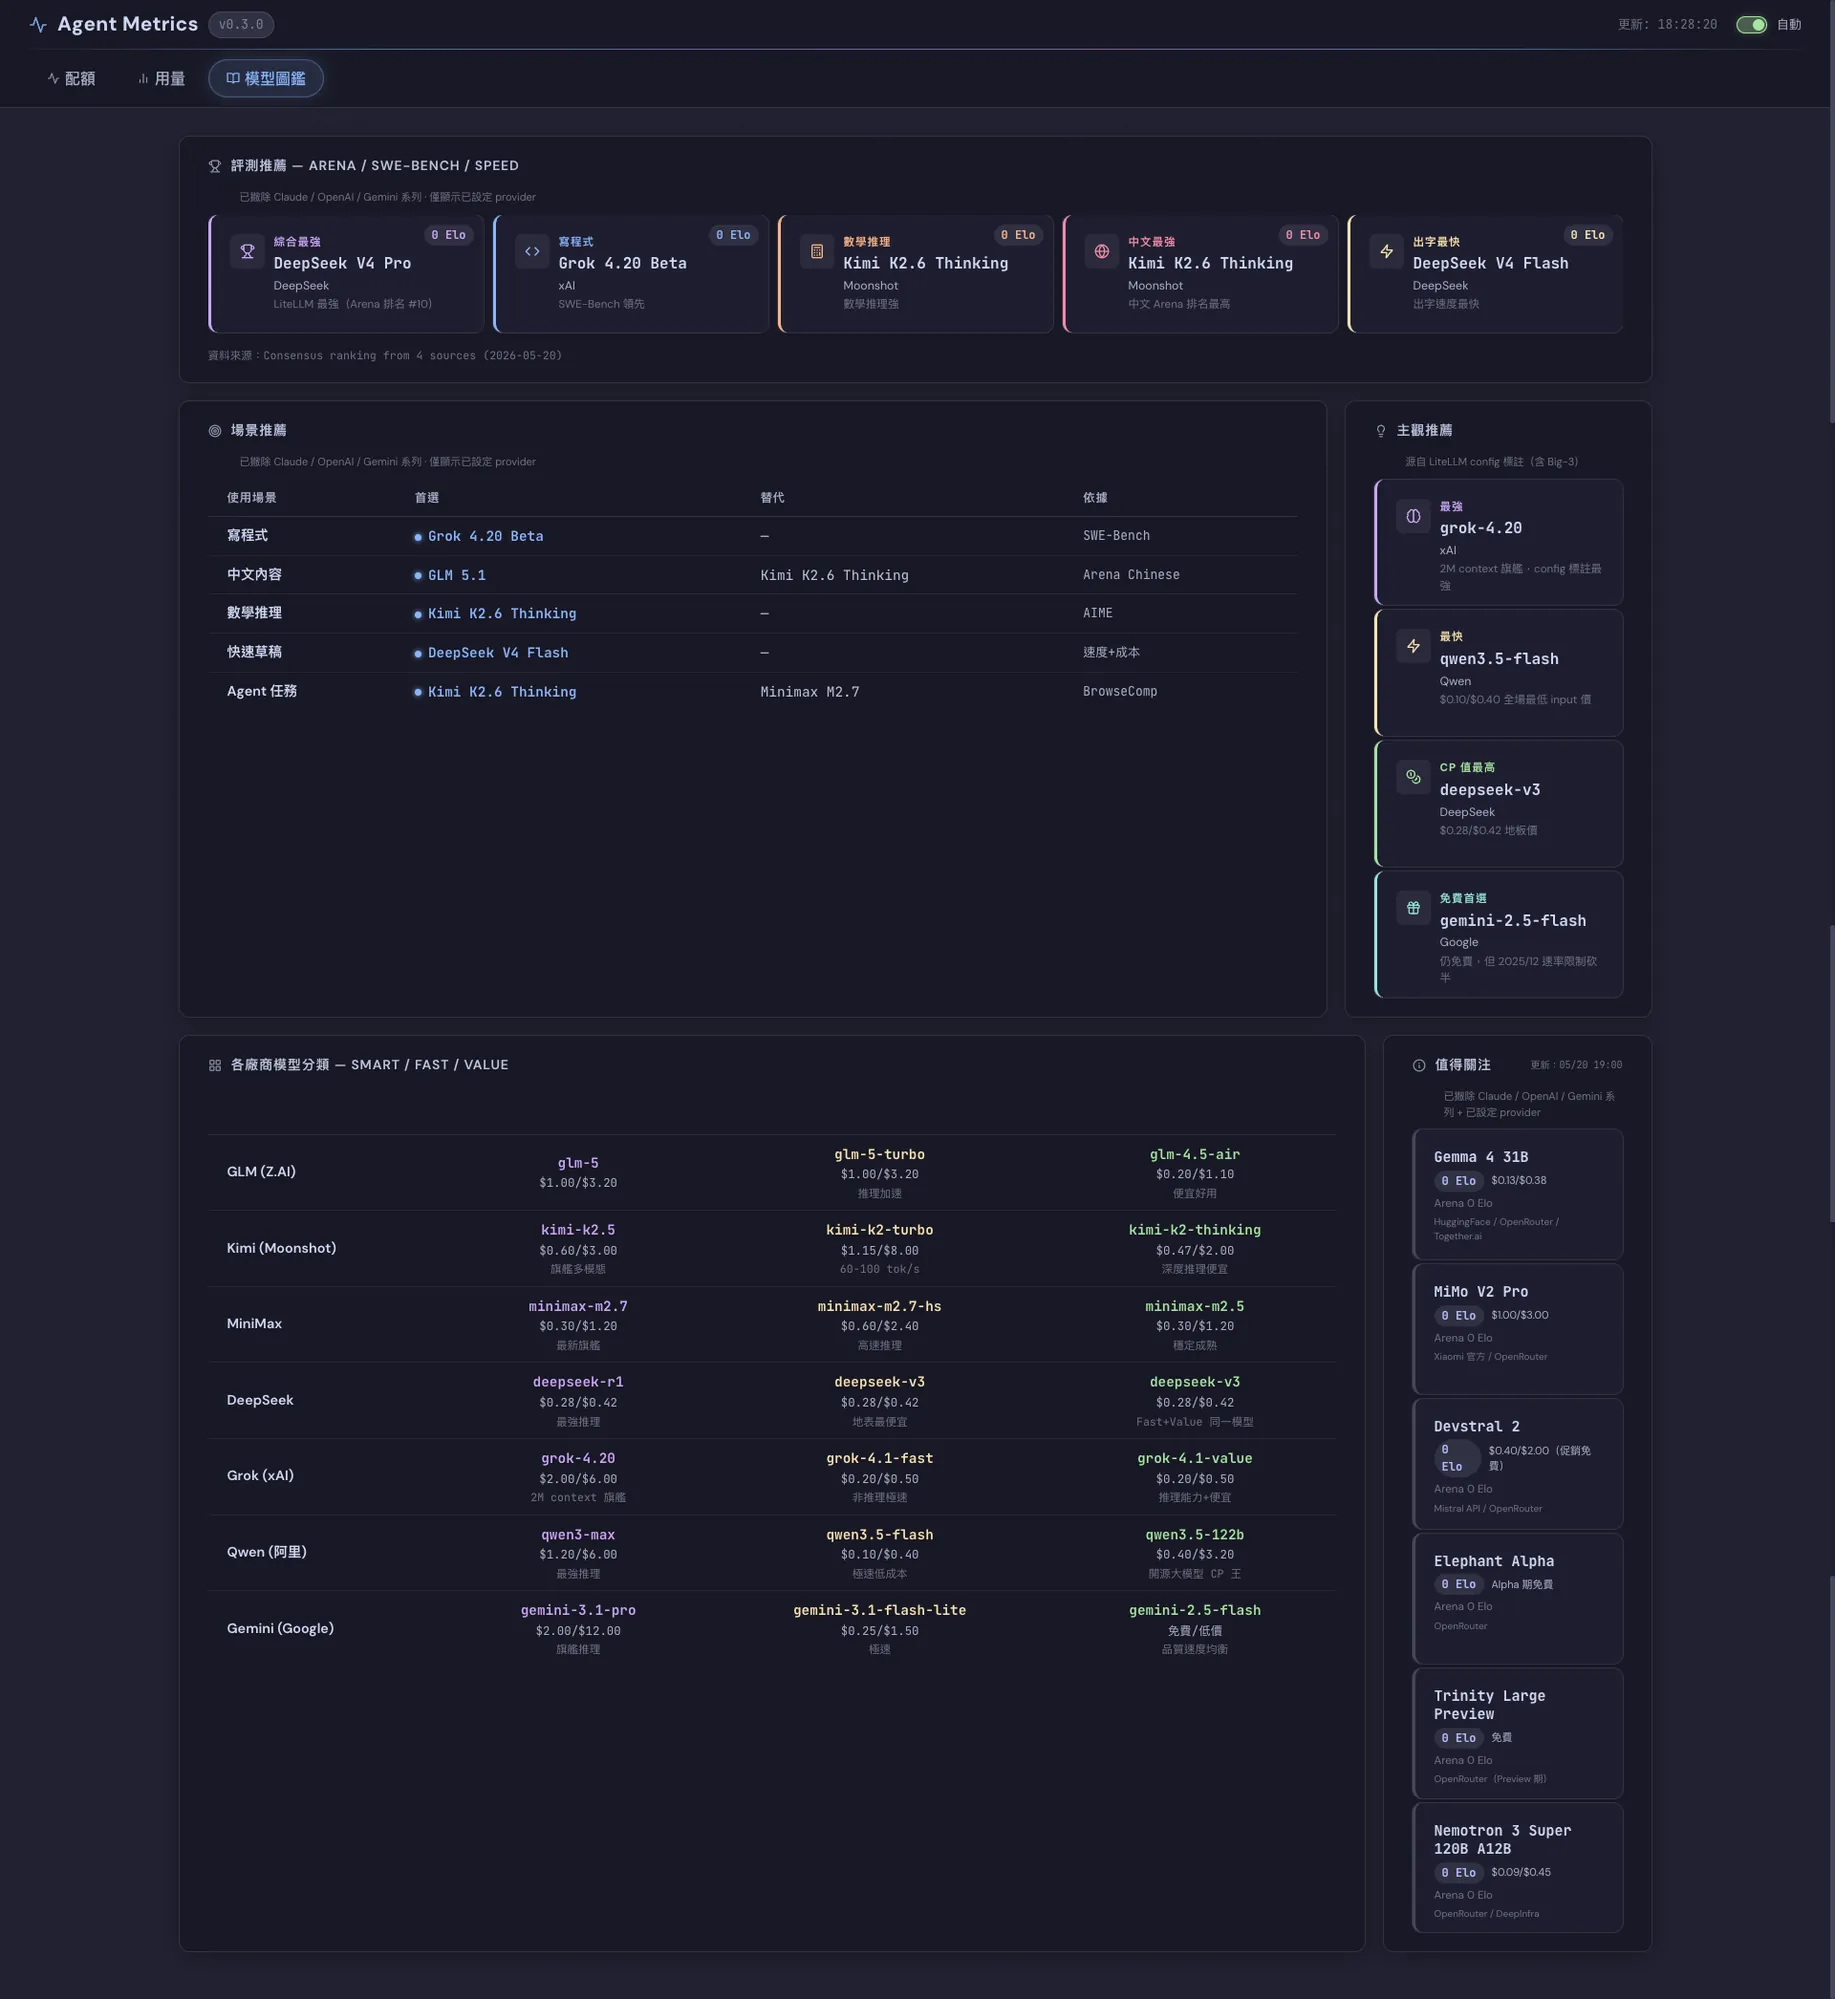
모델 도감은 며칠마다 한 번씩 업데이트하며(Consensus ranking from 4 sources) “지금 어떤 model을 어떤 작업에 라우팅할지” 결정하는 데 씁니다. 2026-05-20에는 수학 추론의 첫 번째 선택을 DeepSeek R1에서 Kimi K2.6 Thinking으로 바꾸고 LiteLLM의 config.yaml 과 CCR의 Router 을 함께 업데이트했습니다.
provider model list를 비교해 “오래된 설정” 감지
크롤러는 네 번째 일도 합니다. 각 provider 공식 사이트의 /v1/models endpoint를 가져와 LiteLLM config.yaml 에 적어 둔 model_name 과 비교합니다. 이 검사는 문제를 겪고 나서 추가했습니다.
이전에는 이런 일이 여러 번 있었습니다. 아침에 Claude Code를 열어 작업을 시작하면 CCR이 :3456 404 model not found를 반환합니다. 한참 조사하고 나서야 공급자가 xxx-preview 를 xxx-stable으로 바꾸거나 이전 버전인 v3.1 을 바로 중단하고 v3.2으로 교체한 사실을 알게 됩니다. LiteLLM의 config.yaml 에는 여전히 예전 이름이 적혀 있어 전체 경로가 끊긴 것입니다. 최신 모델의 교체 속도는 생각보다 빠릅니다. DeepSeek, Moonshot, Qwen은 한두 주 만에 model code를 한 차례 바꾸기도 하고, 이전 이름과의 호환성이 없는 경우도 많습니다.
비교 방식은 간단합니다.
dashboard에서 stale 는 빨간색,new 는 초록색으로 표시하므로 “config에서 이미 무효가 돼 삭제할 항목 / 새로 나와 평가할 항목”을 한눈에 알 수 있습니다. 사후 debug였던 이 검사가 사전 경고가 되고 나서는 “시작한 뒤에야 model 404를 발견하는” 일이 없어졌습니다.
백엔드는 매일 한 번씩 실행되는 크롤러이고, 프런트엔드는 직접 만든 작은 단일 페이지입니다. 기술을 과시하려고 만든 것이 아닙니다. 기존 도구 어디에도 이 정보를 통합해 놓지 않아 직접 보고 싶으면 직접 만들어야 했습니다.
누구에게 맞고 누구에게 맞지 않는가
장점은 세 가지입니다. 3단계 역할 분담으로 할당량을 필요한 곳에 집중할 수 있고, 다른 회사 모델의 실제 수준도 파악할 수 있으며, 한 provider가 중단돼도 워크플로 전체가 멈추지 않습니다.
- 3단계 역할 분담으로 ROI를 맞춥니다—계획은 가장 똑똑한 model에, worker의 배치 작업은 $0.2/$0.5급 모델에, 검증은 두 model의 교차 확인에 맡깁니다. 같은 할당량으로 며칠 더 버틸 수 있고 결과물의 품질도 한 model이 처음부터 끝까지 맡는 것보다 안정적입니다.
- “다른 모델도 알아보는 것”은 덤입니다—한동안 시험하다 보니 어느 회사가 어떤 작업에 강한지 직접 감을 잡았습니다. 다른 사람의 benchmark 그래프만 볼 필요가 없습니다. 모델 도감 페이지도 이렇게 쌓인 경험으로 만들었습니다.
- 한 provider가 중단돼도 전체가 멈추지는 않습니다—오늘 아침 Codex처럼 계정이 잠기면 검증은 한 모델에 의존하게 되지만, Claude Code와 LiteLLM의 두 경로는 계속 작동합니다.
대가도 세 가지입니다. daemon 두 개를 더 유지해야 하고, provider마다 특성을 직접 파악해야 하며, 어떤 작업에 어떤 model을 쓸지도 스스로 결정해야 합니다.
- CCR과 LiteLLM이라는 daemon 두 개를 더 유지해야 합니다. CCR은 업그레이드하면서 transformer schema를 바꾼 적이 있고, LiteLLM 1.55+는 spend tracking 필드를 바꿨습니다. 그때마다 다시 반나절씩 debug해야 했습니다.
- provider마다 특성을 직접 파악해야 합니다—Moonshot은 가끔 지연 시간이 급증하고, DashScope는 가끔 5xx를 반환하며, xAI는 응답 형식이 몇 차례 바뀐 적이 있습니다. fallback chain을 제대로 설정하지 않으면 이런 문제를 겪게 됩니다.
- “어떤 task에 어떤 model을 돌릴지”는 아무도 대신 결정해 주지 않습니다—생각할 것이 한 층 더 늘어납니다. 경험에 의존하거나 모델 도감 같은 보조 도구를 써야 합니다.
따라서 이 방식이 맞는 사람은20x 구독으로는 정말 부족하고, 주말 하루이틀을 들여 아키텍처를 구축할 의향이 있는사람입니다. 20x만으로도 충분하거나 로컬 daemon 두 개를 더 운영하고 싶지 않다면 그대로 두는 편이 가장 편합니다. 이 방식은 얻는 것보다 치르는 대가가 더 큽니다.
제가 계속 쓰는 이유는 한마디로 이렇습니다. “같은 작업을 다른 model에 맡기면 어떻게 될까”라는 호기심이 아직 사라지지 않았고, 역할을 나누니 실제로 할당량도 덜 소모됩니다. 할당량이 다 떨어졌을 때 구독 업그레이드를 고민하기보다 어느 단계에서 많이 쓰는지 생각하게 됩니다. 이렇게 “자원 제약 때문에 생각하게 되는” 점이 오히려 가장 마음에 듭니다.
이 작업은 어느 단계에 맡길까
위의 CCR Router 에는 칸이 네 개뿐이지만 실제 작업은 네 가지보다 다양합니다.지금 하려는 작업의 특징을 체크하면 이 글의 “계획 / worker / 검증” 정의에 따라 단계를 한 번 판별하고 해당 단계에 관해 이 글에 적힌 원문 문장을 보여 줍니다. 단계와 Router의 네 칸은 서로 다른 기준입니다. 이 글의 config.json 어느 칸에 대응하면 그 칸의 model을 보여 주고, 대응하지 않으면 찾을 수 없다고 표시합니다. 이 글에서는 계획과 검증을 모두 Claude Code 쪽에 남겨 두므로 Router 네 칸에는 해당 위치가 없습니다. 전부 브라우저 안에서 실행되고, API key를 입력할 필요가 없으며, 어떤 데이터도 외부로 전송되지 않습니다.
상수의 출처는 모두 이 글에 있습니다. 세 단계의 정의는 “3단계 역할 분담” 절의 카드 세 장에서 그대로 가져왔고, Router의 네 칸과 longContextThreshold: 60000 은 이 글에 실린 CCR config.json에서 가져왔으며 명령 형식은 이 글의 cc-llm zsh function에서 가져왔습니다.“배치 수 ≥ 2일 때만 비용 절감 문구를 표시”하는 것은 제가 정한 표시 기준이지 이 글에 나온 수치가 아닙니다—이 글에는 60000 외에 두 번째 수치 기준이 없습니다. model 이름은 이 글의 2026-05 표기이며 여기서 제안하는 권장값이 아닙니다.
어느 단계에서 할당량을 쓰는지 먼저 계산하기
3단계 역할 분담의 가치는 “절약”보다 “적재적소”에 있습니다. 가장 비싼 model에는 그 model이 꼭 맡아야 할 일만 시키는 것입니다. 도입하기 전에 AI에 먼저 계산을 부탁하세요. 할당량이 실제로 어느 단계에서 소모되는지 확인해야 합니다.
자신의 워크플로와 할당량 상태를 AI에 붙여 넣고, 세 단계로 나눌 가치가 있는지와 어떻게 점진적으로 전환할지 판단해 달라고 하세요.
더 읽을거리
이 워크플로를 만들 때 실제로 참고했고 설계 결정에도 영향을 준 자료입니다.
| 자료 | 중요한 이유 |
|---|---|
| claude-code-router | Anthropic ↔ OpenAI protocol transformer입니다. 이것이 없으면 Claude Code를 LiteLLM에 연결할 수 없으므로 전체 라우팅의 핵심 중간 계층입니다. |
| LiteLLM | 여러 provider를 위한 통합 게이트웨이입니다. 이 글에서 설명하는 전체 아키텍처의 핵심입니다. |
| cc-switch | 시험했지만 포기한 방식입니다. README를 보면 왜 “여러 model을 동시에 병렬 실행”할 수 없는지 알 수 있습니다. 설계 전제가 “컴퓨터 전체에서 한 번에 provider 하나”이기 때문입니다. |
| koc.com.tw의 각종 AI API 중개 서비스 비교 | 중개 서비스 방식을 소개하는 입문용 글입니다. 이 글을 읽고 중개 서비스를 쓰지 않기로 했습니다. |
| How to Test AI-Generated Code the Right Way in 2026 | “테스트 6대 원칙”의 첫 씨앗입니다. “100% coverage / 4% mutation score”라는 대비를 이해한 뒤로는 AI가 작성한 테스트를 더는 맹신하지 않습니다. |
| Salesforce VIBEPASS | benchmark에 따르면 최전선 LLM이 자기 코드의 숨은 bug를 찾는 성공률은 50% 미만입니다. “검증 단계를 작은 모델에 맡기지 않는다”는 판단의 가장 강한 근거입니다. |
| tmux: 범용 상태 표시줄부터 분할 화면, 원격 연결, 여러 agent의 역할 분담까지 | 이 글의 “tmux 네 칸에서 서로 다른 model 병렬 실행” 스크린샷 뒤에 있는 도구 체계가 어떻게 만들어졌는지 다룹니다. 아직 tmux로 여러 agent CLI를 돌려 보지 않았다면 이 글에서 기본 레이아웃과 상태 표시줄을 설명합니다. |