AI 綁不了 Live2D
結果意外不錯
Live2D 的綁定只能在編輯器裡用滑鼠調,AI agent 插不上手。這次改跟 Opus 5.5 協作,只靠 2D 動畫的底層常識,把一張插畫做成會轉頭、眨眼、說話、跟著鏡頭動的 2D 紙偶。九個步驟各附做法、驗收標準和原因,常見問題照踩坑的類別整理。
一張插畫,九個步驟
想先玩的話,直接跳到文末的「玩玩看」:可以開鏡頭,讓花野跟著你動。
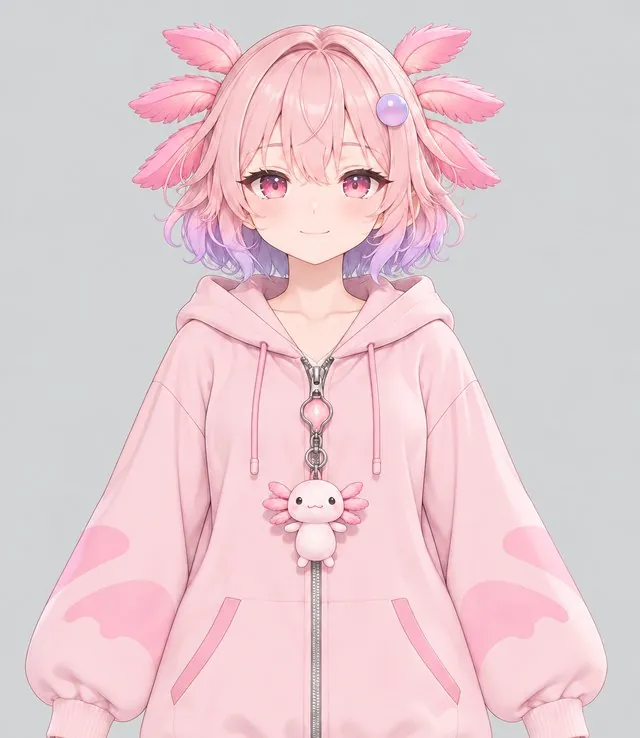
這是六角恐龍少女花野(英文 Kano、日文カノ、韓文카노),名字取自六角恐龍的老家 Xochimilco 湖,納瓦特語的意思是「花田」。她是一隻 2D 紙偶:一張插畫拆成 83 層,會轉頭、眨眼、說話、做 26 個動作,也能跟著鏡頭裡的你動。
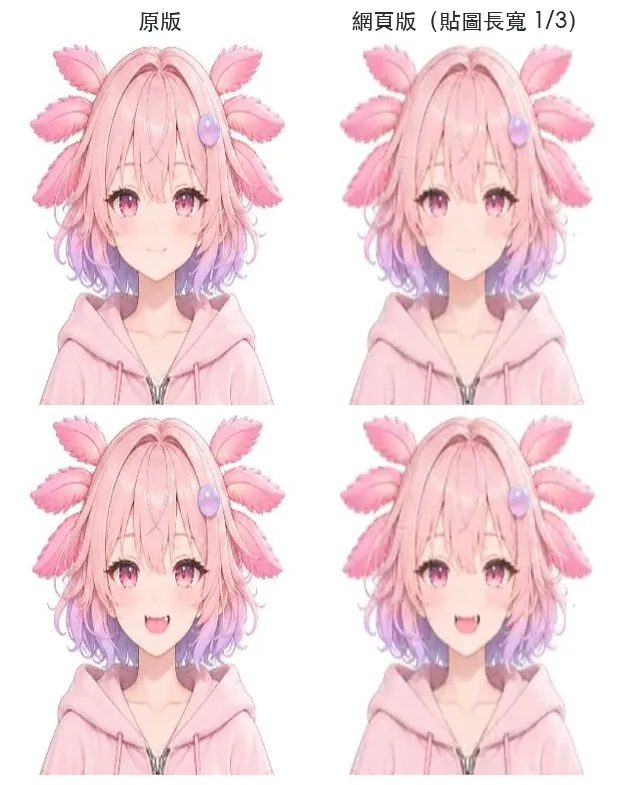
整個專案沒打開 Live2D 編輯器。Live2D 的網格和變形只能在編輯器裡用滑鼠調,官方沒有給程式改網格的介面,AI agent 插不上手;所以這次只靠 2D 動畫的底層常識,把紙偶效果自己還原出來,沒想到成品意外不錯。分工是我看圖拍板,Opus 5.5 寫程式、量數字。2026-10-08 開工,10-14 放上網頁。網頁版刻意把貼圖縮小,近看會比原版糊一點(原因在步驟 9)。
為什麼不用 Live2D 編輯器
Live2D 做的事,拆開來都是圖學的基本功:網格變形、前後層的視差、骨頭、換圖。編輯器把它們包成滑鼠操作,官方給外部程式的介面裡沒有改網格頂點的功能(2026-10 查)。播放模型用的 Cubism Core 倒是程式讀得到,所以步驟 1 能拿官方範例來量。這次把這幾樣用程式一樣一樣寫回來:
| Live2D 的流程裡人手做的 | 這次改成 | 步驟 |
|---|---|---|
| 畫師把插畫畫成分層的 PSD | 改圖補畫被擋住的地方,再用分層模型拆層 | 2、3 |
| 在轉頭的幾個角度,用滑鼠把網格拉成側臉 | 每個頂點帶深度,程式算位移 | 1、4 |
| 手臂掛旋轉變形器 | 三根骨頭彎,大動作換圖 | 5 |
| 在參數的關鍵值上擺好嘴、眉、眼的形狀 | 光流推嘴和眉,眨眼時換眼睛 | 6 |
| 在時間軸上拉動作曲線 | 用程式寫關鍵格 | 7 |
九個步驟一覽
| 步驟 | 做法 | 驗收 | 工具 |
|---|---|---|---|
| 1 量範本 | 量專業紙偶轉頭時各層移多少 | 一張比例表 | Cubism Core |
| 2 補畫 | 被擋住的地方用改圖補 | 縮放差 ≤ 3%、旋轉 ≤ 1.5° | ChatGPT、OpenCV |
| 3 拆層 | 模型拆層,像素換回原圖 | 疊回去差 0.035/255 | See-through |
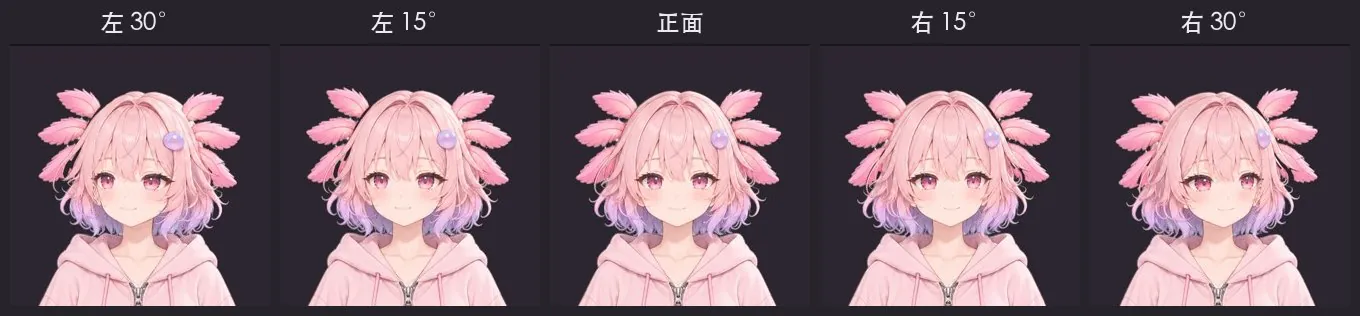
| 4 轉頭 | 只移頂點,不換圖 | 比例對得上範本 | PixiJS |
| 5 手臂 | 小角度彎,大動作換圖 | 換手那格 0 半透明 | ChatGPT |
| 6 表情 | 嘴和眉用推的,眼睛眨眼時換 | 半透明 0 格 | OpenCV 光流 |
| 7 動作 | 照專業節奏自己排關鍵格 | 26 個動作都有動 | — |
| 8 鏡頭 | 臉和上半身分兩條路追 | 真人校準 8 項全對 | MediaPipe |
| 9 上網頁 | 公開版降解析度、擋外連 | 載入 17.5 → 5.4 秒 | Cloudflare Workers |
轉頭是第一個會把前面毛病翻出來的步驟:露出沒畫的地方就退回步驟 2 補畫,出現第二條輪廓就退回步驟 3 重拆。
先量專業範本,把「像不像」變成數字
動手前,先量專業紙偶轉頭時每一層各移多少。
做法
- 用 Live2D 官方的 Cubism Core 載入 12 個人形範例模型,把轉頭參數推到底
- 以臉輪廓的位移當 1,算各層的相對位移,取 12 個的中位數
| 層 | 轉頭時的相對位移(臉輪廓 = 1) |
|---|---|
| 後髮 | 0.06 |
| 耳朵 | 0.49 |
| 前髮 | 1.25 |
| 眼睛 | 1.44 |
| 鼻子 | 2.06 |
驗收
12 個模型方向一致,離鏡頭越近的層移得越多,後髮幾乎不動(2026-10-09 量,只代表官方範例的風格)。
為什麼
靠眼睛只知道「像紙片」,不知道該改哪一層。有了比例表,第四版一量就看出後髮 0.40、耳朵 0.90,前後層次被壓扁了。
一張主圖,被擋住的地方另外畫
正面插畫裡沒有頭髮後面、手臂後面的東西,要另外畫出來。
做法
- 用 ChatGPT 的改圖,以主圖為底,一張只改一件事
- 改好的圖用 ECC(一種影像對位方法)對齊回主圖,對位時只看沒改的地方
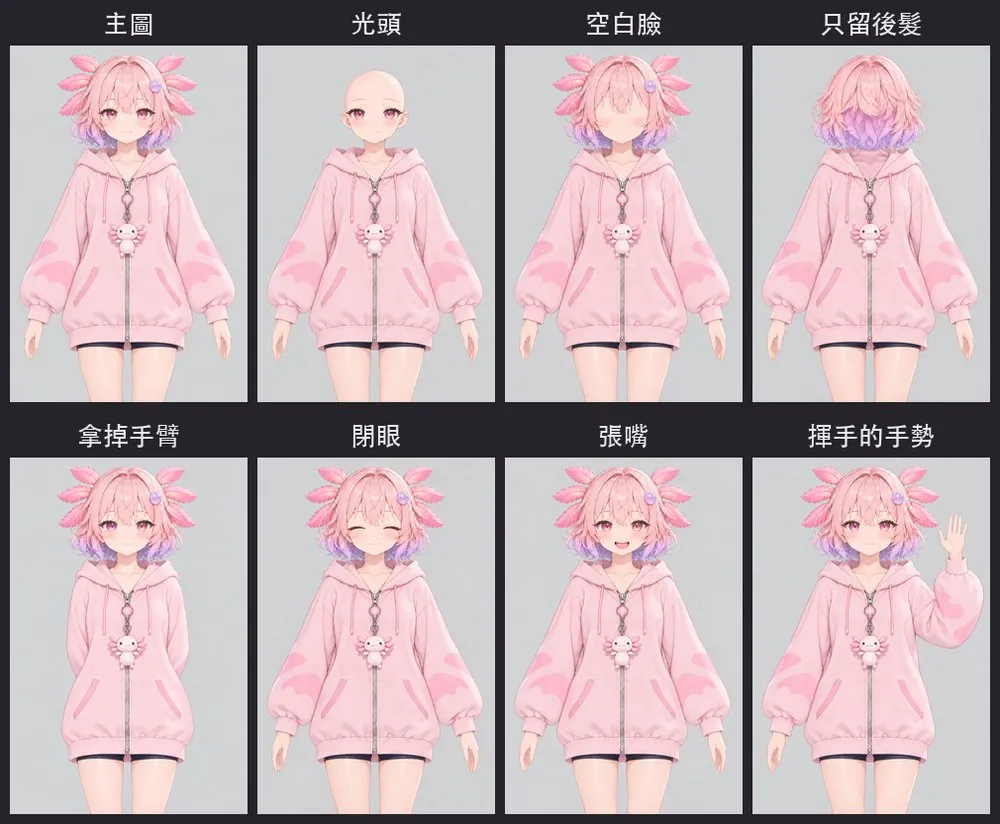
| 改圖 | 補什麼 |
|---|---|
| 光頭 | 頭型、耳朵、脖子 |
| 空白臉 | 五官底下的臉皮 |
| 只留後髮 | 前髮擋住的頭髮 |
| 拿掉手臂 | 手臂擋住的衣服 |
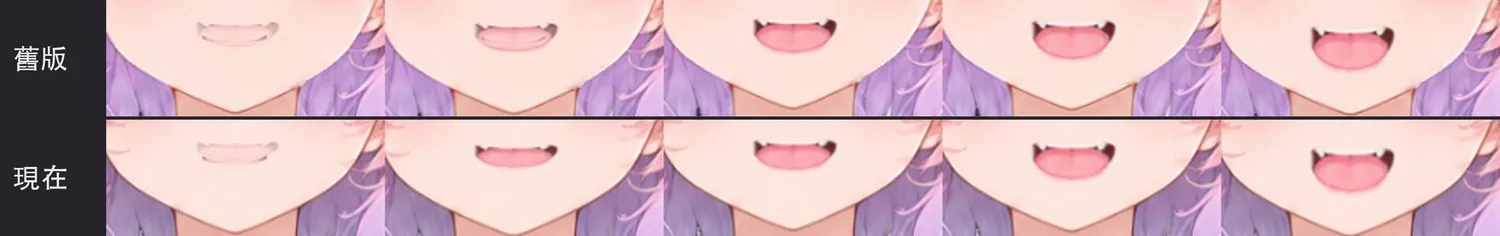
| 閉眼、張嘴 | 眼皮、口腔 |
| 揮手等 6 組手勢 | 大動作的手臂(步驟 5) |
驗收
對齊後縮放差 3% 以內、旋轉 1.5° 以內,沒改的地方平均色差低於 12/255;超過就重生一張。
為什麼
第二版想用數學曲面從正面圖推出側面,推不出新的資訊,轉頭時就像一張紙在轉。
拆層之後,看得到的地方換回原圖像素
拆層交給模型,顏色只認原圖。
做法
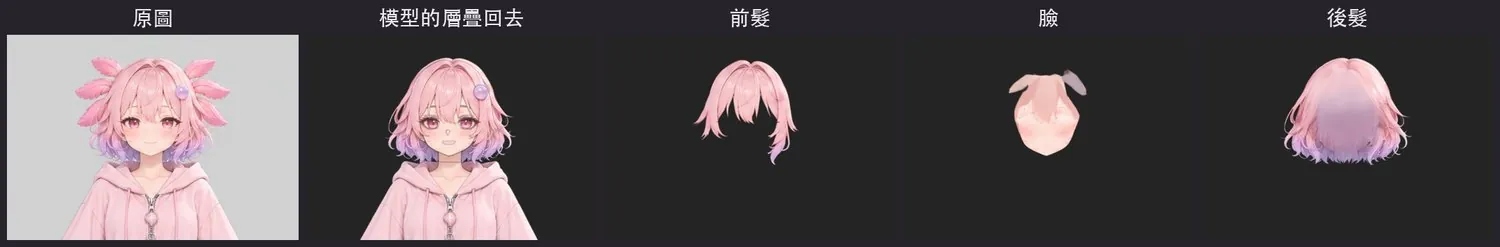
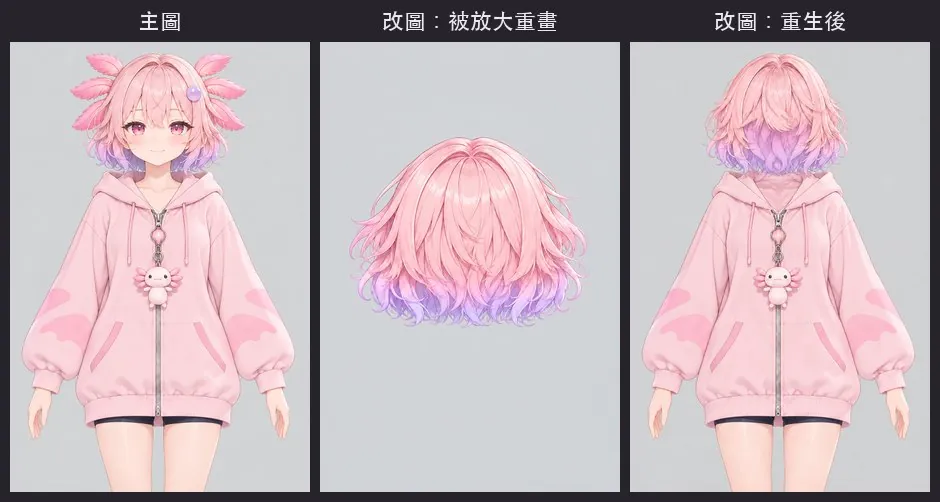
- 主圖和步驟 2 的改圖送進分層模型(這次用 2026 年 2 月發表的 See-through),拆出頭髮、臉、五官、衣服等層
- 每一層看得到的區域,像素一律貼回原圖;同一個像素只給最上面那一層
- 分類裡沒有的部位(花野的鰓),從原圖沒被任何一層蓋到的部分切出來
- 清掉每層畫布上不透明度低於 0.06 的雜訊
驗收
所有層疊回去,跟原圖平均差 0.035/255,漏洞 0 個像素。
為什麼
分層模型的每一層都是重畫的(上圖左二)。五官的半透明邊緣如果也貼給下面的臉皮,轉頭時臉上會留下第二條輪廓。
手臂小角度彎,大動作換一張圖
垂著的手只在幾十度內彎,舉手這種大動作另外畫一張圖換上去。
做法
- 垂著的手用肩、肘、腕三根骨頭彎,關節附近的網格加密
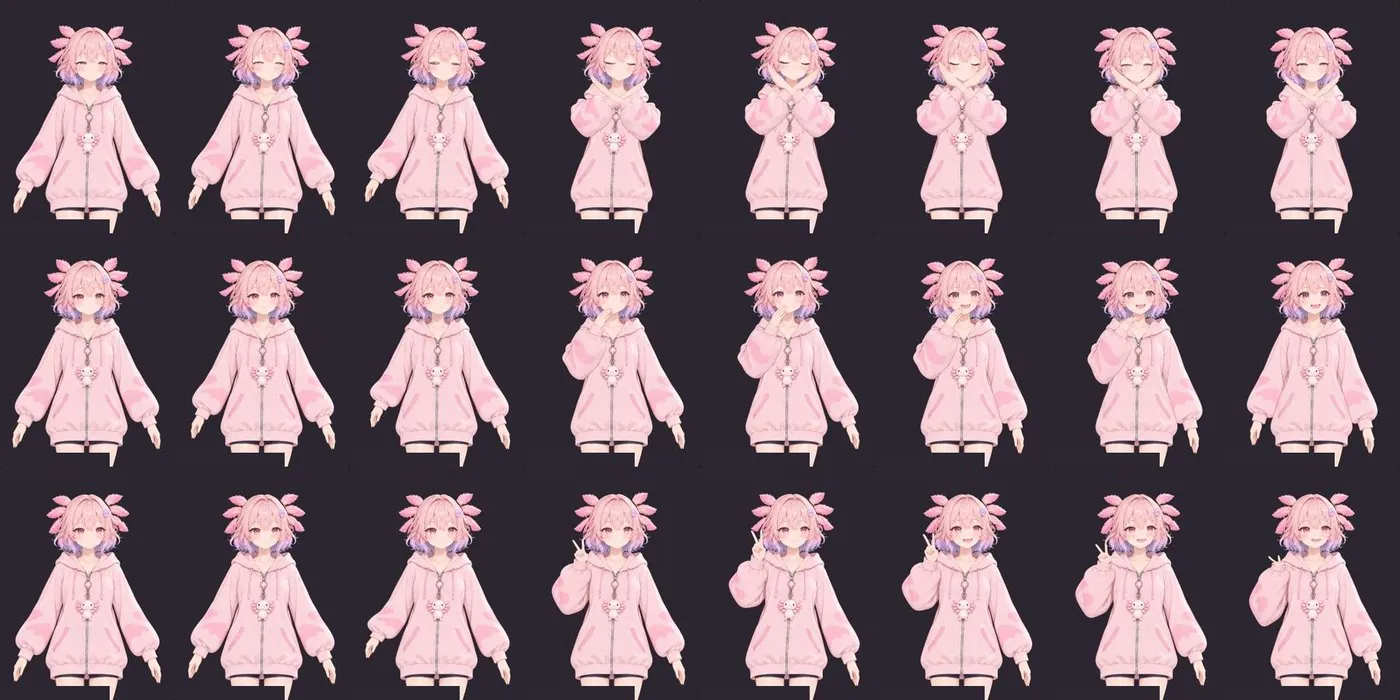
- 舉手、遮臉、叉腰這類姿勢,各用步驟 2 的方法改一張圖,花野共 6 組
- 換圖不淡入:手先往姿勢的方向甩,甩到中途一格直接換掉,再讓新的手彈一下定位
- 舉手時上臂縮成 0.55 倍,手肘的支點跟著往上移
驗收
每秒 30 格逐格看,換手那一格前後沒有半透明的手。
為什麼
正面畫的手臂在畫面上轉 100° 以上,看起來一定像紙板;交叉淡化就算只有 0.03 秒,每秒 30 格也幾乎一定拍到半透明那一格。
表情用推的,眼睛在眨眼那一格換
換表情不淡入淡出:嘴和眉毛用光流推過去,眼睛藏在眨眼那一格換。
做法
- 生成 11 張只改表情的臉,用步驟 2 的門檻對齊回主圖
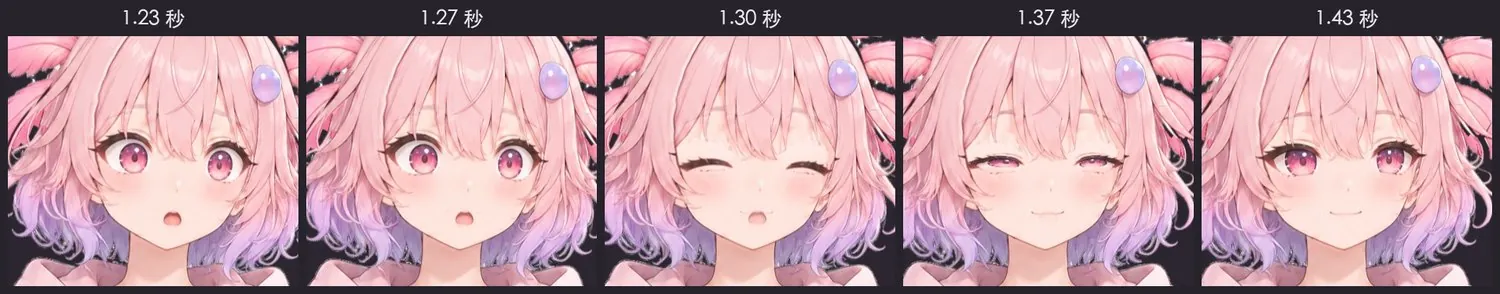
- 用光流(算出兩張圖之間每個像素怎麼移動)把原本的臉推成新表情
- 眼睛不推:強制眨一次眼,在眼睛閉上的那一格,臉和眼睛一起換掉。11 個表情裡 9 個走這條路
驗收
每秒 30 格逐格檢查這 9 個表情:半透明 0 格,臉和眼睛在同一格換,換的那一格眼睛閉合 99% 以上。
為什麼
淡入淡出會看到兩張臉疊在一起。光流推得動嘴型和眉毛,推不出原本不存在的東西;眨眼剛好把換眼睛藏起來,而且本來就會發生。
動作照專業作品的節奏自己排
動作的好壞在節奏:節奏從專業作品看,關鍵格自己排。
做法
- 看官方範例的動作,歸納共通的節奏,不取任何一條曲線
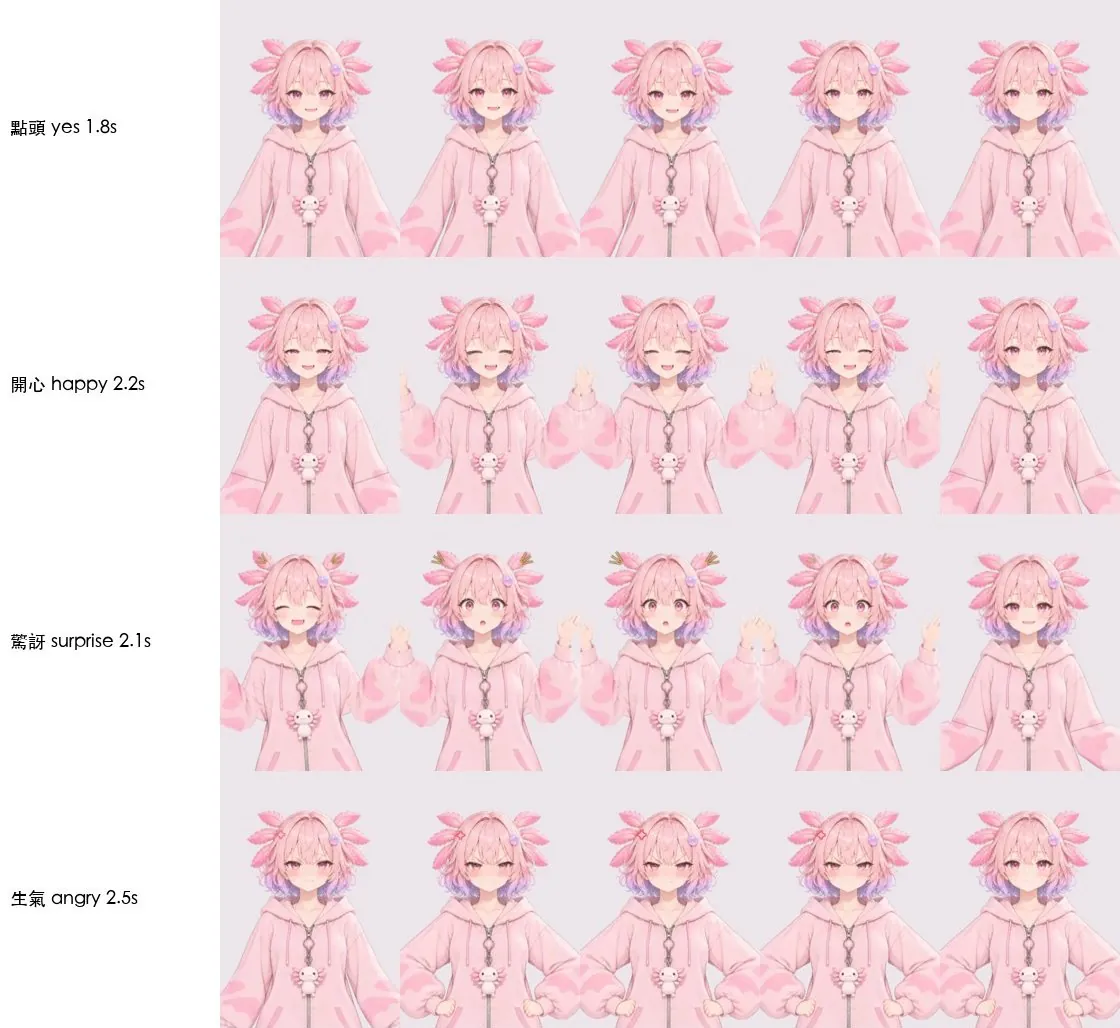
- 每個動作自己排關鍵格:頭、身體、視線、鰓、表情、手勢各一條時間軸
- 開心類照「蓄力 → 彈起 → 定住 → 頭髮跟著晃」四拍排,情緒交給表情
- 動作需要的表情和手勢,套用步驟 5、6 做好的那幾組
驗收
26 個動作各在播到 1/4、1/2、3/4 時取樣,參數都有動,頁面錯誤 0 個。自己排的 23 個跟舊曲線逐條比對,85 條同名曲線沒有一條原封不動。
為什麼
第一版的歡呼憑感覺排,被整個退件;看了官方 290 個動作,才發現開心類都有固定的四拍。一開始直接套官方曲線,查授權才發現不行,只好全部重排。
接鏡頭,臉和上半身分兩條路
臉和身體各走各的,一條追丟了,另一條照樣動。
做法
- 在瀏覽器裡跑兩個追蹤模型:一個看臉,一個看身體
- 兩條路各自置中、各自平滑:開頭靜止一秒的姿勢當正面,之後量的是跟正面差多少
- 方向照鏡子:你往左,花野在畫面上也往左
- 手臂小幅度擺動直接跟;舉手要舉過門檻、停一下,才換成步驟 5 的姿勢圖
| 部位 | 做法 | 原因 |
|---|---|---|
| 頭的角度、眨眼、嘴、眉 | 追(臉部模型) | — |
| 耳、肩、肘、腕,左右各一 | 追(身體模型,8 點) | — |
| 手臂的前後深度 | 只取一半 | 舉直的前臂會被判成指向鏡頭 |
| 側彎、扭轉 | 上限 ±5°、±12° | 紙偶轉不了更多 |
| 髖、腿 | 不追 | 筆電鏡頭拍不到,點會亂飄 |
| 手指 | 不追 | — |
驗收
真人校準 8 項方向全對(聳肩、左右側彎、左右轉肩、舉左手、舉右手、兩手平舉)。另外用陽菜的 3D 模型拍一支已知動作的測試影片,逐段比對 2D 和 3D。
為什麼
側臉時臉部模型會追丟,身體如果跟臉綁在同一條路上,手也會跟著停。
放上網頁
放上網頁要先解決三件事:原版不能直接給出去、載入太慢,還有一個會偷偷連外的函式庫。
做法
- 公開版另外做三層保護:每層貼圖的長寬縮到原版的三分之一、網格放粗,原版留在自己的電腦裡;素材加密後切塊傳送;每層藏了看不見的浮水印和簽名
- 載入時先放一張預覽圖,紙偶畫好才換下來
- 貼圖改用無損 WebP
- 追蹤用的函式庫每 60 秒會把用量統計送到外部,而且沒有開關,在頁面裡直接回應掉
| 原版 | 公開版 | |
|---|---|---|
| 頂點 | 15,495 | 8,254 |
| 貼圖 | 3.0 MB | 205 KB |
| 臉那一層 | 281×316 px | 93×104 px |
驗收
- 限速 20 Mbps 時,完整版載入從 17.5 秒降到 5.4 秒(2026-10-12 量)
- 開鏡頭跑 75 秒,對外請求 0 筆
- 換成公開版後,42 個固定姿勢跟原版比,輪廓重疊最低 0.986(2026-10-14 量)
為什麼
網頁上能動的紙偶,檔案終究會到讀者的電腦,三層保護只能提高門檻,代價是近看比較糊。有損壓縮在圖層邊緣差到 12~21/255,所以用無損;用量統計雖然只有 89 bytes、沒有影像,「影像不離開瀏覽器」要成立就一筆都不能送。
踩過的坑
做的過程遇到的問題,大多落在下面七類。每類只寫會看到什麼、怎麼防。
用淡入、換圖去做該「移動」的事
會看到:雙影、半透明的那一格、兩條嘴線。
怎麼防:能移頂點就移;非換圖不可,就藏在眨眼或甩手的那一格(步驟 4–6)。
AI 改圖、拆層會順手重畫
會看到:沒要改的地方被改了、拆出來的層顏色跟原圖不同、多出一雙手、層的周圍有一層淡霧。
怎麼防:一張只改一件事,用對齊門檻擋掉位移和縮放,畫錯內容的要人看圖;像素一律用原圖(步驟 2、3)。
憑感覺調、只修症狀
會看到:只知道「不像」,不知道該改哪一層;同一個毛病修了三輪還在,例如脖子越轉越長。
怎麼防:先量專業範本,把「像不像」變成數字;同一處修兩輪還在,就回頭換做法本身,例如平移換成旋轉(步驟 1、4)。
追蹤模型的盲區
會看到:側臉時手也停了、畫面外的點亂飄、舉直的手被當成指向鏡頭、只是側彎紙偶卻跟著轉身。
怎麼防:臉和身體分兩條路;只追鏡頭拍得到的點;不穩的深度打折;做不到的限制直接寫出來(步驟 8)。
拿比例表對照你的角色
比例表、被擋處清單、鏡頭的 8 個點:這三樣最容易拿去對照自己的角色。
把下面這段貼給你的 AI,讓它對照你手上的 2D 角色。
延伸閱讀
| 資源 | 為什麼重要 |
|---|---|
| 陽菜那篇:從一張設計圖到 3D | 3D 版的同一套「做法/驗收/為什麼」。步驟 8 的測試影片,就是用她的模型拍的 |
| See-through: Single-image Layer Decomposition for Anime Characters | 步驟 3 用的分層模型。它拆出來的層是重畫過的,步驟 3 才要把看得到的像素換回原圖 |
| Live2D 官方範例模型 | 步驟 1 比例表的來源。12 個一起量,才看得出「離鏡頭越近移得越多」是通則,不是某一個綁定師的習慣 |